Tu web está publicada, pero no aparece en Google: cómo encontrar la causa
Neaptide · 7 de septiembre de 2026 · 9 min de lectura · Actualizado: 3 de octubre de 2026
Comprueba la indexación en Google: estados de Search Console, noindex, robots.txt y URL canónica. Con un ejemplo y una ficha para enviar al desarrollador.
En este artículo
Tu web nueva carga, los enlaces funcionan y tus conocidos ya la han abierto. Buscas en Google el nombre de la empresa o del servicio y no sale. Antes de reescribir todas las páginas o de pagar una «indexación exprés», averigua qué pasa con una URL concreta.
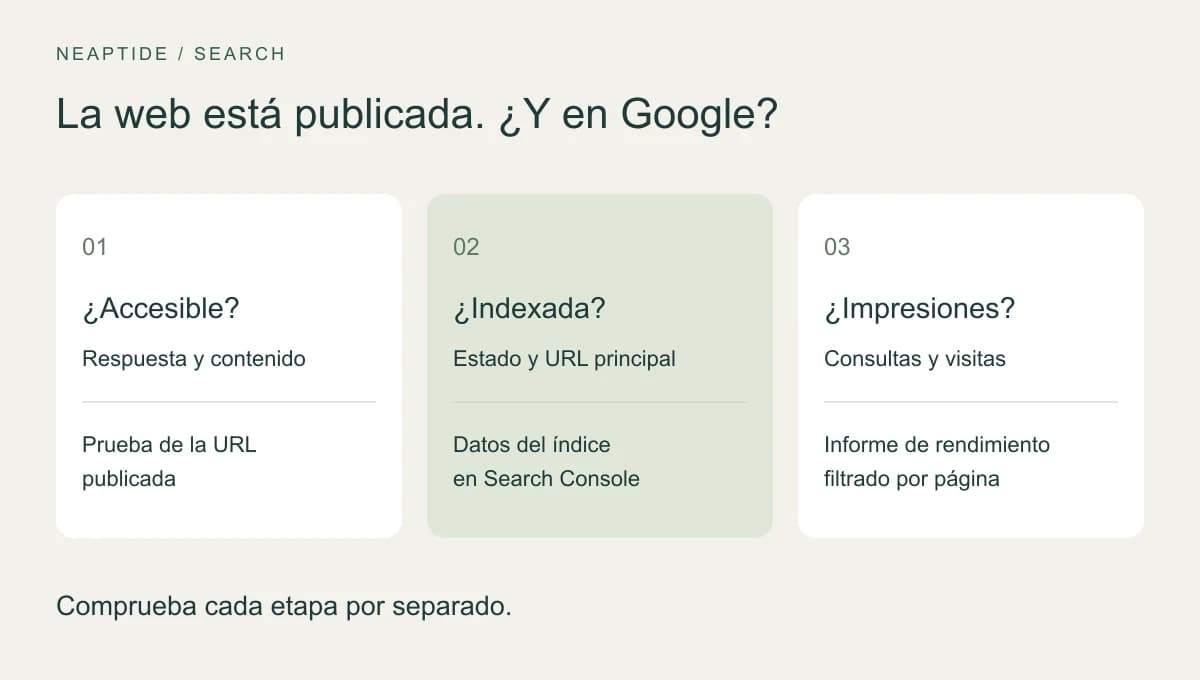
Empieza por la inspección de URLs de Google Search Console. Si la página no está indexada, averigua si Google conoce la dirección, si puede abrirla y qué motivo indica el informe. Si ya está indexada, analiza las impresiones y las consultas. Una web que funciona, una página indexada y las visitas desde Google son tres resultados distintos.
Elige una página y su dirección exacta
Selecciona una página que deba atraer clientes: la portada o un servicio concreto. Copia la dirección final, la que queda en el navegador después de las redirecciones. Con o sin www, http o https, otro idioma, un parámetro de más: para Google pueden ser URLs distintas. Comprobar la portada no explica qué ocurre con una página de servicio.
- En Search Console, abre la propiedad verificada de la web y pega la URL completa en la barra de inspección.
- Anota el estado, la fecha del último rastreo y la URL canónica elegida por Google, que es la versión que toma como principal entre los duplicados.
- Si has tocado la página después de ese rastreo, prueba la URL publicada y compara la respuesta de ahora con lo que Google tiene guardado.
La prueba en tiempo real comprueba si Google puede obtener y procesar la página en ese momento. No significa que la versión actual esté indexada ni permite predecir la URL canónica. Sin acceso a Search Console puedes revisar igualmente la respuesta pública del servidor y el HTML, pero los datos de indexación tendrás que pedírselos a quien administra la propiedad verificada.
La búsqueda site:example.com vale para orientarse al principio. No es un inventario completo: el número de resultados no mide el índice con precisión, y que una dirección no aparezca ahí no basta para diagnosticar nada.
Lee el estado antes de elegir una solución
| Estado | Qué sabemos | Qué comprobar |
|---|---|---|
| Google no conoce la URL | La dirección aún no se ha descubierto | Un enlace desde una sección de la web y la URL correcta en el sitemap |
| Descubierta: actualmente sin indexar | Google conoce la URL, pero todavía no la ha rastreado | Disponibilidad del servidor, enlaces internos y estadísticas de rastreo si afecta a muchas páginas |
| Rastreada: actualmente sin indexar | Se ha rastreado, pero no está indexada | Contenido, páginas parecidas y selección canónica |
| Excluida por noindex / bloqueada por robots.txt | Se ha detectado una restricción | Si debe indexarse y dónde se establece la regla |
| Página duplicada o alternativa | Se utiliza otra versión | Si la URL principal es la adecuada y está indexada |
«Descubierta: actualmente sin indexar» no dice nada sobre la calidad del texto, porque Google aún no ha rastreado la página. Y excluir un duplicado, una página de acceso o un ejercicio privado suele ser lo correcto. Vigila las páginas públicas que importan. No hace falta dejar a cero todas las exclusiones del informe.
Ejemplo: la página funciona, pero la plantilla conserva noindex
Imagina una escuela de cerámica que acaba de publicar su web. La página de clases es pública, responde con HTTP 200 y figura en el sitemap. Pero la plantilla de pruebas de la que salió conserva noindex. El fragmento es un ejemplo didáctico y no procede de la auditoría de ningún cliente.
HTTP/2 200
Content-Type: text/html

<head>
  <meta name="robots" content="noindex, nofollow">
  <link rel="canonical" href="https://example.com/workshops">
</head>
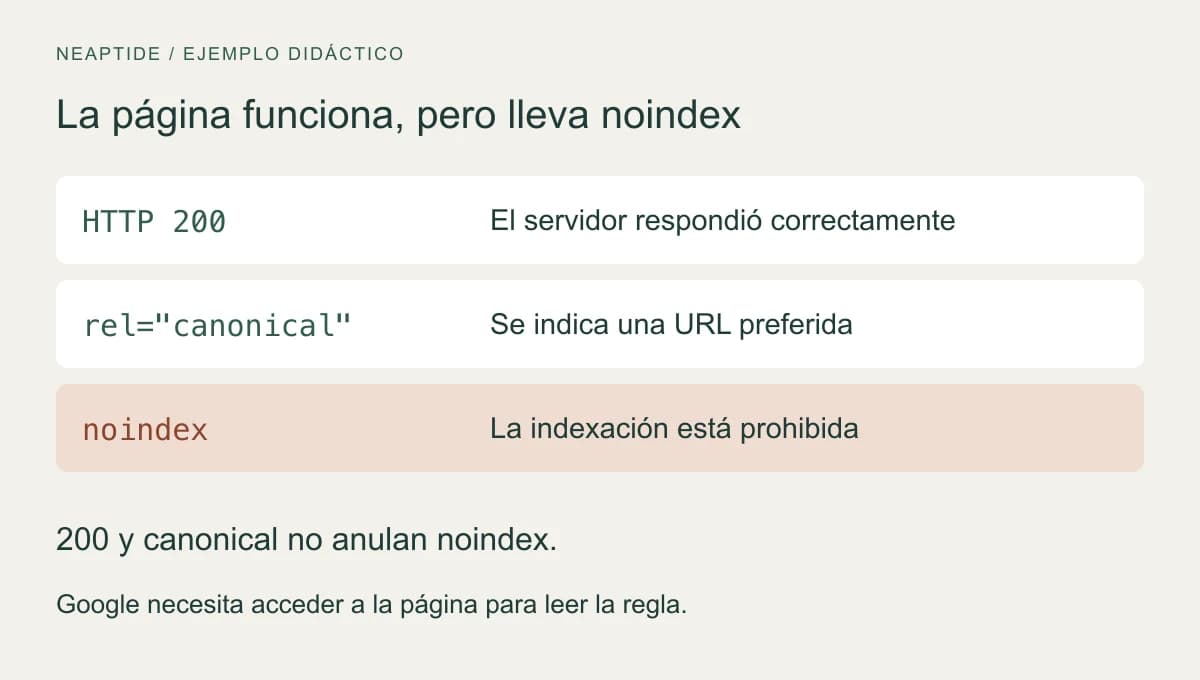
El código 200 significa que el servidor ha respondido correctamente. La etiqueta canonical señala la dirección preferida. Ninguno de los dos anula noindex: en cuanto Google lee esa regla, saca la página de los resultados. No te quedes en el HTML, porque la misma restricción puede llegar en la cabecera HTTP X-Robots-Tag.
- Localiza de dónde sale noindex. Puede ser un ajuste del CMS, la plantilla, el servidor o la CDN. Si la página es pública, quita ahí la restricción accidental.
- Revisa lo que devuelve la URL publicada: cabeceras, HTML y contenido. Añadir index mientras noindex sigue ahí no arregla nada.
- Repite la prueba de la URL publicada en Search Console. Cuando la restricción haya desaparecido, ya puedes solicitar la indexación.
No bloquees la página en robots.txt para esconderle el noindex a Google. Robots.txt controla el rastreo, y Google tiene que acceder a la página para leer la regla corregida. Las áreas privadas y las páginas de uso interno que están restringidas a propósito se quedan como están.
Sin restricciones: revisa el contenido y los duplicados
En la inspección de URLs, mira la página tal como Google la ha renderizado. Deben verse el nombre del servicio, sus condiciones y el texto principal. Google ejecuta JavaScript, así que usar React u otro framework no explica nada por sí solo. Busca un fallo concreto: un bloque de contenido vacío, una petición de datos que falla, un recurso que no carga.
Compara la URL canónica que declara la página con la que ha elegido Google. A veces un error en la plantilla de servicios hace que todas las páginas declaren la portada como canónica. Si es tu caso, corrige la plantilla. Cuando se trate de duplicados de verdad, usa la versión preferida en todas partes: enlaces internos, sitemap y etiqueta canonical. La declaración solo expresa una preferencia, de modo que conviene mirar también qué versión ha elegido Google.
Si no aparece ninguna causa técnica, lee la página como la leería un cliente. Tres páginas tituladas «clases de cerámica», «curso de alfarería» y «taller de cerámica», con las mismas condiciones, difícilmente cubren tres necesidades distintas. Antes de fusionarlas, compara su función, su contenido y sus datos de búsqueda. Si de verdad son formatos diferentes, cuenta en qué: duración, materiales, nivel, piezas que se hacen.
Mil palabras más para hacer bulto no ayudan a nadie a elegir. El horario, las condiciones de cancelación, ejemplos reales de piezas terminadas y una respuesta clara sobre si hace falta experiencia son mucho más útiles. La página mejora con ello, aunque eso no garantiza que Google la indexe.
Páginas de Next.js sin indexar: qué revisar antes de tocar el código
En una web de Next.js, empieza por las mismas pruebas de una URL concreta. El nombre del framework o la presencia de Client Components no diagnostican un problema de indexación. Revisa la respuesta real y el contenido de la página; después sigue el problema observado hasta la ruta, el layout compartido o la configuración de metadatos.
| Síntoma | Pruebas que recopilar | Siguiente comprobación |
|---|---|---|
| Una ruta no aparece en búsqueda | Estado en Search Console, fecha del último rastreo y respuesta HTTP actual. | Comparar el informe de la versión indexada con la página publicada. Una respuesta 200 por sí sola no confirma la indexación. |
| La página se ve completa en el navegador | Contenido principal y enlaces en el HTML de respuesta y, después, en el DOM renderizado. | Si falta contenido importante o hay diferencias, revisar la obtención de datos y el renderizado. Google puede renderizar JavaScript; hay que identificar el contenido o recurso que falta. |
| Varias páginas comparten un título o una canónica incorrectos | Metadatos devueltos por varias rutas que usan la misma plantilla. | Revisar el layout, los metadatos de cada página y la construcción de URL. Verificar la respuesta publicada después de cualquier cambio. |
| Google no ha descubierto un nuevo servicio o artículo | Enlaces internos, sitemap y respuesta de la URL real. | Comprobar que la navegación usa href accesibles y que el sitemap incluye la URL pública prevista. Enviar un sitemap no garantiza la indexación. |
| Una página traducida apunta a otro idioma | Canónica y enlaces alternativos en ambas versiones por idioma. | Comprobar las URL equivalentes previstas y los enlaces de vuelta. La orientación por idioma y la elección de la canónica son decisiones distintas. |
Una comprobación real de nuestra web muestra hasta dónde llegan las pruebas públicas. El 3 de octubre de 2026, las seis versiones por idioma de la página del servicio GEO devolvieron 200, sus propias URL canónicas, alternativas de idioma coherentes y entradas en el sitemap. Sus encabezados estaban en el HTML inicial. Pudimos confirmar esos controles sin Search Console; no pudimos deducir que Google hubiera indexado cada página.
Valores seleccionados observados en nuestra web — 3 de octubre de 2026

GET https://www.neaptide.ai/en/services/geo
Estado: 200
Canónica: https://www.neaptide.ai/en/services/geo
H1: GEO services, with a clear scope and budget.
Alternativas: en, ru, fr, es, it, zh, x-default
Entrada en el sitemap: presente

Canónica elegida por Google / estado de indexación: no comprobadosSi hay que cambiar los metadatos, consulta la documentación de la versión de Next.js instalada. En una web con App Router, revisa tanto los metadatos del layout como los de la página y la URL que generan en la respuesta publicada. Corrige el origen de la incoherencia y repite las comprobaciones de respuesta y página renderizada. Revisa por separado el estado en Google cuando haya procesado la actualización.
- Next.js 15: metadatos y generateMetadata
- Google: conceptos básicos de SEO para JavaScript
- Google: URL canónicas
Cuando estas comprobaciones dejan una duda que tu equipo no puede resolver, una auditoría específica puede convertirla en una tarea reproducible. La página de nuestro servicio para Next.js explica la cobertura, los entregables y el alcance de implementación, que se acuerda aparte.
- Auditoría SEO e implementación para Next.js
- Qué debe entregar una auditoría, con un informe de ejemplo
La página está indexada, pero no recibe visitas
Abre el informe de rendimiento de resultados de búsqueda y filtra por la URL de la página. Comprueba el periodo, el país, el dispositivo y el tipo de búsqueda. Mira qué consultas generan impresiones, es decir, apariciones en los resultados, y cuántos clics aportan. Una búsqueda puntual desde tu móvil no sustituye esos datos.
- Sin impresiones: revisa los filtros y la URL canónica, y después si la página responde a lo que busca tu público. La falta de datos no identifica una única causa.
- Impresiones con pocos clics: mira a la vez la consulta, la posición y cómo se muestra el resultado. Un título impreciso no ayuda a decidirse, y una posición baja también limita las visitas.
- Clics sin contactos: revisa la oferta y el recorrido hasta el formulario. Envía una consulta de prueba y localízala en su destino: el mensaje «Enviado» no basta.
Envía al desarrollador un problema que pueda comprobar
Sustituye «arregla el SEO, no salimos en Google» por una ficha dedicada a una sola página. Anota la URL, la fecha de la revisión, el estado en Search Console y la fecha del último rastreo, la respuesta del servidor y las restricciones de indexación. Añade las dos URLs canónicas, la que declara la web y la que ha elegido Google, y describe el resultado esperado. Adjunta el fragmento HTML o la captura del informe que respalde el diagnóstico.
En el ejemplo, la corrección se da por buena cuando la página de clases es pública, entrega su contenido real con HTTP 200 y ya no lleva el noindex accidental ni en el HTML ni en las cabeceras. Una nueva prueba en tiempo real de Google tampoco detecta la restricción. Anota la fecha del cambio. Con esto queda confirmada la corrección. Que la página esté indexada es otra cosa, y eso todavía no se sabe.
Tras publicar, observa el siguiente rastreo y el estado de la URL. Repetir la solicitud para una misma dirección no acelera el proceso. Google no garantiza la inclusión ni un plazo, así que «indexada en 24 horas» no es un criterio fiable para aceptar el trabajo.
Si la causa sigue sin estar clara, entrega la ficha a quien vaya a auditar la web: tendrá un punto de partida concreto. Una vez resueltos el acceso y la indexación, puedes pasar al contenido y ver si la web responde bien a las preguntas de los clientes, tanto en la búsqueda convencional como en las respuestas de IA.