网站上线了,为什么 Google 还搜不到?从一个网址查起
Neaptide · 2026年9月7日 · 9 分钟阅读 · 更新于: 2026年10月3日
按步骤检查 Google 收录:看懂 Search Console 状态,排查 noindex、robots.txt 和规范网址。附教学示例及可下载的开发任务记录表。
本文目录
新网站能打开,链接正常,发给朋友也都能访问。可在 Google 上搜公司名或服务名,就是找不到。先别急着重写文案,更别急着买“快速收录”服务。挑一个重要的网址,查清楚它到底卡在哪一步。
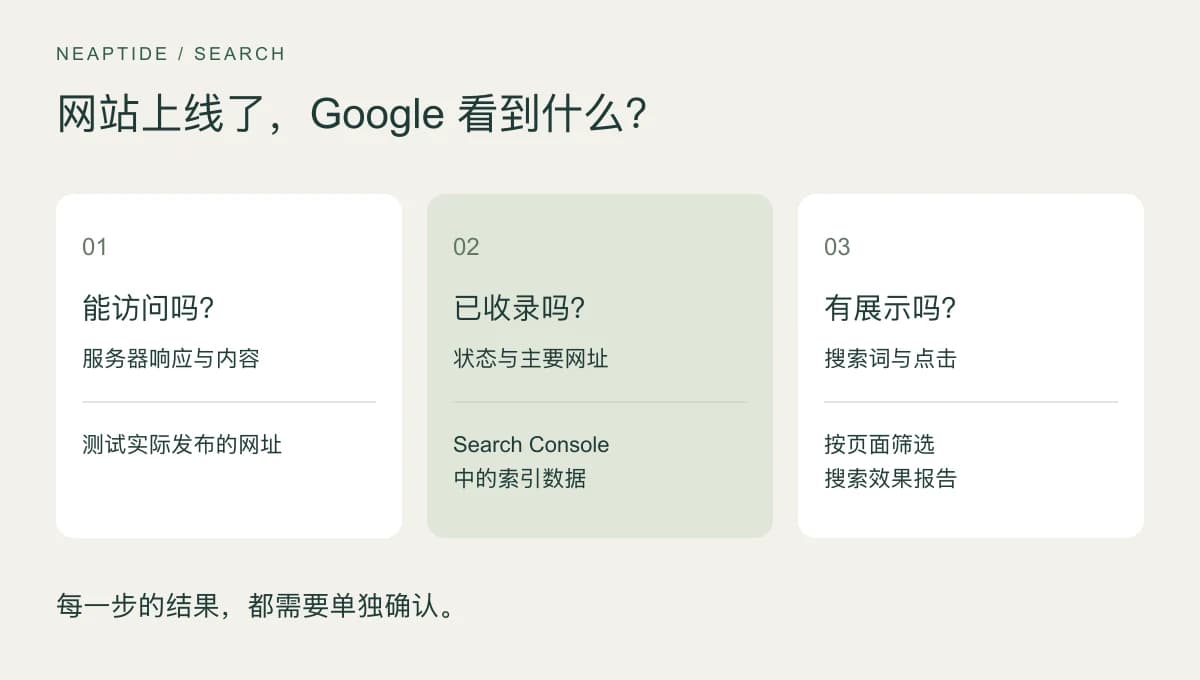
先用 Google Search Console 的网址检查工具确认收录状态。如果没有收录,就查 Google 是否知道这个地址、能否打开页面,以及报告给出的原因;如果已经收录,就看展示次数和搜索词。网站能访问、网页进入索引、有人从搜索结果点击进来,是三个不同的结果。
先选一个页面,核对完整网址
选一个本该带来客户的页面,比如首页或某个服务页。复制跳转结束后浏览器地址栏里的最终地址。带不带 www,是 http 还是 https,换一种语言,多一个参数,在 Google 眼里都可能是不同的网址。另外,首页查出来的结果说明不了服务页的情况。
- 在 Search Console 里打开已验证的网站资源,把完整网址粘贴到网址检查栏。
- 记下三项:状态、上次抓取时间、Google 选择的规范网址(即重复页面中被当作主要版本的那个地址)。
- 如果上次抓取之后改过页面,就测试一下实际发布的网址,把现在的页面和 Google 保存的数据对比着看。
实时测试只回答一个问题:Google 现在能不能获取并处理这个网页。它不说明当前版本已经进入索引,也预测不了 Google 会选哪个规范网址。没有 Search Console 权限的话,公开的服务器响应和 HTML 你自己就能查,具体的收录状态则要请网站资源的所有者提供。
site:example.com 适合先粗略看一眼,但它不是完整的收录清单。结果数量不等于索引的真实规模,搜不到某个网址也不足以下结论。
先读懂状态,再决定改什么
| 看到的状态 | 可以确认什么 | 下一步检查 |
|---|---|---|
| Google 不知道此网址 | 地址尚未被发现 | 站内栏目是否有普通链接,sitemap 中的网址是否正确 |
| 已发现,尚未编入索引 | Google 知道地址,但还没有抓取 | 服务器可用性、内部链接;大批页面受影响时查看抓取统计 |
| 已抓取,尚未编入索引 | 已发生抓取,但尚未收录 | 页面内容、相似页面及规范网址选择 |
| 因 noindex 排除/被 robots.txt 屏蔽 | 发现了具体限制 | 这个页面是否应被收录,规则设在哪里 |
| 重复页面或备用版本 | 采用了其他版本 | 主要版本是否选对,以及它是否被收录 |
“已发现,尚未编入索引”说明不了文章质量:Google 还没有抓取这个页面。反过来,重复页、登录页或不公开的练习页面被排除,往往完全正常。要盯住的是那些应该被找到的公开页面,没有必要把报告里的排除数量清零。
教学示例:网页能打开,模板却留下了 noindex
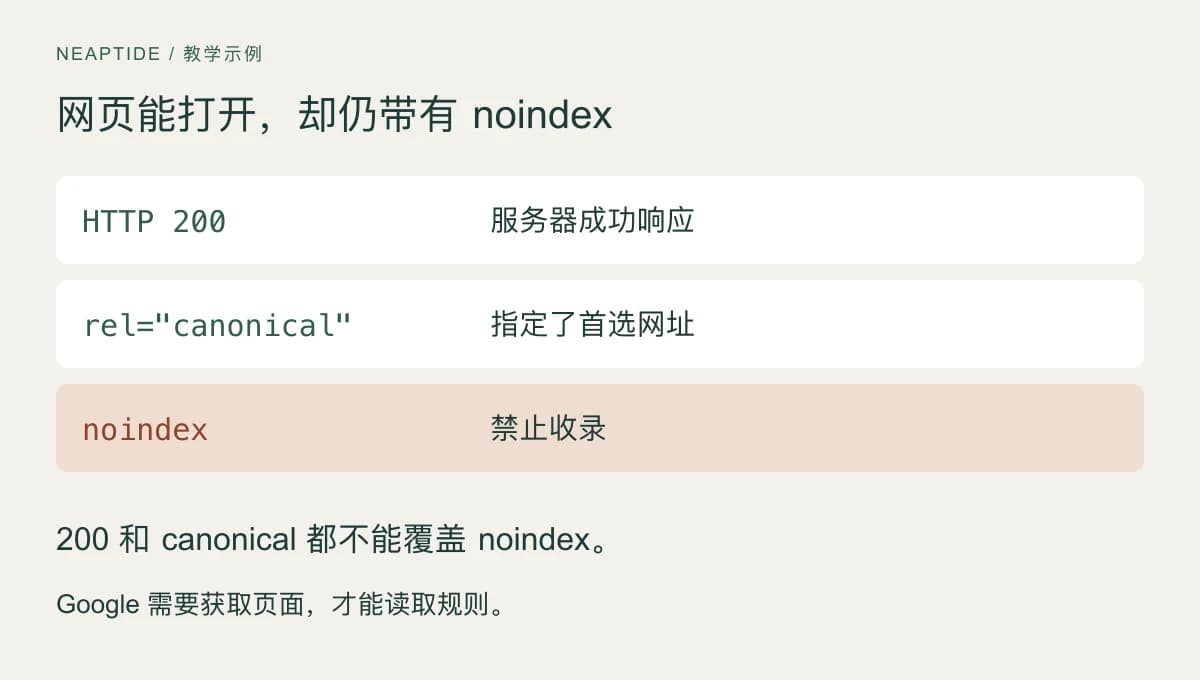
假设一家陶艺工作室的网站刚上线。课程页不用登录就能打开,服务器返回 HTTP 200,sitemap 里的地址也没错。问题在于,测试阶段用的模板里还留着 noindex。下面这段代码是教学示例,并非来自真实客户网站。
HTTP/2 200
Content-Type: text/html

<head>
  <meta name="robots" content="noindex, nofollow">
  <link rel="canonical" href="https://example.com/workshops">
</head>
200 只表示服务器成功响应,canonical 只表示首选地址,两者都盖不过 noindex。Google 一旦读到这条规则,就会把页面排除在搜索结果之外。别只看 HTML:同样的限制也可能藏在 HTTP 响应头 X-Robots-Tag 里。
- 找到 noindex 是从哪儿来的:CMS 设置、页面模板、服务器,还是 CDN。既然这是公开页面,就在源头把误设的限制去掉。
- 检查发布地址实际返回的响应头、HTML 和内容。noindex 还在的时候再加一个 index,解决不了问题。
- 在 Search Console 里重新跑一次实时测试。确认限制已经消失,就可以为这个网址请求编入索引。
别为了不让 Google 看到 noindex 而在 robots.txt 里屏蔽页面。robots.txt 管的是抓取,而 Google 得先访问页面,才读得到改过的索引规则。至于私人区域和内部功能页,本来就该有的限制照旧保留。
没有访问限制,就查内容和重复版本
在网址检查工具中,查看 Google 加载后实际看到的页面,确认服务名称、服务条件和正文都完整显示。Google 会运行 JavaScript,所以网站用了 React 之类的框架,并不能直接解释为什么没有收录。要找出具体故障,例如正文空白、数据请求失败,或关键资源无法加载。
比较页面声明的规范网址与 Google 选择的版本。如果服务页共用的模板里 canonical 设置有误,所有服务页都把首页声明成了主要版本,就要修正这个设置。内容确实重复的页面,则应在内部链接、sitemap 和 canonical 中统一使用首选地址。canonical 表达的只是网站的偏好,Google 最终选了哪个版本,还得在报告里确认。
技术原因找不到,就站在客户的角度把页面读一遍。假如有三个页面,分别叫“陶艺课程”“陶艺教学”“陶艺体验”,条件却一模一样,它们多半并没有对应三种不同的需求。合并之前,先比较各自的用途、内容和搜索数据。课程要是确实不同,就把差别讲清楚:时长、材料、适合什么水平、能做出什么作品。
为了凑篇幅多写一千字,帮不了客户做选择。课表、取消规则、真实作品示例,以及零基础能不能参加,要有用得多。页面会因此更实用,但这并不保证 Google 一定收录。
Next.js 页面未被收录:改代码之前先查什么
Next.js 网站也应从具体网址的证据查起。框架名称或客户端组件的存在,不能用来诊断收录问题。先查看实际响应和页面内容,再把已观察到的问题追溯到路由、共用布局或元数据配置。
| 症状 | 需要收集的证据 | 下一步检查 |
|---|---|---|
| 某个路由在搜索中找不到 | Search Console 状态、上次抓取日期,以及当前 HTTP 响应。 | 将索引报告与实时页面对照。仅返回 200,不能证明页面已收录。 |
| 浏览器中页面看起来完整 | 先看响应 HTML,再看渲染后的 DOM 中的主体内容与链接。 | 如果重要内容不一致,检查数据获取与渲染流程。Google 能渲染 JavaScript;要指出实际缺失的内容或资源。 |
| 不同页面共用了错误标题或 canonical | 多个使用同一模板的路由所返回的元数据。 | 检查布局、页面元数据和网址构造方式。修改后核实线上实际输出。 |
| 新服务页或文章尚未被发现 | 内部链接、站点地图和该网址的实际响应。 | 确认导航使用可访问的 href,站点地图列出预期的公开网址。提交站点地图并不保证收录。 |
| 翻译页指向另一种语言 | 两个语言版本上的 canonical 和 alternate 链接。 | 核对预期的等价页面及返回链接,分别决定语言定位与规范网址。 |
我们对自己网站的一次真实检查,说明了公开证据的边界。2026 年 10 月 3 日,GEO 服务页的六个语言版本均返回 200,canonical 指向自身,语言替代链接相互一致,并在站点地图中有对应记录。它们的主标题都出现在初始 HTML 中。没有 Search Console,我们仍能确认这些检查结果,却不能据此推断 Google 已收录每个页面。
我们自己网站的部分实际观察值——2026 年 10 月 3 日

GET https://www.neaptide.ai/en/services/geo
状态:200
Canonical:https://www.neaptide.ai/en/services/geo
H1:GEO services, with a clear scope and budget.
语言替代版本:en, ru, fr, es, it, zh, x-default
站点地图记录:存在

Google 选择的规范网址/收录状态:未检查如果需要修改元数据,请以已安装 Next.js 版本的文档为准。对于 App Router 网站,同时检查布局和页面的元数据,以及线上响应实际生成的网址。修正不一致的源头后,重新检查响应和渲染结果。Google 处理更新后,再单独核查其报告中的状态。
如果检查后仍有团队无法解决的问题,有针对性的审计可以把它变成可复现的任务。我们的 Next.js 服务页说明了覆盖范围、交付物,以及需要另行约定的实施工作。
已经收录,却没有访客
打开搜索结果效果报告,按页面筛选,然后核对日期范围、国家、设备和搜索类型。先看哪些搜索词带来了展示,再看点击。拿自己的手机搜一次,代替不了这些数据。
- 没有展示:先核对筛选条件和规范网址,再看页面是否对得上目标读者会搜的内容。光是没有数据,说明不了具体原因。
- 有展示,点击少:把搜索词、排名位置和搜索结果的实际样子放在一起看。标题含糊会让人不想点,排名靠后同样限制点击。
- 有点击,没有咨询:检查服务说明和联系流程。自己发一条测试咨询,到接收端确认真的收到了。网页上显示“已发送”不算数。
给开发者一个可以验证的问题
别只说一句“我们在 Google 上搜不到”,为一个具体页面填一份诊断记录。写下完整网址、检查日期、Search Console 状态、上次抓取时间、服务器响应和索引限制。规范网址要写两个:网站声明的版本和 Google 选中的版本,再说明期望的结果。能支持判断的 HTML 片段或报告截图也一并附上。
以陶艺课程页为例,验收条件可以这样写。发布的页面无需登录,返回 HTTP 200 和正确的正文。HTML 和响应头里都不再有误设的 noindex。Google 新一次实时测试也没有再发现这个限制。把修改日期记下来。做到这些,说明问题已经修复,页面是否进入索引则还要再等。
发布之后,继续留意新的抓取时间和网址状态。同一个地址反复提交,抓取不会因此变快。Google 既不保证收录,也不承诺期限,“24 小时内收录”自然不能当作验收标准。
如果原因仍不明确,把这张记录表交给做审查的人,对方就有了具体的起点。访问和收录问题解决之后,再回到内容上,检查网站在传统搜索和 AI 回答中能否完整回答客户的问题。