Votre site est en ligne, mais absent de Google : comment trouver la cause
Neaptide · 7 septembre 2026 · 9 min de lecture · Mis à jour: 3 octobre 2026
Vérifiez l’indexation dans Google : états de Search Console, noindex, robots.txt et URL canonique. Avec un exemple et une fiche à transmettre au développeur.
Dans cet article
Votre nouveau site s’ouvre sans problème, les liens fonctionnent et vos proches l’ont déjà consulté. Tapez pourtant le nom de l’entreprise ou du service dans Google : rien. Avant de réécrire toutes les pages ou de payer une « indexation express », regardez ce qui se passe pour une URL précise.
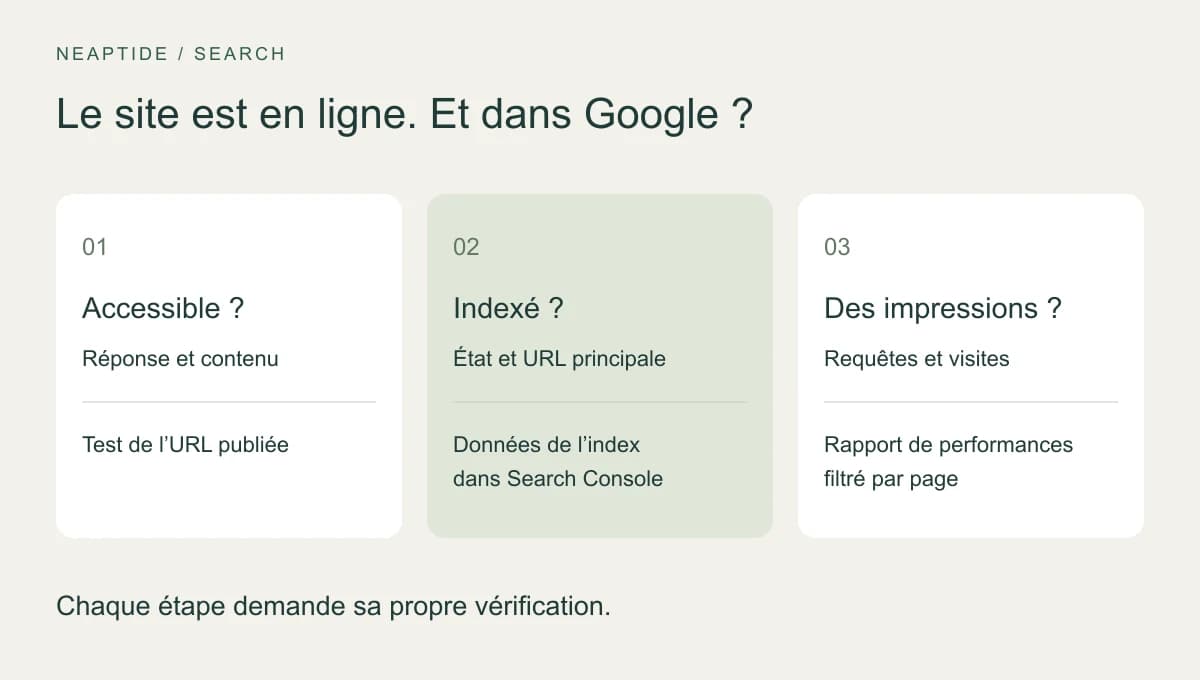
Commencez par l’inspection d’URL dans Google Search Console. Si la page n’est pas indexée, voyez si Google connaît son adresse, s’il peut l’ouvrir et quel motif indique le rapport. Si elle est indexée, regardez les impressions et les requêtes. Un site accessible, une page indexée et des visites depuis Google sont trois résultats distincts.
Choisissez une page et son adresse exacte
Prenez une page censée vous amener des clients, l’accueil ou une prestation. Copiez l’adresse finale, celle qui reste dans le navigateur après les redirections. Avec ou sans www, en http ou en https, dans une autre langue, avec un paramètre en plus : pour Google, ce sont autant d’URL différentes. Et ce que vous apprendrez sur la page d’accueil ne vaut pas pour une page de prestation.
- Dans Search Console, ouvrez la propriété validée du site et collez l’URL complète dans la barre d’inspection.
- Notez l’état, la date de la dernière exploration et l’URL canonique choisie par Google, autrement dit la version qu’il retient comme principale parmi les doublons.
- Si la page a changé depuis cette exploration, lancez le test de l’URL publiée et comparez la réponse du moment aux données que Google a conservées.
Le test en direct vérifie si Google peut actuellement récupérer et traiter la page. Il ne signifie pas que cette version figure déjà dans l’index et ne prédit pas le choix de l’URL canonique. Sans accès à Search Console, vous pouvez tout de même examiner la réponse publique du serveur et le HTML. Les données d’indexation, elles, sont à demander à la personne qui gère la propriété validée.
La recherche site:example.com suffit pour un premier coup d’œil. Ce n’est pas un inventaire : le nombre de résultats ne mesure pas la taille de l’index, et l’absence d’une URL dans la liste ne permet de rien conclure.
Lisez l’état avant de choisir une correction
| État | Ce que l’on sait | Vérification suivante |
|---|---|---|
| URL inconnue de Google | L’adresse n’a pas été découverte | Lien depuis une rubrique et URL correcte dans le sitemap |
| Détectée, actuellement non indexée | Google connaît l’URL, mais ne l’a pas explorée | Disponibilité du serveur, liens internes ; statistiques d’exploration si le problème est étendu |
| Explorée, actuellement non indexée | L’exploration a eu lieu, sans indexation | Contenu, pages similaires et URL canonique |
| Exclue par noindex / bloquée par robots.txt | Une restriction a été constatée | Utilité de l’indexation et origine de la règle |
| Doublon ou autre version | Une autre URL sert de référence | Pertinence et indexation de la version principale |
L’état « Détectée, actuellement non indexée » ne dit rien de la qualité du texte, puisque Google n’a pas encore exploré la page. Quant aux doublons, aux pages de connexion ou aux exercices privés, il est souvent normal qu’ils soient exclus. Surveillez les pages publiques qui comptent. Inutile de chercher à ramener à zéro les exclusions du rapport.
Exemple : un site fonctionne, mais son modèle contient encore noindex
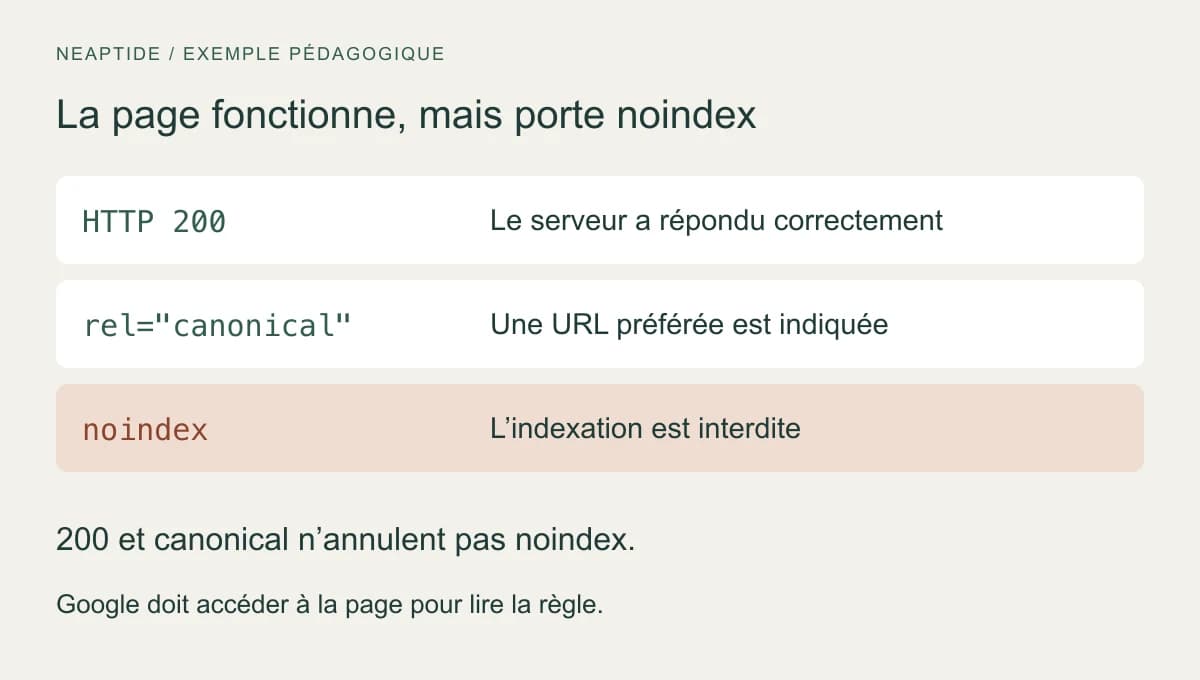
Imaginons un atelier de poterie qui vient de lancer son site. La page des cours est publique, répond avec un code HTTP 200 et figure dans le sitemap. Seulement, le modèle de test dont elle est issue contient encore noindex. Le fragment ci-dessous est un exemple pédagogique et ne provient pas d’un audit client.
HTTP/2 200
Content-Type: text/html

<head>
  <meta name="robots" content="noindex, nofollow">
  <link rel="canonical" href="https://example.com/workshops">
</head>
Le code 200 signifie que le serveur a répondu correctement. La balise canonical désigne l’adresse préférée. Ni l’un ni l’autre n’annule noindex : dès que Google lit cette règle, il retire la page de ses résultats. Ne vous arrêtez pas au HTML, car la même restriction peut arriver par un en-tête HTTP X-Robots-Tag.
- Trouvez d’où vient noindex. Ce peut être un réglage du CMS, le modèle de page, le serveur ou le CDN. Pour une page publique, c’est là qu’il faut retirer la restriction involontaire.
- Vérifiez ce que renvoie l’adresse publiée : en-têtes, HTML, contenu. Ajouter index à côté d’un noindex toujours présent ne résout rien.
- Relancez le test de l’URL publiée dans Search Console. Une fois la restriction disparue, vous pouvez demander l’indexation de cette URL.
Ne bloquez pas la page dans robots.txt pour cacher le noindex à Google. Robots.txt contrôle l’exploration, et Google doit pouvoir récupérer la page pour lire la règle corrigée. Les espaces privés et les pages techniques restreints à dessein, eux, restent comme ils sont.
Aucune restriction ? Examinez le contenu et les doublons
Dans l’inspection d’URL, regardez la page telle que Google l’a rendue. Le nom de la prestation, ses conditions et le texte principal doivent y figurer. Google exécute JavaScript, si bien que React ou un autre framework n’explique rien à lui seul. Cherchez une erreur précise : un bloc de contenu vide, une requête de données qui échoue, une ressource inaccessible.
Comparez l’URL canonique déclarée sur la page à celle que Google a choisie. Il arrive qu’une erreur dans le modèle commun fasse déclarer la page d’accueil comme URL canonique à toutes les pages de service. Dans ce cas, corrigez le modèle. Pour de vrais doublons, employez partout la version souhaitée, dans les liens internes, le sitemap et la balise canonical. Une déclaration n’exprime qu’une préférence. Regardez donc aussi ce que Google a réellement retenu.
Si aucune cause technique n’apparaît, relisez la page comme le ferait un client. Trois pages intitulées « cours de poterie », « cours de céramique » et « atelier de poterie », aux conditions identiques, ne répondent sans doute pas à trois besoins distincts. Avant de les fusionner, comparez leur rôle, leur contenu et leurs données de recherche. Si les formules diffèrent vraiment, dites en quoi : durée, matériaux, niveau requis, objets réalisés.
Mille mots de plus pour faire du volume n’aideront personne à choisir. Les horaires, les conditions d’annulation, de vrais exemples de créations et une réponse claire pour les débutants seront bien plus utiles. La page y gagne en utilité, sans que cela garantisse son indexation par Google.
Pages Next.js non indexées : les contrôles à faire avant de modifier le code
Sur un site Next.js, partez des mêmes éléments vérifiables, URL par URL. Le nom du framework ou la présence de Client Components ne suffit pas à diagnostiquer un problème d’indexation. Examinez la réponse réelle et le contenu de la page, puis remontez du problème observé vers la route, le layout partagé ou la configuration des métadonnées.
| Symptôme | Preuves à recueillir | Vérification suivante |
|---|---|---|
| Une route est absente des résultats de recherche | État dans Search Console, date de la dernière exploration et réponse HTTP actuelle. | Comparer le rapport d’indexation à la page en ligne. Une réponse 200 ne prouve pas, à elle seule, que la page est indexée. |
| La page semble complète dans le navigateur | Contenu principal et liens dans la réponse HTML, puis dans le DOM après rendu. | Si des éléments importants diffèrent, examiner la récupération des données et le rendu. Google peut exécuter JavaScript : il faut identifier le contenu ou la ressource qui manque réellement. |
| Plusieurs pages partagent un titre ou une canonical incorrects | Métadonnées renvoyées par plusieurs routes utilisant le même modèle. | Examiner le layout, les métadonnées de la page et la construction des URL. Après toute modification, vérifier la réponse effectivement publiée. |
| Un nouveau service ou article n’a pas été découvert | Liens internes, sitemap et réponse de l’URL réelle. | Vérifier que les href de navigation sont accessibles et que le sitemap contient l’URL publique prévue. Soumettre un sitemap ne garantit pas l’indexation. |
| Une page traduite pointe vers une autre langue | Liens canonical et alternate des deux versions linguistiques. | Vérifier les URL équivalentes prévues et les liens réciproques. Le ciblage linguistique et le choix de l’URL canonique restent deux décisions distinctes. |
Un contrôle réel de notre site illustre les limites des informations publiques. Le 3 octobre 2026, les six versions linguistiques de notre page GEO renvoyaient un code 200, leur propre URL canonique, des variantes linguistiques concordantes et des entrées dans le sitemap. Leurs titres figuraient dans le HTML initial. Nous pouvions confirmer ces points sans Search Console ; nous ne pouvions pas en déduire que Google avait indexé chaque page.
Valeurs relevées sur notre propre site — 3 octobre 2026

GET https://www.neaptide.ai/en/services/geo
Statut : 200
Canonical : https://www.neaptide.ai/en/services/geo
H1 : GEO services, with a clear scope and budget.
Alternates : en, ru, fr, es, it, zh, x-default
Entrée dans le sitemap : présente

Canonical choisie par Google / état d’indexation : non vérifiésSi une modification des métadonnées s’impose, utilisez la documentation correspondant à la version de Next.js installée. Pour un site App Router, examinez les métadonnées du layout et de la page, ainsi que l’URL qu’elles produisent dans la réponse publiée. Corrigez l’origine de l’incohérence, puis vérifiez à nouveau la réponse et la page après rendu. L’état retenu par Google se contrôle séparément, après traitement de la mise à jour.
- Next.js 15 : métadonnées et generateMetadata
- Google : les bases du SEO JavaScript
- Google : URL canoniques
Si ces contrôles laissent une question que votre équipe ne peut pas résoudre, un audit ciblé peut la transformer en tâche reproductible. Notre offre Next.js précise le périmètre, les livrables et les conditions distinctes de la mise en œuvre.
La page est indexée, mais ne reçoit pas de visites
Ouvrez le rapport de performances des résultats de recherche et filtrez sur l’URL de la page. Vérifiez la période, le pays, l’appareil et le type de recherche. Regardez ensuite quelles requêtes ont généré des impressions (des apparitions dans les résultats) et combien de clics elles ont apportés. Une recherche faite une fois sur votre téléphone ne remplace pas ces données.
- Aucune impression : vérifiez les filtres et l’URL canonique, puis demandez-vous si la page correspond à ce que cherche votre public. L’absence de données ne désigne aucune cause à elle seule.
- Des impressions, peu de clics : examinez ensemble la requête, la position et le résultat affiché. Un titre vague peut gêner la compréhension, mais une position basse limite elle aussi les visites.
- Des clics, aucune demande : vérifiez l’offre et le parcours de contact. Envoyez une demande de test et retrouvez-la chez son destinataire : le message « Envoyé » ne suffit pas.
Transmettez au développeur un problème vérifiable
Remplacez « faites du SEO, on ne nous trouve pas » par une fiche consacrée à une seule page. Notez-y l’URL, la date du contrôle, l’état affiché dans Search Console et la date de la dernière exploration, la réponse du serveur et les restrictions d’indexation. Ajoutez les deux URL canoniques, celle que déclare le site et celle que Google a retenue, puis décrivez le résultat attendu. Joignez le fragment HTML ou la capture du rapport qui étaye le constat.
Dans notre exemple, la correction est acquise quand la page des cours est publique, renvoie son vrai contenu avec un code 200 et n’envoie plus le noindex involontaire, ni dans le HTML ni dans les en-têtes. Un nouveau test en direct chez Google ne relève plus cette restriction. Notez la date du changement. Tout cela confirme la correction. L’indexation, elle, reste à constater.
Après publication, guettez la prochaine exploration et l’évolution de l’état de l’URL. Soumettre plusieurs fois la même adresse n’accélère rien. Google ne garantit ni l’inclusion ni un délai, ce qui fait de « indexé sous 24 heures » un mauvais critère de réception.
Si la cause reste incertaine, confiez cette fiche à la personne chargée de l’audit : elle aura une base concrète pour commencer. Une fois les questions d’accès et d’indexation réglées, vous pourrez passer au contenu et voir si le site répond pleinement aux questions des clients, dans la recherche classique comme dans les réponses des IA.