Next.js 发布前 SEO 检查:八种故障实测
Neaptide · 2026年10月13日 · 9 分钟阅读
我们在 Next.js 测试环境中注入八种故障。小型 HTTP 检查脚本发现六种,漏掉两种。可下载脚本、数据与可复现实验。
本文目录
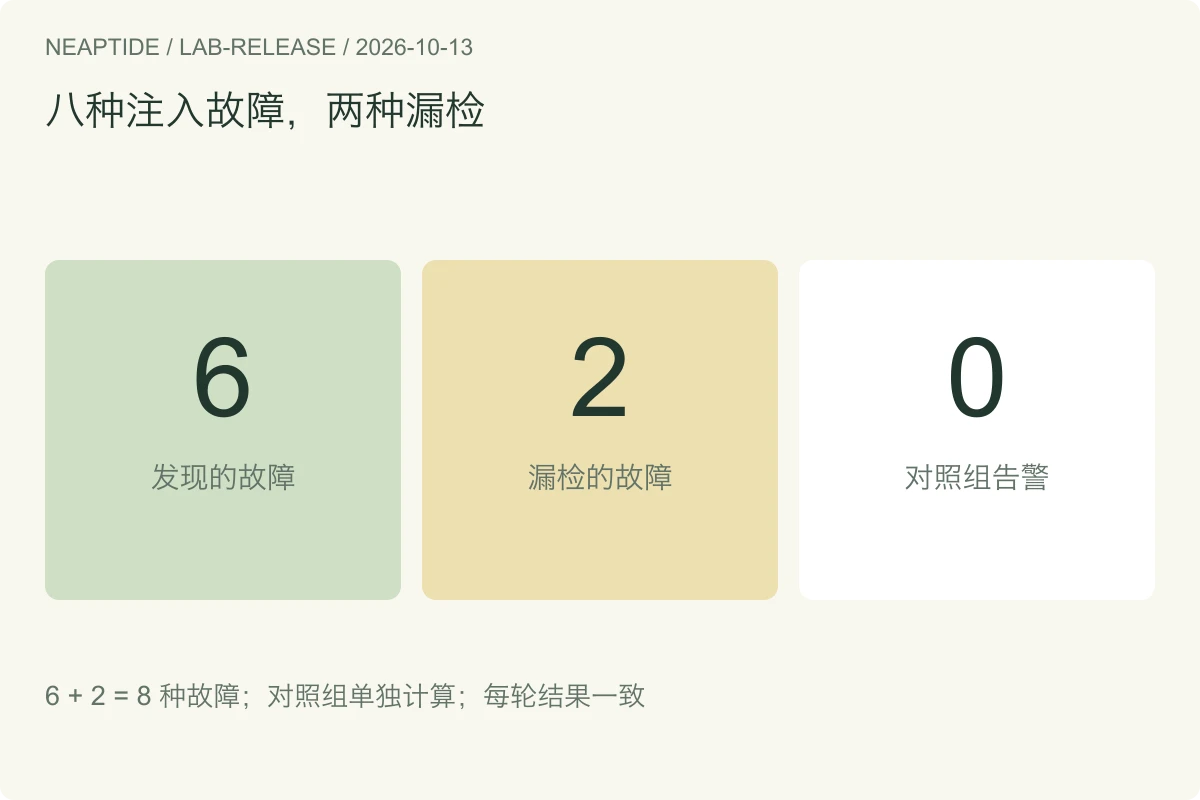
SEO 发布检查通过,只能说明它覆盖的项目没有失败。2026 年 10 月 13 日,我们在 Next.js 生产构建的测试环境中注入八种故障,用一个分析 HTTP 响应 HTML 的小型脚本进行检查。两轮测试中,每轮均发现六种、漏掉两种;无故障对照组没有告警。这两项遗漏说明,发布流程还需要单独检查 robots.txt 和浏览器渲染结果。
一个对照组、八种故障、两轮测试
我们改编了此前 canonical、hreflang 和 sitemap 实验的测试环境。九个场景均包含英文、法文商品页,每个故障场景只注入一项问题。在发送请求之前,我们固定了场景列表、源代码、预期值和检查脚本。这是在 Next.js 15.5.22、React 19.2.6 上进行的本地人工故障实验,并非对九个网站的审计。
脚本检查 HTTP 状态、一个符合预期的 canonical、通用 noindex 指令、非空 title、响应 HTML 中的 H1、完全匹配的 hreflang 映射,以及一个 sitemap 中列出的 URL。title 和 H1 检查是本项目的验收约定,并非 Google 收录的通用必要条件。预期值来自经过审核的配置文件;若从被测页面自动提取预期值,就可能把同一个错误再次当作正确结果。
发现了什么,又漏掉了什么
| 场景/注入条件 | 两轮测试结果 | 报告信号 |
|---|---|---|
| C00 · 无故障对照组 | 无告警 | 无 |
| D01 · Canonical 指向错误域名 | 已发现 | CANONICAL |
| D02 · Robots meta 含 noindex | 已发现 | NOINDEX |
| D03 · 法文 hreflang 指向不存在的路由 | 已发现 | HREFLANG |
| D04 · Sitemap 多列出一个返回 404 的 URL | 已发现 | SITEMAP_TARGET_STATUS |
| D05 · 英文页缺少 title | 已发现 | TITLE |
| D06 · robots.txt 禁止抓取该场景 | 漏检 | 无 |
| D07 · 商品内容在 hydration 后消失 | 漏检 | 无 |
| D08 · HTTP X-Robots-Tag 含 noindex | 已发现 | NOINDEX |

原始实验包含 18 次脚本运行、56 个 HTTP 响应,两轮结果一致。随后我们解压可下载的压缩包,安装锁定依赖并单独构建,另外 18 次运行的全部检查值也与原始结果一致。这验证的是可复现性,不能据此估计实际网站上的检出率。脚本、场景及复核均由同一个代理完成。
报告通过,页面仍可能出错
D07 的 HTTP 响应包含商品标题和内容。执行 JavaScript 后,浏览器只显示商品内容已移除的提示。H1 检查仍然通过,因为脚本只解析响应,并不执行 JavaScript。我们在浏览器中确认了内容缺失,但没有测试 Googlebot 的渲染结果。

D06 的根目录 robots.txt 禁止抓取该场景。普通 GET 请求仍能获得有效页面,而脚本并不解析 robots.txt,因此该场景也通过了检查。Google 分别说明抓取控制、收录指令和渲染机制。HTTP 200 加上没有 noindex,并不能证明 Google 能抓取、渲染或收录预期内容。
运行检查并阅读报告
下载并解压完整测试包。在 fixture 目录依次运行 npm ci --ignore-scripts、npm run build 和 npm run start,保持该终端运行。然后从测试包根目录执行下方命令。检查脚本只需 Python 3.9 或更高版本,无第三方 Python 依赖。README 记录了实际测试的运行环境版本。
python3 check_release.py \
  --origin http://127.0.0.1:8792 \
  --manifest manifests/control.json \
  --out control-check
退出码 0 表示已覆盖的验收项均未失败;1 表示存在问题;2 表示输入或运行错误。每次使用新的输出目录。把 control.json 换成 canonical.json,即可复现已记录的 canonical 故障。要运行完整两轮测试,请在新解压目录执行 python3 collect.py,再执行 python3 analyze.py。
以下片段取自实际 D01 报告。完整文件还包括通过的检查、保存的响应和未覆盖范围。
{
  "passed": false,
  "findings": [
    {
      "code": "CANONICAL",
      "url": "http://127.0.0.1:8792/canonical/en/product",
      "passed": false,
      "observed": [
        "https://wrong.example/product"
      ],
      "expected": [
        "http://127.0.0.1:8792/canonical/en/product"
      ]
    }
  ]
}
用于自己的网站时,请将示例配置替换为经过审核的重要路由及预期值。脚本只请求指定 origin,不跟随重定向,支持一个 sitemap urlset、最多 100 个明确指定页面和 30 个 sitemap URL。它不验证翻译质量或所有 hreflang 关系。复杂的按机器人区分的 X-Robots 语法、sitemap 索引和浏览器行为不在已验证范围内。
脚本之外的发布流程
把报告作为发布决策的一份证据。下表是我们建议的工作流程,并非经过实验验证的发布政策。预发布环境可能有意使用登录限制或 noindex。应为各环境设置合适预期,不要仅为了让检查通过而移除保护。
| 阶段 | 负责人/检查 | 保留证据 |
|---|---|---|
| 发布前 | 开发与 SEO 负责人审核路由、canonical 和已有译文 | 版本化配置、已知例外、与上一构建的对比 |
| 候选版本 | 运行 HTTP 检查,另行审核 robots,并查看 JavaScript 执行后的重要页面 | JSON 报告、robots 审核、浏览器中的可见内容与链接 |
| 上线后 | 对公开 URL 重测;有访问权限时分析 Search Console 和分析平台的变化 | 公开响应与渲染检查;带日期的真实收录及效果数据 |
脚本、测试环境与研究数据
- 完整测试包和 README · ZIP,英文
- 独立检查脚本 · Python
- 协议、观察记录与分析 · JSON,英文
- 九个场景的结果矩阵 · CSV,英文
- 已记录的 D01 报告 · JSON,英文
- 说明与限制 · TXT,英文
这些人工选择的故障不能代表真实网站检出率,不能替代完整 SEO 审计,也不能证明可以避免流量损失。对照组无告警的结论只适用于该对照组。我们没有测量 Google 收录、排名、询盘或 AI 引用,也未量化该主题的搜索需求。结论仅适用于本版脚本及所提供的测试场景。
为便于复现,测试环境保留了旧版锁定依赖。全新安装报告了三项依赖安全公告。请按说明仅在本地回环接口运行;它不是生产项目模板。改用这些代码前,请检查当前依赖安全公告。