SEO prima del rilascio Next.js: otto difetti alla prova
Neaptide · 13 ottobre 2026 · 9 min di lettura
Abbiamo inserito otto difetti in un ambiente Next.js. Un piccolo controllo HTTP ne rileva sei e ne perde due. Script, dati e test riproducibile da scaricare.
In questo articolo
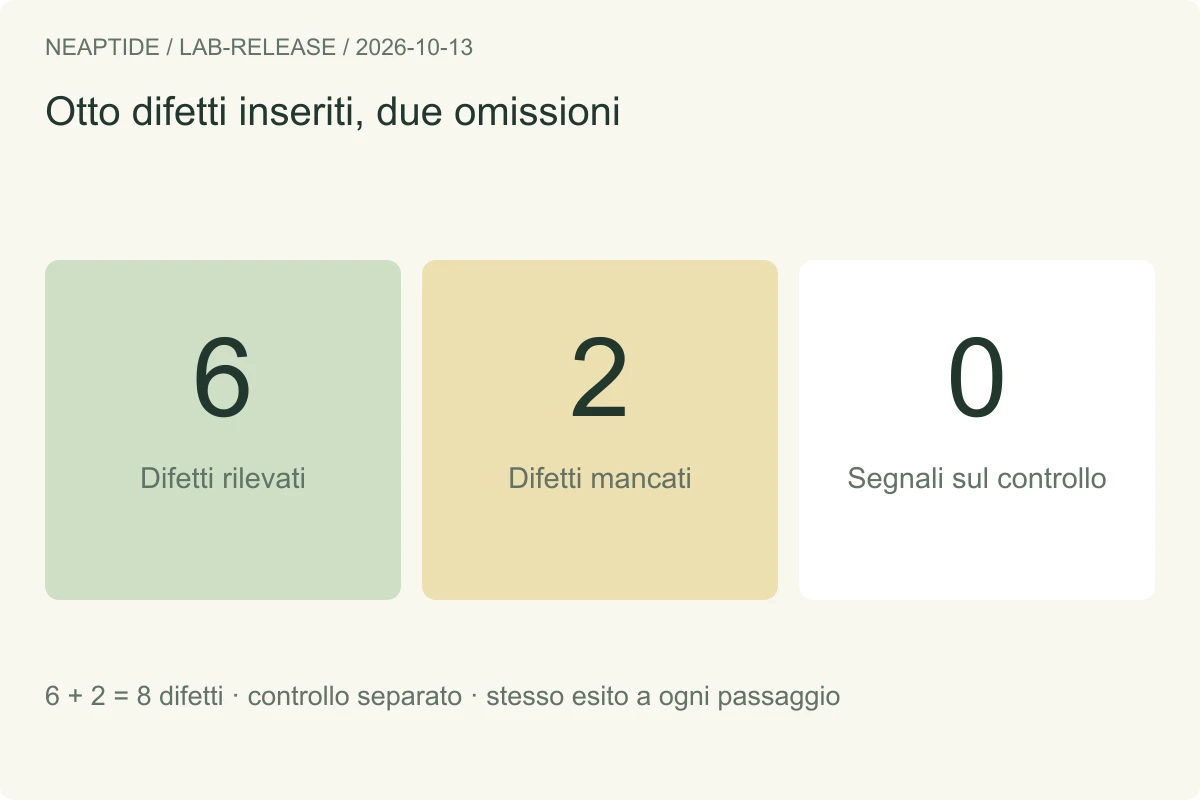
Un controllo SEO superato copre soltanto ciò che può osservare. Il 13 ottobre 2026 abbiamo provato un piccolo script per le risposte HTML su otto difetti inseriti intenzionalmente in una build di produzione Next.js. Ha rilevato sei difetti e ne ha mancati due in ciascuna delle due esecuzioni complete. Il controllo privo di difetti non ha generato segnalazioni. Le due omissioni spiegano perché servono anche verifiche di robots.txt e del contenuto nel browser.
Un controllo, otto difetti, due passaggi
Abbiamo adattato gli ambienti dei precedenti esperimenti su canonical, hreflang e sitemap. Ognuno dei nove scenari aveva schede prodotto in inglese e francese; ogni scenario difettoso introduceva un solo problema. Scenari, sorgenti, valori attesi e script sono stati fissati prima delle richieste. È un esperimento locale con difetti artificiali su Next.js 15.5.22 e React 19.2.6, non un audit di nove siti.
Lo script verifica stato HTTP, un canonical atteso, direttive noindex generiche, un title non vuoto, un H1 nell’HTML della risposta, la mappa hreflang esatta e gli URL di una sitemap. Title e H1 sono requisiti del progetto, non condizioni universali di indicizzazione Google. Le aspettative sono definite in un file revisionato: ricavarle dalla pagina in esame potrebbe far accettare lo stesso errore due volte.
Difetti rilevati e omissioni
| Caso / difetto inserito | Esito di entrambi i passaggi | Segnale nel rapporto |
|---|---|---|
| C00 · Controllo privo di difetti | Nessuna segnalazione | Nessuno |
| D01 · Canonical verso un altro dominio | Rilevato | CANONICAL |
| D02 · Meta robots con noindex | Rilevato | NOINDEX |
| D03 · Hreflang francese verso una route assente | Rilevato | HREFLANG |
| D04 · URL aggiuntivo con 404 nella sitemap | Rilevato | SITEMAP_TARGET_STATUS |
| D05 · Title assente nella pagina inglese | Rilevato | TITLE |
| D06 · robots.txt vieta la scansione dello scenario | Non rilevato | Nessuno |
| D07 · Contenuto prodotto rimosso dopo l’idratazione | Non rilevato | Nessuno |
| D08 · Intestazione HTTP X-Robots-Tag con noindex | Rilevato | NOINDEX |

L’esperimento iniziale comprende 18 esecuzioni dello script e 56 risposte HTTP. Gli esiti coincidono nei due passaggi. Abbiamo poi estratto l’archivio scaricabile, installato le dipendenze fissate e ricompilato separatamente: tutti i valori delle verifiche coincidono in altre 18 esecuzioni. È una prova di riproducibilità, non una stima rappresentativa della capacità di rilevamento. Lo stesso agente ha progettato script, scenari e revisione.
Un rapporto positivo può accompagnare una pagina guasta
In D07 la risposta conteneva il titolo principale e il contenuto del prodotto. Dopo JavaScript, il browser mostrava solo un messaggio che ne annunciava la rimozione. Il test H1 passava perché lo script analizzava la risposta senza eseguire JavaScript. Abbiamo confermato l’assenza del contenuto nel browser; non abbiamo testato il rendering di Googlebot.

In D06 il robots.txt principale vietava la scansione dello scenario. Le normali richieste GET ricevevano comunque pagine valide e lo script non interpretava robots.txt. Anche questo caso passava. Google documenta separatamente scansione, direttive di indicizzazione e rendering. Uno stato 200 senza noindex non dimostra che Google possa accedere al contenuto previsto, renderizzarlo o indicizzarlo.
Eseguire il controllo e leggere il rapporto
Scarica ed estrai il pacchetto completo. Nella cartella fixture esegui npm ci --ignore-scripts, npm run build e npm run start. Lascia aperto il terminale. Dalla radice del pacchetto esegui il comando seguente. Basta Python 3.9 o successivo, senza librerie Python esterne. Il README indica le versioni effettivamente testate.
python3 check_release.py \
  --origin http://127.0.0.1:8792 \
  --manifest manifests/control.json \
  --out control-check
Il codice 0 indica che nessun requisito coperto è fallito; 1 indica segnalazioni; 2 un errore di input o esecuzione. Usa ogni volta una nuova cartella di output. Sostituisci control.json con canonical.json per riprodurre il difetto registrato. Per i due passaggi completi esegui python3 collect.py e python3 analyze.py da una nuova estrazione.
Questo estratto proviene dal rapporto effettivo di D01. Il file completo include anche controlli superati, risposte conservate e aree non verificate.
{
  "passed": false,
  "findings": [
    {
      "code": "CANONICAL",
      "url": "http://127.0.0.1:8792/canonical/en/product",
      "passed": false,
      "observed": [
        "https://wrong.example/product"
      ],
      "expected": [
        "http://127.0.0.1:8792/canonical/en/product"
      ]
    }
  ]
}
Per il tuo sito sostituisci il manifesto di esempio con route importanti e valori attesi revisionati. Lo script interroga solo l’origine indicata, non segue redirect e supporta un sitemap urlset, fino a 100 pagine esplicite e 30 URL della sitemap. Non verifica la qualità delle traduzioni né tutte le relazioni hreflang. Sintassi X-Robots complesse per singolo crawler, indici di sitemap e comportamento del browser restano fuori dal perimetro validato.
Completare il processo di rilascio
Il rapporto è una delle prove da valutare prima del rilascio. La tabella propone un processo, non una politica validata sperimentalmente. Uno staging può prevedere autenticazione o noindex intenzionali. Adatta le aspettative all’ambiente senza rimuovere le protezioni solo per ottenere un esito positivo.
| Fase | Responsabile / verifica | Prove da conservare |
|---|---|---|
| Prima del rilascio | Sviluppatore e responsabile SEO revisionano route, canonical e traduzioni disponibili | Manifesto versionato, eccezioni e confronto con la build precedente |
| Versione candidata | Controlli HTTP, revisione separata di robots e ispezione dopo JavaScript | Rapporto JSON, revisione robots, contenuti e link visibili nel browser |
| Dopo il deploy | Ripetere sugli URL pubblici; esaminare Search Console e analytics se accessibili | Risposte e rendering pubblici; dati reali di indicizzazione e prestazioni con date |
Script, ambiente di test e dati
- Pacchetto completo e README · ZIP, in inglese
- Verificatore autonomo · Python
- Protocollo, osservazioni e analisi · JSON, in inglese
- Matrice dei nove casi · CSV, in inglese
- Rapporto D01 registrato · JSON, in inglese
- Istruzioni e limiti · TXT, in inglese
Questi casi artificiali selezionati non stimano il rilevamento sui siti reali, non sostituiscono un audit completo e non dimostrano la prevenzione di perdite di traffico. L’assenza di segnali vale solo per questo controllo. Non abbiamo misurato indicizzazione Google, posizioni, contatti o citazioni AI. La domanda di ricerca non è stata quantificata. La conclusione riguarda questa versione dello script e questi scenari.
L’ambiente conserva vecchie dipendenze fissate per riprodurre l’esperimento. L’installazione pulita ha riportato tre avvisi di sicurezza. Mantieni il test sull’interfaccia locale documentata: non è una base per la produzione. Consulta gli avvisi attuali prima di adattare il codice.