SEO перед релизом Next.js: проверка на восьми ошибках
Neaptide · 13 октября 2026 г. · 9 мин чтения
Внесли восемь ошибок в стенд Next.js. Небольшой HTTP-скрипт нашёл шесть и пропустил две. Скрипт, данные и повторяемый эксперимент доступны для скачивания.
В этой статье
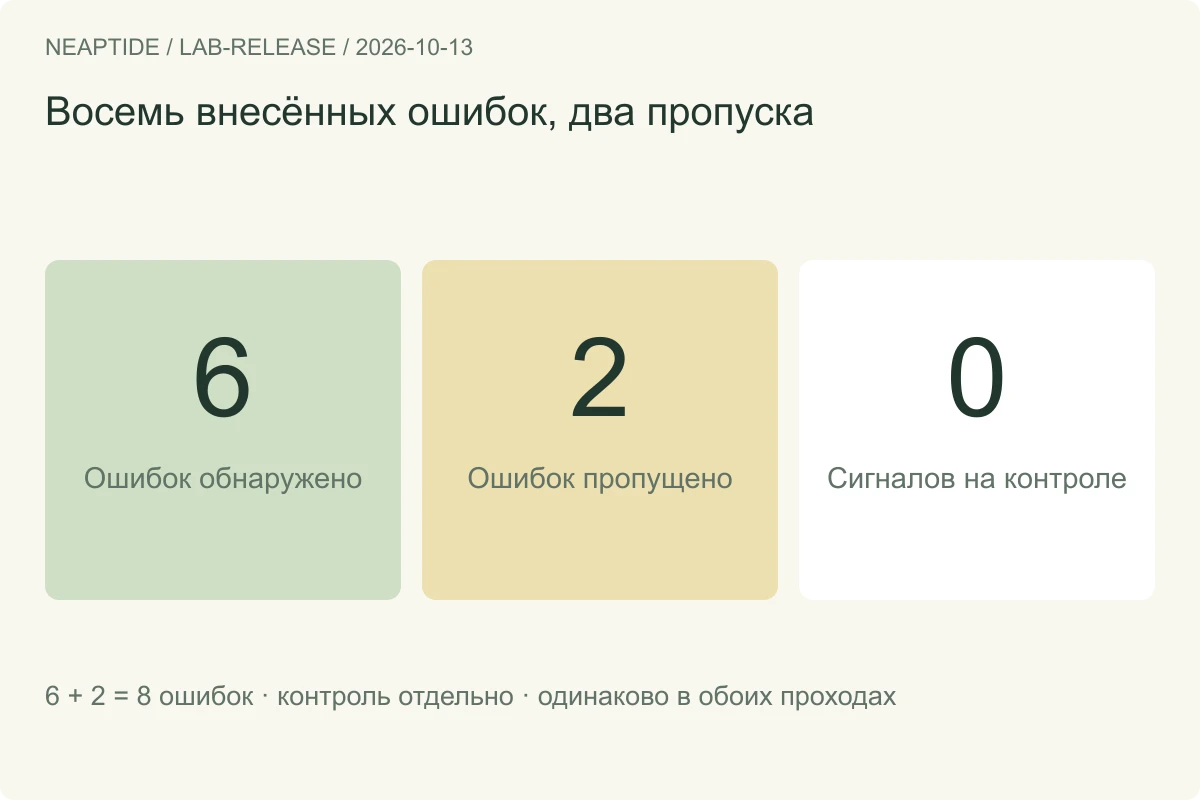
Успешная SEO-проверка перед релизом подтверждает только то, что она умеет наблюдать. 13 октября 2026 года мы проверили небольшой скрипт на восьми намеренно внесённых ошибках в production-сборке Next.js. В каждом из двух проходов он обнаружил шесть ошибок и пропустил две. Исправный контроль не вызвал предупреждений. Два пропуска показывают, зачем в релизном чек-листе нужны отдельные проверки robots.txt и страницы в браузере.
Один контроль, восемь ошибок, два прохода
За основу взяли стенды предыдущих экспериментов с canonical, hreflang и sitemap. В каждом из девяти сценариев были английская и французская карточки товара; в каждый ошибочный сценарий внесли одну проблему. До запросов зафиксировали сценарии, исходники, ожидаемые значения и скрипт. Это локальный эксперимент на Next.js 15.5.22 и React 19.2.6 с искусственными ошибками, а не аудит девяти сайтов.
Скрипт проверяет статус ответа, один ожидаемый canonical, общие директивы noindex, непустой title, наличие H1 в HTML-ответе, точную карту hreflang и адреса из одной sitemap. Требования к title и H1 — условия этого проекта, а не универсальные требования Google к индексации. Ожидания задаются в проверенном файле настроек. Если извлекать их из тестируемой страницы, можно повторно принять ту же ошибку за норму.
Что обнаружено, а что пропущено
| Сценарий / внесённое изменение | Результат обоих проходов | Сигнал в отчёте |
|---|---|---|
| C00 · Исправный контроль | Без предупреждений | Нет |
| D01 · Canonical указывает на чужой домен | Обнаружено | CANONICAL |
| D02 · В robots meta добавлен noindex | Обнаружено | NOINDEX |
| D03 · Французский hreflang ведёт на отсутствующий маршрут | Обнаружено | HREFLANG |
| D04 · В sitemap добавлен адрес с 404 | Обнаружено | SITEMAP_TARGET_STATUS |
| D05 · У английской страницы нет title | Обнаружено | TITLE |
| D06 · robots.txt запрещает обход сценария | Пропущено | Нет |
| D07 · После гидратации исчезает контент товара | Пропущено | Нет |
| D08 · В HTTP-заголовок X-Robots-Tag добавлен noindex | Обнаружено | NOINDEX |

Основной эксперимент — 18 запусков скрипта и 56 HTTP-ответов. Результаты двух проходов совпали. Затем мы распаковали скачиваемый архив, установили зафиксированные зависимости и отдельно собрали стенд: значения всех проверок совпали ещё в 18 запусках. Повторение подтверждает воспроизводимость, но не превращает восемь выбранных ошибок в репрезентативную оценку качества обнаружения. Скрипт, стенды и проверку подготовил один агент.
Почему успешный отчёт не исключает поломку страницы
В D07 HTTP-ответ содержал заголовок и описание товара. После выполнения JavaScript браузер показывал только сообщение об удалении контента. Проверка H1 прошла: скрипт разобрал ответ, но не исполнял JavaScript. Отсутствие контента мы подтвердили в браузере. Отрисовку Googlebot этот опыт не проверяет.

В D06 корневой robots.txt запрещал обход сценария. Обычные GET-запросы по-прежнему получали корректные страницы, а скрипт не разбирал robots.txt. Поэтому этот сценарий тоже прошёл. В документации Google отдельно рассматриваются управление обходом, директивы индексации и отрисовка. Ответ 200 без noindex сам по себе не подтверждает доступ Google к нужному контенту и его индексацию.
Как запустить проверку и прочитать отчёт
Скачайте и распакуйте полный комплект. В каталоге fixture выполните npm ci --ignore-scripts, npm run build и npm run start. Оставьте этот терминал открытым. Из корня распакованного комплекта запустите команду ниже. Скрипту достаточно Python 3.9 или новее без сторонних Python-библиотек. Точные проверенные версии среды указаны в README.
python3 check_release.py \
  --origin http://127.0.0.1:8792 \
  --manifest manifests/control.json \
  --out control-check
Код 0 означает, что покрытые условия выполнены; 1 — найдены нарушения; 2 — ошибка входных данных или запуска. Каждый раз используйте новый выходной каталог. Замените control.json на canonical.json, чтобы получить зафиксированную ошибку canonical. Для двух полных проходов выполните python3 collect.py и python3 analyze.py в свежей распаковке.
Этот фрагмент взят из фактического отчёта D01. Полный файл также содержит успешные проверки, сохранённые ответы и список непроверяемых областей.
{
  "passed": false,
  "findings": [
    {
      "code": "CANONICAL",
      "url": "http://127.0.0.1:8792/canonical/en/product",
      "passed": false,
      "observed": [
        "https://wrong.example/product"
      ],
      "expected": [
        "http://127.0.0.1:8792/canonical/en/product"
      ]
    }
  ]
}
Для своего проекта замените пример настроек проверенным списком важных маршрутов и ожидаемых значений. Скрипт обращается только к заданному origin, не следует редиректам и поддерживает один sitemap urlset, до 100 явно заданных страниц и 30 адресов из sitemap. Он не проверяет качество перевода и все связи hreflang. Сложные правила X-Robots для отдельных роботов, индексы sitemap и поведение браузера не входят в проверенный охват.
Что добавить в процесс выпуска
Используйте отчёт как одно из доказательств при решении о релизе. Ниже — предлагаемый порядок работы, а не экспериментально подтверждённая политика выпуска. На тестовом окружении авторизация или noindex могут быть намеренными. Задавайте ожидания для каждой среды, не снимая защиту ради успешного отчёта.
| Этап | Ответственный / проверка | Что сохранить |
|---|---|---|
| До релиза | Разработчик и SEO-специалист согласуют маршруты, canonical и доступные переводы | Версия настроек, исключения и сравнение с прошлой сборкой |
| Кандидат на релиз | HTTP-проверка, отдельный разбор robots и просмотр важных страниц после JavaScript | JSON-отчёт, результат проверки robots, видимый контент и ссылки |
| После выкладки | Повторить на публичных адресах; при наличии доступа изучить изменения в Search Console и аналитике | Публичные ответы и отрисовка; реальные данные индексации и показателей с датами |
Скрипт, стенд и данные исследования
- Полный комплект и README · ZIP, на английском
- Отдельный скрипт · Python
- Протокол, наблюдения и анализ · JSON, на английском
- Матрица девяти сценариев · CSV, на английском
- Фактический отчёт D01 · JSON, на английском
- Инструкция и ограничения · TXT, на английском
Выбранные искусственные сценарии не дают оценки обнаружения ошибок на реальных сайтах, не заменяют полный аудит и не доказывают предотвращение потерь трафика. Отсутствие сигналов относится только к этому контролю. Индексацию Google, позиции, заявки и цитирования ИИ мы не измеряли. Частотность запроса не определялась. Вывод ограничен этой версией скрипта и стендами.
Для повторения сохранены старые фиксированные версии зависимостей. При чистой установке аудит сообщил о трёх предупреждениях безопасности. Стенд предназначен для localhost согласно инструкции, а не для рабочего сайта. Перед адаптацией кода проверьте актуальные предупреждения зависимостей.