Checklist SEO avant déploiement Next.js : huit défauts testés
Neaptide · 13 octobre 2026 · 9 min de lecture
Huit défauts injectés dans un projet de test Next.js : notre script HTTP en détecte six et en laisse passer deux. Script, données et protocole à télécharger.
Dans cet article
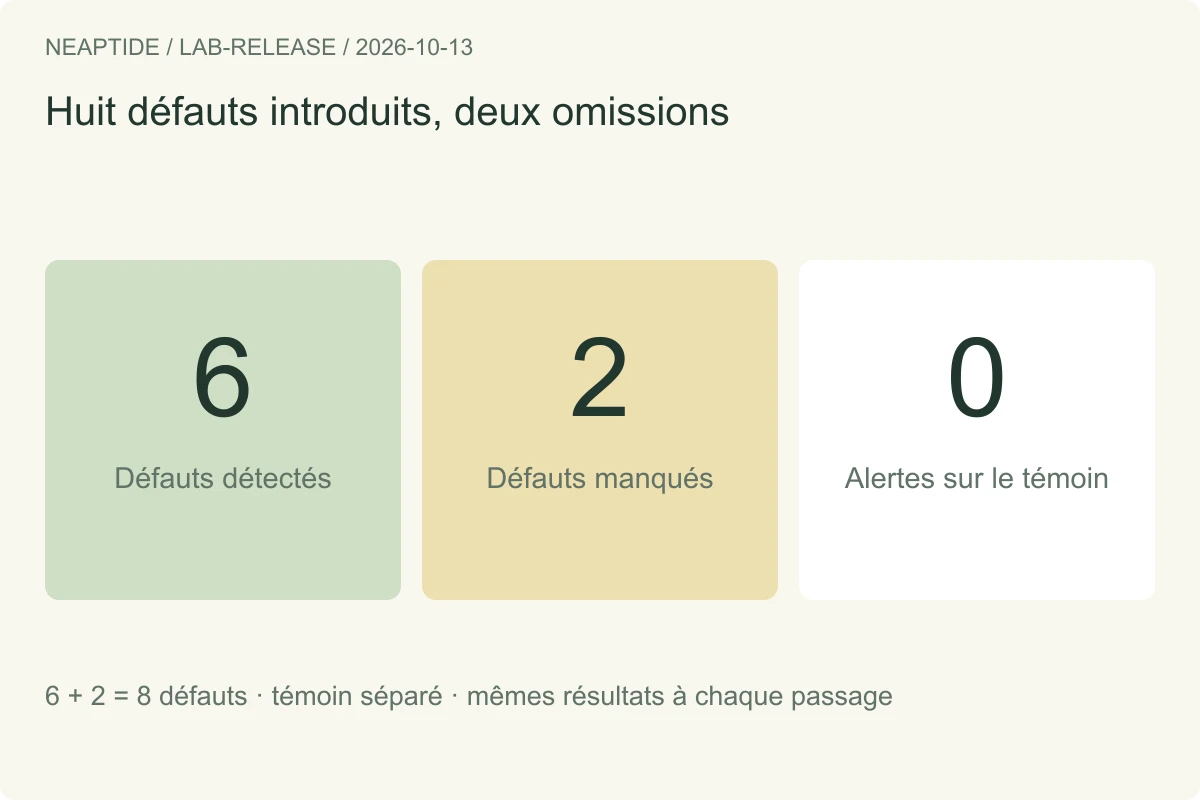
Un contrôle SEO de pré-déploiement ne valide que ce qu’il est capable d’observer. Le 13 octobre 2026, nous avons testé un script léger d’analyse des réponses HTML sur huit défauts injectés volontairement dans un build de production Next.js. Il en a détecté six et laissé passer deux lors de chacun des deux passages. Le scénario témoin sans défaut n’a déclenché aucune alerte. Ces deux angles morts expliquent pourquoi une checklist de mise en ligne doit aussi inclure l’analyse de robots.txt et un contrôle dans le navigateur.
Un témoin, huit défauts, deux passages
Nous avons repris et adapté les environnements de test de nos expériences précédentes sur les balises canonical, hreflang et les sitemaps. Chacun des neuf scénarios comportait une fiche produit en anglais et en français ; chaque scénario défectueux introduisait une seule anomalie. La liste des scénarios, les fichiers sources, les valeurs attendues et le script ont été figés avant l’envoi des requêtes. Il s’agit d’une expérience locale en environnement synthétique sous Next.js 15.5.22 et React 19.2.6, et non de l’audit de neuf sites réels.
Le script vérifie le code HTTP, une URL canonique attendue, les directives noindex génériques, une balise <title> non vide, la présence d’un H1 dans le HTML reçu, la correspondance exacte du jeu de balises hreflang et les URL listées dans un sitemap. Les contrôles sur <title> et H1 traduisent des contrats propres au projet, et non des conditions universelles d’indexation par Google. Les valeurs attendues proviennent d’un manifeste relu en amont : les extraire directement de la page testée reviendrait à risquer de valider deux fois la même erreur.
Défauts détectés et angles morts du script
| Cas / défaut injecté | Résultat sur les deux passages | Signal remonté |
|---|---|---|
| C00 · Témoin sans défaut | Aucune alerte | Aucun |
| D01 · Balise canonical vers un mauvais domaine | Détecté | CANONICAL |
| D02 · Balise meta robots avec noindex | Détecté | NOINDEX |
| D03 · Lien hreflang français vers une route inexistante | Détecté | HREFLANG |
| D04 · URL supplémentaire en 404 dans le sitemap | Détecté | SITEMAP_TARGET_STATUS |
| D05 · Balise <title> absente sur la page anglaise | Détecté | TITLE |
| D06 · Exploration du scénario bloquée dans robots.txt | Non détecté | Aucun |
| D07 · Contenu produit effacé après l’hydratation | Non détecté | Aucun |
| D08 · En-tête HTTP X-Robots-Tag contenant noindex | Détecté | NOINDEX |

L’expérience initiale repose sur 18 exécutions du script et 56 réponses HTTP, avec des résultats strictement identiques d’un passage à l’autre. Nous avons ensuite extrait l’archive téléchargeable à part, installé ses dépendances figées et recompilé le projet : les 18 nouvelles exécutions ont donné exactement les mêmes valeurs. Ces répétitions valident la reproductibilité du protocole, mais ne transforment pas huit cas choisis à la main en taux de détection représentatif. Un même agent a conçu le script, les scénarios de test et leur relecture.
Pourquoi un rapport au vert peut masquer une page cassée
Dans le cas D07, la réponse HTTP contient bien le titre principal et le descriptif du produit. Une fois le JavaScript exécuté, le navigateur n’affiche plus qu’un message indiquant que le contenu produit a été retiré. Le contrôle du H1 passe au vert parce que le script lit la réponse brute sans jamais exécuter JavaScript. Ce constat repose sur une observation dans le navigateur, et non sur un test de rendu par Googlebot.

Dans le cas D06, le fichier robots.txt à la racine interdit l’exploration du scénario. Les requêtes GET ordinaires n’en reçoivent pas moins des pages valides, et le script n’analyse pas robots.txt : ce cas passe donc lui aussi sans alerte. Google distingue dans sa documentation le contrôle de l’exploration, les directives d’indexation et le rendu. Un code HTTP 200 sans directive noindex ne suffit pas à prouver que Google peut explorer, afficher ou indexer le contenu attendu.
Exécuter le contrôle et lire le rapport
Téléchargez et extrayez l’archive complète du test. Dans le dossier fixture, lancez npm ci --ignore-scripts, npm run build, puis npm run start, et laissez ce terminal actif. Depuis la racine de l’archive extraite, exécutez la commande ci-dessous. Python 3.9 ou supérieur suffit ; aucune dépendance Python tierce n’est requise. Le fichier README précise les versions exactes utilisées lors de nos essais.
python3 check_release.py \
  --origin http://127.0.0.1:8792 \
  --manifest manifests/control.json \
  --out control-check
Un code de sortie 0 indique qu’aucun contrat vérifié n’a échoué ; le code 1 signale des anomalies ; le code 2 correspond à une erreur de paramètres ou d’exécution. Indiquez un nouveau dossier de sortie à chaque passage. Remplacez control.json par canonical.json pour reproduire l’erreur de balise canonical enregistrée. Pour rejouer les deux passages complets, lancez python3 collect.py puis python3 analyze.py depuis une archive fraîchement extraite.
Cet extrait est issu du rapport réel généré pour le cas D01. Le rapport complet consigne également les contrôles validés, les preuves extraites des réponses HTTP et les points hors périmètre non vérifiés.
{
  "passed": false,
  "findings": [
    {
      "code": "CANONICAL",
      "url": "http://127.0.0.1:8792/canonical/en/product",
      "passed": false,
      "observed": [
        "https://wrong.example/product"
      ],
      "expected": [
        "http://127.0.0.1:8792/canonical/en/product"
      ]
    }
  ]
}
Pour votre propre site, remplacez le manifeste d’exemple par une liste relue de vos routes critiques et de leurs valeurs attendues. Le script n’interroge que l’origine fournie, ne suit aucune redirection et prend en charge un seul sitemap urlset, dans la limite de 100 pages explicites et de 30 URL de sitemap. Il ne contrôle ni la qualité des traductions ni l’ensemble des relations hreflang. La syntaxe X-Robots-Tag ciblant un user-agent précis, les index de sitemaps et le comportement dans le navigateur restent hors du périmètre validé.
Intégrer ce script dans un processus de déploiement complet
Utilisez ce rapport comme l’une des pièces de validation d’une mise en production. Le tableau ci-dessous décrit un mode opératoire proposé, et non une politique de déploiement validée expérimentalement. Un environnement de préproduction peut légitimement appliquer une authentification ou une directive noindex : adaptez vos attentes à chaque environnement, sans jamais lever ces protections uniquement pour faire passer le contrôle.
| Étape | Responsable / contrôle | Preuves à conserver |
|---|---|---|
| Avant déploiement | Le développeur et le référent SEO valident les routes attendues, les URL canoniques et les traductions disponibles | Manifeste versionné, exclusions connues et comparaison avec le build précédent |
| Version candidate | Exécution des contrôles HTTP, relecture séparée de robots.txt et inspection des pages clés après JavaScript | Rapport JSON, validation de robots.txt et preuves du contenu et des liens rendus dans le navigateur |
| Après déploiement | Relance du contrôle sur les routes publiques ; suivi dans la Search Console et l’analytics lorsque les accès sont ouverts | Relevés de réponses et de rendu publics ; données datées d’indexation et de performance réelles |
Script, environnement de test et données de recherche
- Archive complète du test et README · ZIP (en anglais)
- Script de vérification autonome · Python
- Protocole, observations et analyse · JSON (en anglais)
- Matrice des résultats sur les neuf cas · CSV (en anglais)
- Rapport D01 enregistré · JSON (en anglais)
- Instructions et limites · TXT (en anglais)
Ce protocole de laboratoire sur cas choisis n’établit pas un taux de détection en conditions réelles, ne remplace pas un audit SEO complet et ne garantit pas l’absence de perte de trafic. L’absence d’alerte sur le témoin ne vaut que pour ce témoin précis. Nous n’avons mesuré ni l’indexation dans Google, ni les positions, ni les prises de contact, ni les citations par les moteurs IA, et nous n’avons pas chiffré la demande de recherche sur ce sujet. Nos conclusions se limitent à la version fournie du script et à ces scénarios.
L’environnement de test conserve d’anciennes dépendances figées afin de garantir la reproductibilité. Une installation propre a remonté trois avis de sécurité sur les dépendances : maintenez ce serveur sur l’interface locale (loopback) comme documenté, sans l’utiliser comme base de production, et consultez les bulletins de sécurité à jour avant d’en adapter le code.