SEO antes de publicar Next.js: ocho fallos a prueba
Neaptide · 13 de octubre de 2026 · 9 min de lectura
Introdujimos ocho fallos en un entorno Next.js. Un verificador HTTP detectó seis y omitió dos. Descarga el script, los resultados y la prueba reproducible.
En este artículo
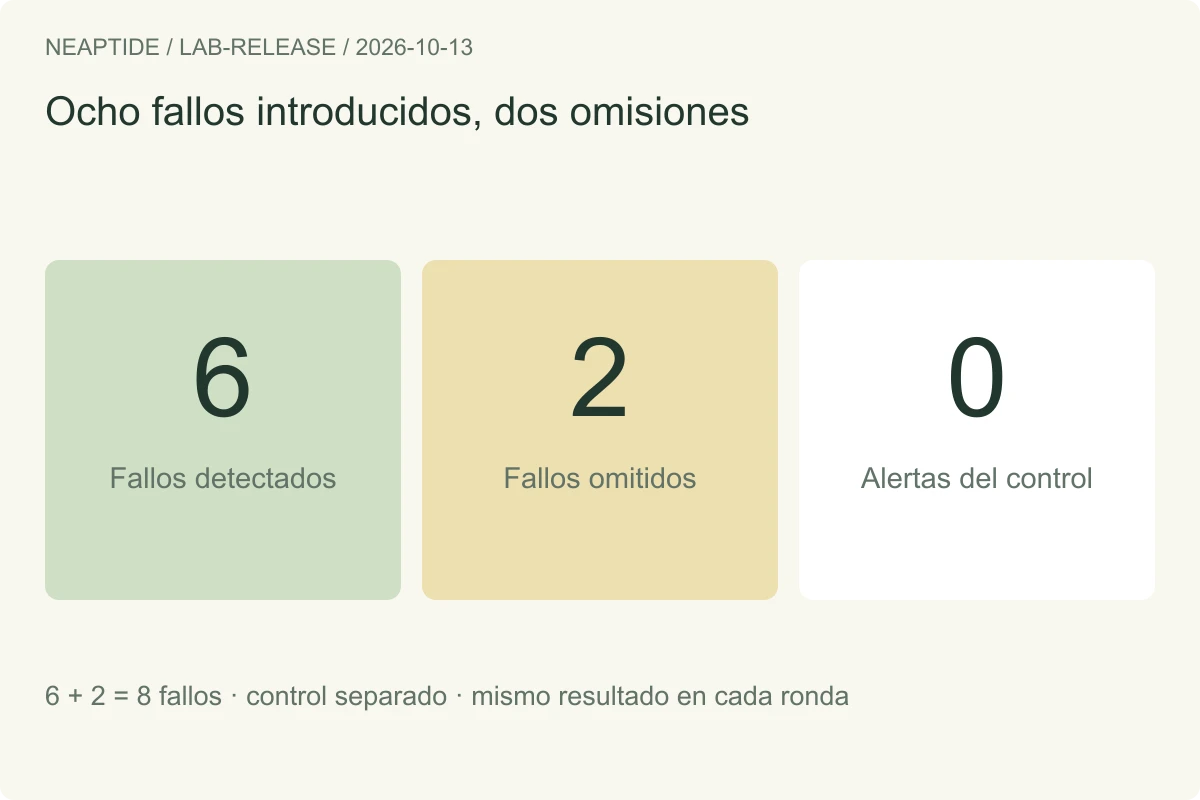
Una comprobación SEO superada solo cubre lo que puede observar. El 13 de octubre de 2026 probamos un pequeño script de análisis del HTML de respuesta frente a ocho fallos introducidos en una compilación de producción de Next.js. Detectó seis y omitió dos en cada una de las dos rondas. El control sin fallos no generó alertas. Las dos omisiones explican por qué también hay que revisar robots.txt y el contenido en el navegador.
Un control, ocho fallos y dos rondas
Adaptamos los entornos de nuestros experimentos anteriores sobre canonical, hreflang y sitemap. Cada uno de los nueve escenarios tenía fichas de producto en inglés y francés; cada escenario defectuoso incorporaba un solo problema. Fijamos escenarios, código, valores esperados y verificador antes de hacer las solicitudes. Es un experimento local con fallos artificiales en Next.js 15.5.22 y React 19.2.6, no una auditoría de nueve sitios.
El script comprueba el estado HTTP, un canonical esperado, directivas noindex genéricas, un title no vacío, un H1 en el HTML de respuesta, el mapa exacto de hreflang y las URL de un sitemap. Los controles de title y H1 son requisitos del proyecto, no condiciones universales de indexación de Google. Un manifiesto revisado define las expectativas. Extraerlas de la propia página podría dar por correcto el mismo error dos veces.
Qué detectó y qué pasó por alto
| Caso / fallo introducido | Resultado en ambas rondas | Señal del informe |
|---|---|---|
| C00 · Control sin fallos | Sin alertas | Ninguna |
| D01 · Canonical apunta a otro dominio | Detectado | CANONICAL |
| D02 · Meta robots contiene noindex | Detectado | NOINDEX |
| D03 · Hreflang francés apunta a una ruta inexistente | Detectado | HREFLANG |
| D04 · El sitemap incluye una URL adicional con 404 | Detectado | SITEMAP_TARGET_STATUS |
| D05 · La página inglesa no tiene title | Detectado | TITLE |
| D06 · robots.txt bloquea el escenario | No detectado | Ninguna |
| D07 · El contenido del producto desaparece tras la hidratación | No detectado | Ninguna |
| D08 · La cabecera HTTP X-Robots-Tag contiene noindex | Detectado | NOINDEX |

El experimento original abarcó 18 ejecuciones y 56 respuestas HTTP. Los hallazgos coincidieron entre rondas. Después extrajimos el archivo descargable, instalamos las dependencias fijadas y compilamos por separado: todos los valores de las comprobaciones coincidieron en otras 18 ejecuciones. Esto verifica la reproducibilidad, no una tasa de detección representativa. El mismo agente diseñó el script, los escenarios y la revisión.
Un informe correcto puede acompañar a una página rota
En D07, la respuesta contenía el encabezado y el contenido del producto. Tras ejecutar JavaScript, el navegador solo mostraba un mensaje de eliminación del contenido. El control H1 pasó porque el script analizaba la respuesta sin ejecutar JavaScript. Confirmamos la ausencia del contenido en el navegador; no probamos el renderizado de Googlebot.

En D06, el robots.txt raíz prohibía rastrear el escenario. Las solicitudes GET normales seguían recibiendo páginas válidas y el script no interpretaba robots.txt. Por eso también pasó ese caso. Google documenta por separado rastreo, directivas de indexación y renderizado. Un estado 200 sin noindex no demuestra que Google pueda rastrear, renderizar o indexar el contenido previsto.
Ejecutar la comprobación y leer el informe
Descarga y extrae el paquete completo. En fixture ejecuta npm ci --ignore-scripts, npm run build y npm run start. Deja esa terminal abierta. Desde la raíz del paquete, ejecuta el comando siguiente. Basta Python 3.9 o posterior, sin bibliotecas Python externas. El README recoge las versiones concretas utilizadas.
python3 check_release.py \
  --origin http://127.0.0.1:8792 \
  --manifest manifests/control.json \
  --out control-check
El código 0 significa que ningún requisito cubierto ha fallado; 1 indica hallazgos; 2, un error de entrada o ejecución. Usa un directorio de salida nuevo cada vez. Cambia control.json por canonical.json para reproducir el fallo registrado. Para las dos rondas completas, ejecuta python3 collect.py y python3 analyze.py desde una extracción nueva.
Este fragmento procede del informe real D01. El archivo completo incluye también controles superados, respuestas guardadas y áreas no comprobadas.
{
  "passed": false,
  "findings": [
    {
      "code": "CANONICAL",
      "url": "http://127.0.0.1:8792/canonical/en/product",
      "passed": false,
      "observed": [
        "https://wrong.example/product"
      ],
      "expected": [
        "http://127.0.0.1:8792/canonical/en/product"
      ]
    }
  ]
}
Para tu sitio, sustituye el manifiesto por rutas importantes y valores esperados revisados. El script solo solicita el origen indicado, no sigue redirecciones y admite un sitemap urlset, hasta 100 páginas explícitas y 30 URL del sitemap. No valida la calidad de las traducciones ni todas las relaciones hreflang. La sintaxis X-Robots compleja por agente, los índices de sitemaps y el comportamiento del navegador quedan fuera del alcance validado.
Completar el proceso de publicación
Usa el informe como una de las pruebas para decidir la publicación. La tabla propone un proceso; no es una política de despliegue validada experimentalmente. Un entorno de pruebas puede usar autenticación o noindex de forma intencionada. Ajusta las expectativas a cada entorno sin retirar sus protecciones para conseguir un resultado positivo.
| Etapa | Responsable / comprobación | Pruebas que conservar |
|---|---|---|
| Antes de publicar | Desarrollo y responsable SEO revisan rutas, canonical y traducciones disponibles | Manifiesto versionado, excepciones y comparación con la compilación anterior |
| Versión candidata | Controles HTTP, revisión separada de robots e inspección tras JavaScript | Informe JSON, revisión de robots, contenido y enlaces visibles en el navegador |
| Tras el despliegue | Repetir sobre URL públicas; analizar Search Console y analítica si hay acceso | Respuestas y renderizado públicos; datos reales de indexación y rendimiento con fechas |
Script, entorno de prueba y datos
- Paquete completo y README · ZIP, en inglés
- Verificador independiente · Python
- Protocolo, observaciones y análisis · JSON, en inglés
- Matriz de nueve casos · CSV, en inglés
- Informe D01 registrado · JSON, en inglés
- Instrucciones y límites · TXT, en inglés
Esta selección artificial no permite estimar la detección en sitios reales, sustituir una auditoría completa ni demostrar que se eviten pérdidas de tráfico. La ausencia de alertas solo describe este control. No medimos indexación de Google, posiciones, contactos comerciales ni citas de IA. Tampoco cuantificamos la demanda de búsqueda. La conclusión se limita a esta versión del script y estos escenarios.
El entorno conserva versiones antiguas fijadas para repetir el experimento. La instalación limpia notificó tres avisos de seguridad de dependencias. Mantenlo en la interfaz local indicada; no es una base para producción. Revisa los avisos actuales antes de adaptar el código.