Next.js 部分页面未翻译时如何设置 hreflang:实测示例
Neaptide · 2026年10月4日 · 9 分钟阅读
通过可复现的 Next.js 实验和 18 个线上 URL 检查,说明翻译不完整时如何统一 hreflang、canonical、sitemap 与语言切换。
本文目录
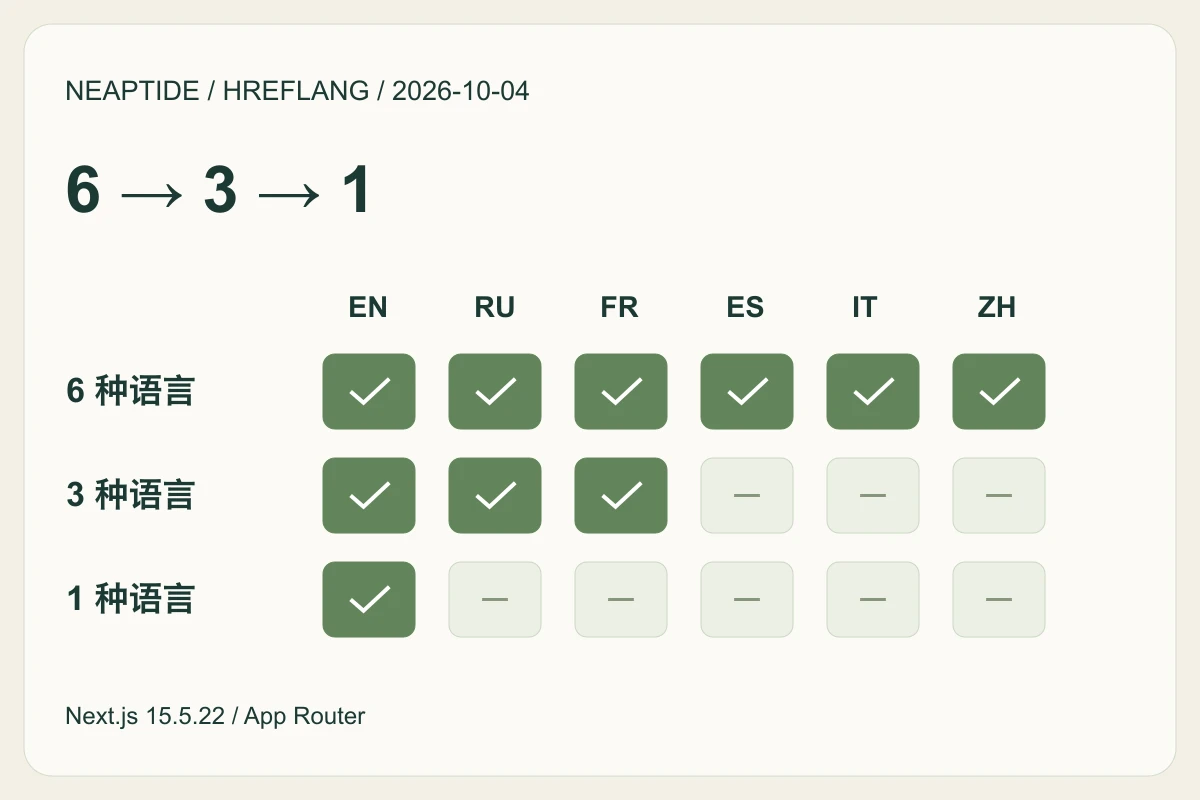
页面的语言链接应来自该页面已经发布的翻译,而不是网站支持的全部语言。让 hreflang、sitemap 和语言切换器共用这份可用性记录。网站配置里有法语,并不意味着每篇文章都已翻译成法语。
我们于 2026 年 10 月 4 日进行了验证。一个刻意设置错误的 Next.js 实验项目生成了 14 条指向缺失翻译的 hreflang 链接、14 条同类导航链接,以及 sitemap 中八个不存在的 URL。改用页面级翻译记录后,三类不一致全部消失。另外检查的 18 个 Neaptide 线上 URL 通过了下述验证。这两组数据都没有测量 Google 排名或收录。
两组数据,各自回答不同问题
线上样本包含三条路由的六种语言版本:GEO 服务、多语言网站指南和 B2B 目录文章。我们进行了两轮 HTTP 检查,查看每个页面的浏览器渲染结果,并从每个 URL 执行一次语言切换。一次请求发生连接重置,另行记录的重试成功。因此总计 37 次尝试、36 次成功响应,而不是第一轮毫无错误。
| 路由 | 检查 URL 数 | 元数据与 sitemap | 语言切换 |
|---|---|---|---|
| /services/geo | 6 | 6 / 6 | 6 / 6 |
| /blog/multilingual-website-guide | 6 | 6 / 6 | 6 / 6 |
| /blog/b2b-catalog-seo | 6 | 6 / 6 | 6 / 6 |
18 个 URL 均返回 200,canonical 指向自身,并与 sitemap 中的语言标注一致。每页声明六个语言版本,x-default 指向英语。18 次切换均保留了原路由。这只是每个来源 URL 的一次操作,并未测试所有语言配对或整个网站。检查对象是已发布的 B2B 文章,不是它更新后的本地研究稿。
翻译不完整时的受控实验
我们单独建立了 App Router 实验项目,使用 Next.js 15.5.22、React 19.2.6 和 Node.js v25.2.1。测量前固定三种配置:六种翻译、三种翻译、仅英语原文。每个阶段检查 18 种路由与语言组合,其中 10 页存在、八页缺失。修复前后各做两轮 HTTP 检查,共得到 72 条观察;同时在浏览器中打开全部 36 种组合。

错误版本中的三种输出都使用全站六种语言列表。修正后改用实际存在的翻译记录。已发布页面始终保留指向自身的 canonical。我们没有补入替代内容,也没有把缺失翻译重定向到首页。
| 配置 | 错误 hreflang 链接:前 → 后 | 错误切换链接:前 → 后 | sitemap 缺失 URL:前 → 后 |
|---|---|---|---|
| 6 种语言 | 0 → 0 | 0 → 0 | 0 → 0 |
| 3 种语言 | 9 → 0 | 9 → 0 | 3 → 0 |
| 1 种语言 | 5 → 0 | 5 → 0 | 5 → 0 |
这些计数单位不同:链接按来源页面分别计算,sitemap URL 按条目计算,不能相加当作损坏页面数。两轮 HTTP 结果一致,36 次 DOM 检查也与 HTML 一致。五次代表性点击确认了三次正常跳转,以及两条故意错误的链接进入 404。实验不说明这类错误有多普遍。
共用一份翻译可用性记录
实验中的 TRANSLATIONS 只保存已发布内容。availableLocales 读取其中的语言,generateStaticParams 生成对应路由。设置 dynamicParams = false 后,缺失组合仍不可访问;页面和元数据函数也会检查翻译记录。下方片段使用与实测项目相同的辅助函数。下载项目同时包含两个阶段,查看修复方案时应使用 after 分支。
export const availableLocales = profile => Object.keys(TRANSLATIONS[profile] || {});
export const translation = (profile, locale) => TRANSLATIONS[profile]?.[locale];
export const pageUrl = (profile, locale, phase) => `${ORIGIN}/${locale}/${phase}/${profile}`;
export async function generateMetadata({ params }) {
const { phase, profile, locale } = await params;
const content = translation(profile, locale);
if (!PHASES.includes(phase) || !content) notFound();
return {
title: content.title,
alternates: { canonical: pageUrl(profile, locale, phase), languages: languageAlternates(profile, phase) },
};
}after 分支的 languageAlternates 仅返回已发布的对应页面。多语言配置将英语设为 x-default;仅英语原文的配置不输出语言标注。这是我们的明确选择。如果原文是其他语言,应为该翻译组选择真实存在的默认页面。不同语言使用不同 slug 时,应保存对应 URL,而非替换前缀;本实验未覆盖本地化 slug。
canonical、hreflang 与导航各有职责
canonical 标明首选 URL,hreflang 连接本地化的对应页面。我们的各语言译文使用指向自身的 canonical。切换器应带用户进入同一内容的现有语言版本。可以另设清楚标注的其他语言首页链接,但它只是普通导航,不是缺失文章的翻译。
Google 文档说明了绝对 URL、双向对应和自引用要求。HTML 与 sitemap 是两种可选标注方式;本项目同时使用二者,因此检查了它们的一致性。
翻译尚未准备好时
从翻译组及对应页面的切换列表中移除不可用版本,草稿也不应进入公开 sitemap。如果提供英语原文链接,应标明其语言并指向真实的英语 URL。法语路径返回 200、正文却是英语,不能证明法语翻译已经完成。
在本次静态实验中,八种缺失组合在两个阶段均返回 404 和 noindex;这是实际响应结果。动态渲染或流式输出需要单独检查状态,代码中出现 notFound() 并不等同于已经测得 HTTP 状态。
每次发布翻译后都检查实际结果
- 打开所有已发布的对应页面,检查状态、最终 URL、语言与 canonical。
- 将每条声明的语言链接与可用性记录对照,再检查目标页面及返回链接。
- 把 sitemap 条目与已发布内容比较;若含语言标注,再与 HTML 对照。
- 在受影响的页面上使用切换器,同时测试有效翻译与缺失语言的处理方式。
- 新增或撤回翻译后重做检查,保存日期、路由与证据;通过 Search Console 另行观察收录。
复现实验
可下载实验源码、观察结果和完整方法。ZIP 不包含依赖或构建产物。在本地按文档端口构建并启动项目,再运行附带的 HTTP 收集脚本。原始浏览器检查单独记录,该脚本不会重复执行浏览器交互。
这是同一天由一名研究者完成的技术检查,覆盖三条线上路由与受控静态示例;没有全面审查翻译质量,也没有测量 Google 选定的 canonical、收录、排名、流量或 AI 引用。