Что такое токены ИИ: как устроены контекст, лимиты и оплата
Neaptide · 6 сентября 2026 г. · 6 мин чтения · Обновлено: 4 октября 2026 г.
Токены, контекст и стоимость ИИ: расчёт по официальному тарифу Claude Sonnet 5.5, проверка usage и способы сократить расход.
В этой статье
Короткое «поправь последний абзац» может обойтись в заметное число токенов. Вместе с этой фразой приложение нередко отправляет модели предыдущую переписку, документ и служебные инструкции, так что расход считают по всему запросу целиком. Последняя реплика в нём — малая часть.
Токен и слово: в чём разница
Модель читает текст кусочками, их называют токенами. Токеном может оказаться один символ, часть слова или слово целиком. Твёрдого курса «слова в токены» нет: всё зависит от самого текста и от токенизатора, то есть от того, как модель режет текст на части. Когда считаете расходы, берите счётчик той модели, с которой будете работать.
Что помещается в контекст модели
Контекстное окно — это предел объёма данных, с которым модель работает в одном запросе. По документации OpenAI, в него входят входные данные, ответ и, у части моделей, токены рассуждения. У каждой модели два ограничения, и смотреть надо оба: размер контекста и максимальную длину ответа. В большое окно поместится длинный документ. Что модель верно учтёт в нём каждую деталь, никто не обещает.
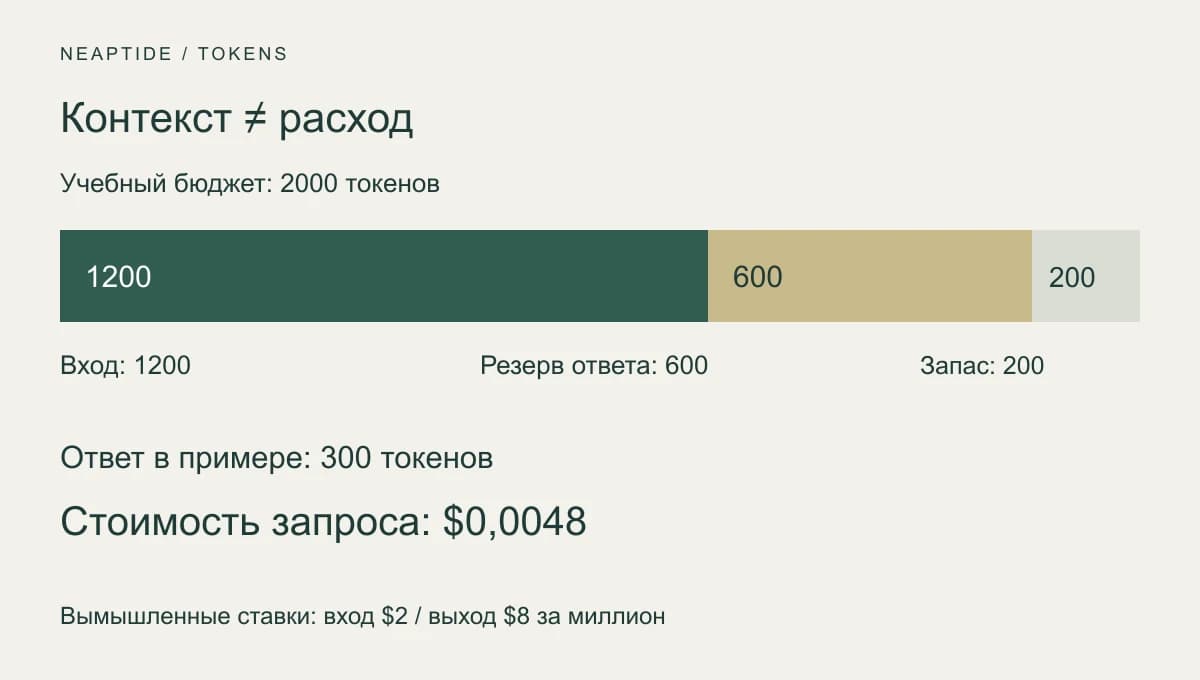
В нашем условном примере окно — 2000 токенов. 1200 занимают входные данные, до 600 отведено под ответ, 200 остаются про запас. Если ответ уложился в 300 токенов, сгенерировано именно 300: резерв расходом не считается. В настоящем API отдельно посмотрите, как оплачиваются токены рассуждения и прочие категории.
Что входит в запрос, кроме вашего сообщения
- Инструкции приложения и переданная история переписки.
- Текст документов, найденные фрагменты и результаты инструментов.
- Изображения и другие входные данные — по правилам выбранного сервиса.
Что именно уходит модели, решает приложение. У OpenAI, например, продолжение диалога через previous_response_id не отменяет оплату предыдущих входных токенов: они снова тарифицируются как вход. Вот почему короткая реплика в длинной переписке порой стоит дороже развёрнутого вопроса в новом чате.
Расчёт по официальному тарифу Claude Sonnet 5.5
На 3 октября 2026 года Anthropic указывает для Claude Sonnet 5.5 базовую цену $2 за миллион входных токенов и $10 за миллион выходных. Ниже расчёт по этому тарифу; объём 1 200 входных и 300 выходных токенов выбран для примера, реальный API-запрос не выполнялся. Без кэша, Batch API, инструментов, налогов и иных надбавок.
| Категория | Токены | Расчёт | Стоимость, USD |
|---|---|---|---|
| Вход | 1 200 | 1 200 × 2 / 1 000 000 | 0.0024 |
| Выход | 300 | 300 × 10 / 1 000 000 | 0.0030 |
| Итого | 1 500 | 0.0024 + 0.0030 | 0.0054 |
1 000 таких запросов стоили бы $5,40, три одинаковые попытки — $0,0162. Это расчёт, а не счёт провайдера. Реальные попытки различаются по длине, поэтому стоимость задачи надо складывать из usage всех вызовов, включая неудачные.
Где взять точное число токенов
- До отправки посчитайте весь вход целиком — счётчиком провайдера и для той модели, которую выбрали.
- После ответа загляните в статистику usage, если API её отдаёт. Спрашивать у самой модели, сколько она потратила, ненадёжно: ответит наугад.
- Сверьте категории usage с тарифом и начислениями: платить иногда приходится не только за видимый текст ответа.
- Сгруппируйте запросы по задачам, тогда будет видно, во что обошёлся каждый результат.
У OpenAI есть отдельный метод для подсчёта входных токенов. В документации Gemini описаны и предварительный подсчёт, и статистика расхода, которая приходит вместе с ответом. Названия полей и правила учёта сверяйте с документацией своей версии API.
Как уменьшить расход и сохранить важные сведения
Уберите повторы, старые версии документов и всё, что к задаче не относится. Уточните формат результата: скажем, пять ошибок с цитатами вместо полного пересказа. А вот условия задачи, исключения и источники оставьте — без них ответ легко выйдет неверным.
Чтобы продолжить долгую работу в новом чате, подготовьте сводку: какие решения приняты, какие есть ограничения, что ещё не решено, где лежат материалы. Сверьте её с исходной перепиской. Потерянное при сокращении условие потом обходится дороже сэкономленного: на исправления уйдёт и время, и токены.
Считайте, во что обходится пригодный результат вместе с проверкой и переделками. От дешёвого запроса мало толку, если ответ потом приходится целиком переписывать руками.