Tokens IA : comprendre le contexte et calculer le coût
Neaptide · 6 septembre 2026 · 6 min de lecture · Mis à jour: 4 octobre 2026
Tokens, contexte et coût de l’IA : calcul au tarif officiel de Claude Sonnet 5.5, vérification de la consommation et pistes pour la réduire.
Dans cet article
Vous demandez seulement de corriger le dernier paragraphe, et la consommation grimpe. L’application a peut-être envoyé aussi l’historique, un document et ses propres consignes. Votre dernière phrase n’est alors qu’une petite partie de la requête.
Un token n’est pas un mot
Le token est l’unité dans laquelle le modèle lit les données et rédige sa réponse. Dans un texte, il correspond tantôt à un caractère, tantôt à un fragment de mot ou à un mot entier. Aucune conversion fixe n’existe, alors comptez votre texte avec l’outil prévu pour le modèle choisi.
Ce qui doit tenir dans la fenêtre de contexte
La fenêtre de contexte limite le volume utilisable en une requête. OpenAI y compte les tokens d’entrée, de sortie et, pour certains modèles, de raisonnement. Deux limites sont à vérifier, celle du contexte et celle de la réponse. Et une grande fenêtre ne garantit pas que chaque détail sera lu sans erreur.
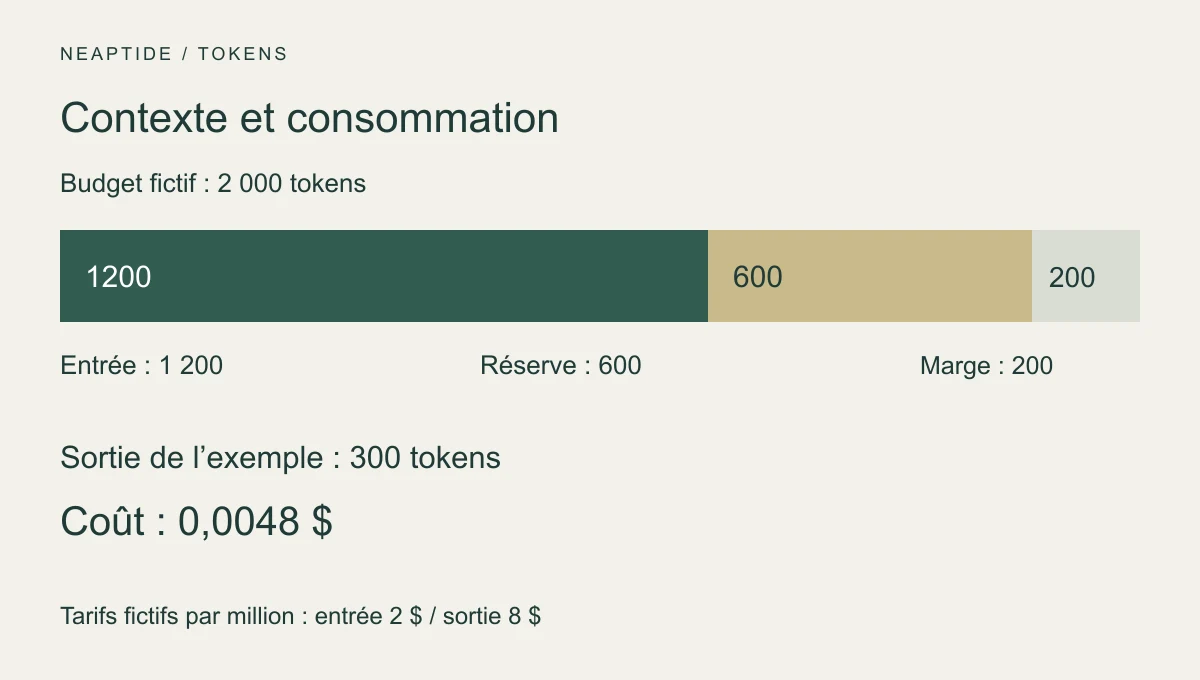
Dans cet exemple, 600 tokens sont réservés à la réponse. Si elle en utilise 300, seuls ces 300 ont été générés. Avec une API réelle, appliquez aussi les règles des autres catégories, raisonnement compris.
Ce que contient réellement l’entrée
- Les consignes de l’application et l’historique transmis.
- Le texte des documents, les extraits retrouvés et les résultats des outils.
- Les images et autres données, selon les règles du fournisseur.
Tout dépend de ce que l’application envoie. OpenAI précise qu’avec previous_response_id, les tokens d’entrée des échanges précédents restent facturés. Une courte relance peut donc consommer plus de tokens qu’un premier message bien plus long.
Calcul avec le tarif publié de Claude Sonnet 5.5
Au 3 octobre 2026, Anthropic affiche pour Claude Sonnet 5.5 un tarif de base de 2 USD par million de tokens en entrée et de 10 USD en sortie. Les 1 200 tokens en entrée et 300 en sortie sont une hypothèse de calcul, pas un appel API mesuré. Cache, Batch API, outils, taxes et autres suppléments sont exclus.
| Catégorie | Tokens | Calcul | Coût, USD |
|---|---|---|---|
| Entrée | 1 200 | 1 200 × 2 / 1 000 000 | 0.0024 |
| Sortie | 300 | 300 × 10 / 1 000 000 | 0.0030 |
| Total | 1 500 | 0.0024 + 0.0030 | 0.0054 |
Avec ce volume, 1 000 requêtes coûteraient 5,40 USD et trois tentatives identiques 0,0162 USD. Ce calcul ne constitue pas une facture. Les appels réels varient : additionnez les frais issus du champ usage de chaque tentative, y compris les échecs.
Mesurer avant et après l’appel
- Avant l’envoi, comptez l’entrée complète avec l’outil du fournisseur.
- Après la réponse, lisez les données de consommation renvoyées par l’API, en particulier les champs usage. Inutile de demander au modèle combien de tokens il a utilisés, il ne ferait que deviner.
- Rapprochez les catégories des tarifs et des montants facturés. La réponse visible ne représente pas toujours toute la consommation.
- Regroupez les appels par tâche pour connaître le coût du résultat.
OpenAI fournit dans son API une méthode qui compte les tokens d’entrée avant l’envoi. La documentation Gemini décrit elle aussi ce comptage préalable, ainsi que les données de consommation renvoyées avec la réponse. Vérifiez quels champs existent dans votre version de l’API et ce qu’ils recouvrent.
Réduire le superflu, préserver les exigences
Commencez par supprimer les doublons, les anciennes versions et les passages hors sujet. Demandez ensuite une sortie utile, par exemple cinq erreurs accompagnées de citations au lieu d’un résumé intégral. Les contraintes, les exceptions et les sources, elles, restent.
Pour poursuivre une longue conversation dans un nouveau chat, préparez une synthèse : décisions prises, contraintes, questions en suspens, liens vers les sources. Relisez-la en regard de la conversation d’origine. Une condition oubliée peut coûter plus de travail que la réduction du contexte n’en épargne.
Comparez ce que coûte un résultat validé, vérification et corrections comprises. Un appel d’API bon marché laisse parfois beaucoup de travail à la personne qui reprend la réponse.