AI Token 是什么:上下文、输出上限与 API 费用
Neaptide · 2026年9月6日 · 6 分钟阅读 · 更新于: 2026年10月4日
理解 Token、上下文与 AI 费用:按 Claude Sonnet 5.5 官方价格计算,核对 usage,并减少不必要的用量。
本文目录
你只发了一句“修改最后一段”,用量却涨了一截。原因可能是应用把聊天记录、文档和系统指令一并发给了模型。最后那条消息有多长,和整个请求有多大是两回事。
Token 不是“一个字”或“一个词”
Token 是模型处理输入、生成输出时用的单位。在文本里,一个 Token 可能是一个字符、半个词,也可能是一个完整的词。怎么换算,要看分词器和具体内容。做预算别套固定的字数公式,用目标模型对应的计数工具去数。
上下文窗口限制单次请求的容量
上下文窗口是模型在一次请求中可使用的 Token 容量。按 OpenAI 文档的说法,输入、输出都算在这笔预算里,部分模型还要算上推理 Token。具体到某个模型,上下文限制和输出限制要分开查。另外,文档放得进去,不代表里面每个细节都会被正确处理。
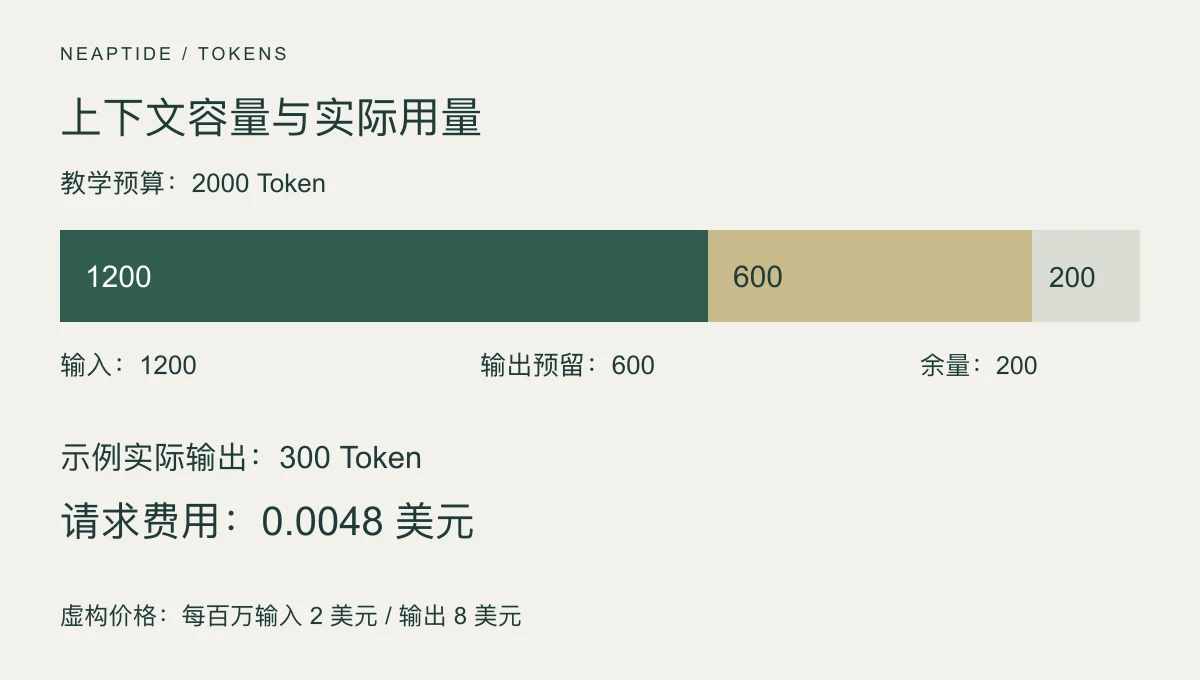
示例里给输出预留了 600 Token。如果回答实际只生成 300 Token,用量就是 300,预留的那 600 不能全算进去。真实 API 还可能单列推理等类别,要按各自的规则核算。
输入中还可能包含什么
- 应用指令,以及应用选择传入的历史消息。
- 文档内容、检索到的片段和工具返回结果。
- 图片等其他数据,按服务商的规则计数。
具体传什么,由应用决定。OpenAI 明确说明,使用 previous_response_id 并不会让之前的输入 Token 免费。所以长对话里一句简短的追问,输入用量可能比新对话里的一条长消息还多。
按 Claude Sonnet 5.5 的官方价格计算
截至2026年10月3日,Anthropic 公布的 Claude Sonnet 5.5 基础价格为每百万输入 Token 2美元、每百万输出 Token 10美元。下面假设输入1,200个、输出300个 Token,并未实际调用 API。计算不含缓存、Batch API、工具、税费及其他附加费用。
| 类别 | Token 数 | 算式 | 费用(美元) |
|---|---|---|---|
| 输入 | 1 200 | 1 200 × 2 / 1 000 000 | 0.0024 |
| 输出 | 300 | 300 × 10 / 1 000 000 | 0.0030 |
| 合计 | 1 500 | 0.0024 + 0.0030 | 0.0054 |
按这个假设用量,1,000次请求为5.40美元,三次相同的尝试为0.0162美元。这是计算结果,并非账单。实际重试的长度会变化,应根据每次调用的 usage 累加费用,包括失败的尝试。
请求前估算,请求后核对
- 发送前,用服务商的计数工具计算完整输入,并选择正确的模型。
- 收到回答后,读取 usage 用量数据,不要让模型猜测自己用了多少 Token。
- 将用量类别与计费规则、实际扣费逐项对应。可见回答不一定涵盖全部用量。
- 按任务归集多次请求,计算完成一项工作的总成本。
OpenAI 提供输入 Token 计数接口。Gemini 文档也讲了请求前怎么计数,以及响应里带回哪些用量类别。字段名称以你所用的 API 版本为准。
减少无用内容,保留关键条件
先删掉重复内容、过期版本和无关段落。再把回答形式说清楚,比如“列出五处错误并附原文”,别让它完整复述一遍。限制条件、例外和证据不能为了省 Token 而删。
如果要在新对话里继续原来的工作,可以整理一份摘要,写明已经做出的决定、限制条件、待解决的问题和原始资料链接。使用前,再与原对话核对一遍。漏掉一个关键条件就可能返工,花的比省下的那点 Token 还多。
最后要比的是通过验收的工作成本,检查和返工都得算进去。一次调用再便宜,留下一堆人工修正的活,整个任务也未必便宜。