Tokens de IA: contexto, límites y coste de una consulta
Neaptide · 6 de septiembre de 2026 · 6 min de lectura · Actualizado: 4 de octubre de 2026
Tokens, contexto y costes de IA: cálculo con las tarifas oficiales de Claude Sonnet 5.5, comprobación del consumo y formas de reducirlo.
En este artículo
Pides «corrige el último párrafo» y el consumo sube. Puede que la aplicación haya enviado además el historial, un documento y sus propias instrucciones. Tu mensaje es solo una parte de la entrada, a veces la más pequeña.
Un token no equivale a una palabra
El modelo trabaja con tokens, tanto para leer la entrada como para escribir la respuesta. En un texto, un token puede ser un carácter, un trozo de palabra o una palabra entera. No hay conversión fija, porque depende del tokenizador y del propio texto. Si vas a hacer un presupuesto, usa un contador compatible con el modelo.
El contexto limita lo que cabe en una consulta
La ventana de contexto limita el volumen que el modelo puede utilizar en una solicitud. OpenAI cuenta en ese presupuesto la entrada, la salida y, en algunos modelos, los tokens de razonamiento. Revisa los dos límites, el de contexto y el de respuesta. Y que un documento quepa no garantiza que todos sus detalles se interpreten bien.
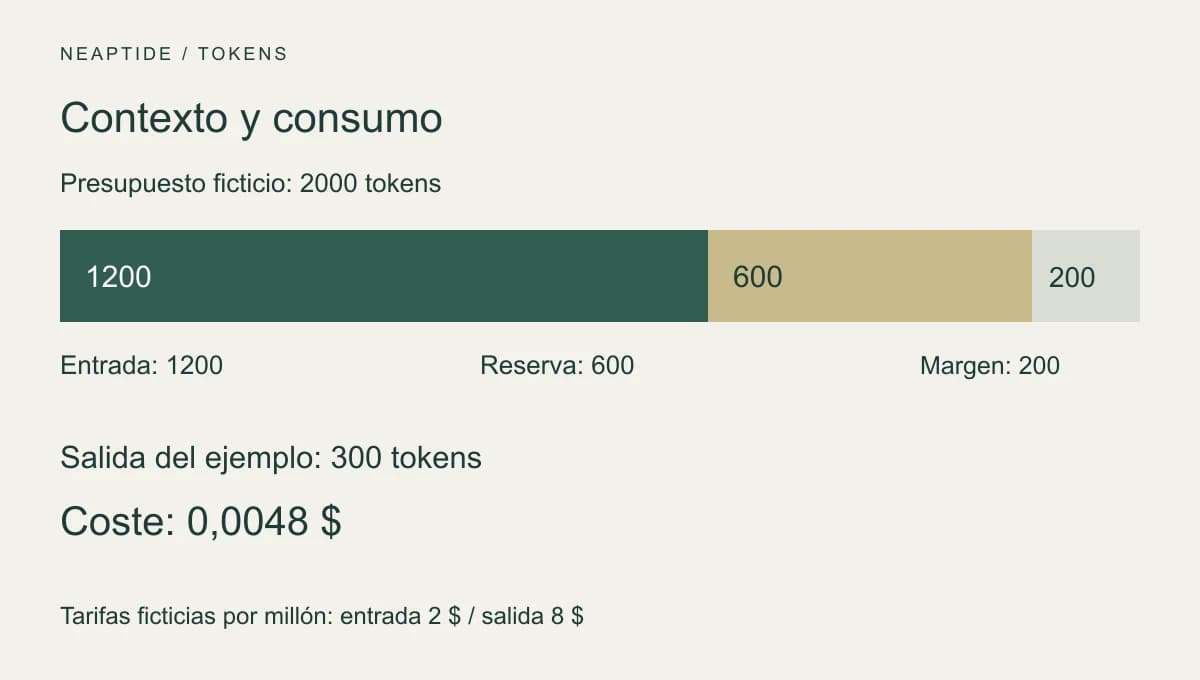
Reservamos 600 tokens para la respuesta. Si al final el modelo genera 300, ha generado 300, no los 600 reservados. En una API real, mira también cómo se contabilizan el razonamiento y las demás categorías.
Qué más puede incluir la entrada
- Instrucciones de la aplicación e historial que esta envíe.
- Documentos, fragmentos recuperados y resultados de herramientas.
- Imágenes y otros datos, según las reglas del proveedor.
Qué información se envía lo decide la aplicación. OpenAI señala que continuar una conversación con previous_response_id no hace gratuitos los tokens de entrada de los intercambios anteriores. Por eso un mensaje breve al final de un chat largo puede consumir más entrada que un primer mensaje extenso.
Cálculo con la tarifa publicada de Claude Sonnet 5.5
El 3 de octubre de 2026, Anthropic publica para Claude Sonnet 5.5 un precio base de 2 USD por millón de tokens de entrada y 10 USD de salida. Los 1.200 tokens de entrada y 300 de salida son un supuesto de cálculo, no una llamada API medida. No incluye caché, Batch API, herramientas, impuestos ni otros recargos.
| Categoría | Tokens | Cálculo | Coste, USD |
|---|---|---|---|
| Entrada | 1 200 | 1 200 × 2 / 1 000 000 | 0.0024 |
| Salida | 300 | 300 × 10 / 1 000 000 | 0.0030 |
| Total | 1 500 | 0.0024 + 0.0030 | 0.0054 |
Con ese volumen, 1.000 solicitudes costarían 5,40 USD y tres intentos idénticos 0,0162 USD. Es un cálculo, no una factura. Como los intentos reales varían, suma los cargos según el campo usage de todas las llamadas, incluidas las fallidas.
Medir antes y después
- Cuenta toda la entrada con el contador del proveedor antes de enviarla.
- Cuando llegue la respuesta, consulta las estadísticas de consumo que devuelve la API, como los campos usage. Pedirle al modelo que diga cuántos tokens ha usado solo te dará una suposición.
- Contrasta cada categoría con la tarifa y los cargos. La respuesta visible puede no reflejar todo el uso.
- Agrupa las solicitudes por tarea para conocer el coste del resultado.
OpenAI ofrece un método para contar los tokens de entrada antes de enviar la solicitud. Gemini documenta ese recuento previo y las estadísticas que llegan con la respuesta. Revisa qué campos devuelve tu versión de la API.
Ahorrar sin perder lo importante
Elimina duplicados, versiones antiguas y fragmentos que no vienen al caso. Pide una salida concreta, por ejemplo cinco errores con citas en lugar de un resumen de todo. Las restricciones, las excepciones y las pruebas se quedan.
Para continuar una conversación larga en otro chat, prepara un resumen con las decisiones, las condiciones, las dudas pendientes y los enlaces a las fuentes. Compruébalo con la conversación original antes de usarlo. Si se pierde una condición importante, corregir el resultado puede costar más que los tokens ahorrados.
Compara cuánto cuesta llegar a un resultado que puedas dar por válido, con la revisión y las correcciones incluidas. Una llamada barata a la API deja mucho trabajo pendiente si después hay que rehacer la respuesta.