Token IA: contesto, limiti e costo di una richiesta
Neaptide · 6 settembre 2026 · 6 min di lettura · Aggiornato: 4 ottobre 2026
Token, contesto e costi dell’IA: calcolo con il listino ufficiale di Claude Sonnet 5.5, controllo dei consumi e modi per ridurli.
In questo articolo
Scrivi «correggi l’ultimo paragrafo» e il consumo sale. Può darsi che l’applicazione abbia inviato anche la conversazione, un documento e le proprie istruzioni. L’ultimo messaggio è solo una parte dell’input.
Un token non è una parola
Il modello lavora a token, sia quando legge l’input sia quando scrive l’output. In un testo un token può essere un carattere, un pezzo di parola o una parola intera. Un rapporto fisso non esiste, perché dipende da come il modello suddivide il testo. Per fare una stima usa un contatore adatto al modello scelto.
Che cosa deve rientrare nella finestra di contesto
La finestra di contesto limita il volume utilizzabile in una richiesta. OpenAI fa rientrare in questo budget input, output e, per alcuni modelli, token di ragionamento. I limiti da controllare sono due, quello di contesto e quello della risposta. E una finestra ampia non garantisce che ogni dettaglio venga interpretato correttamente.
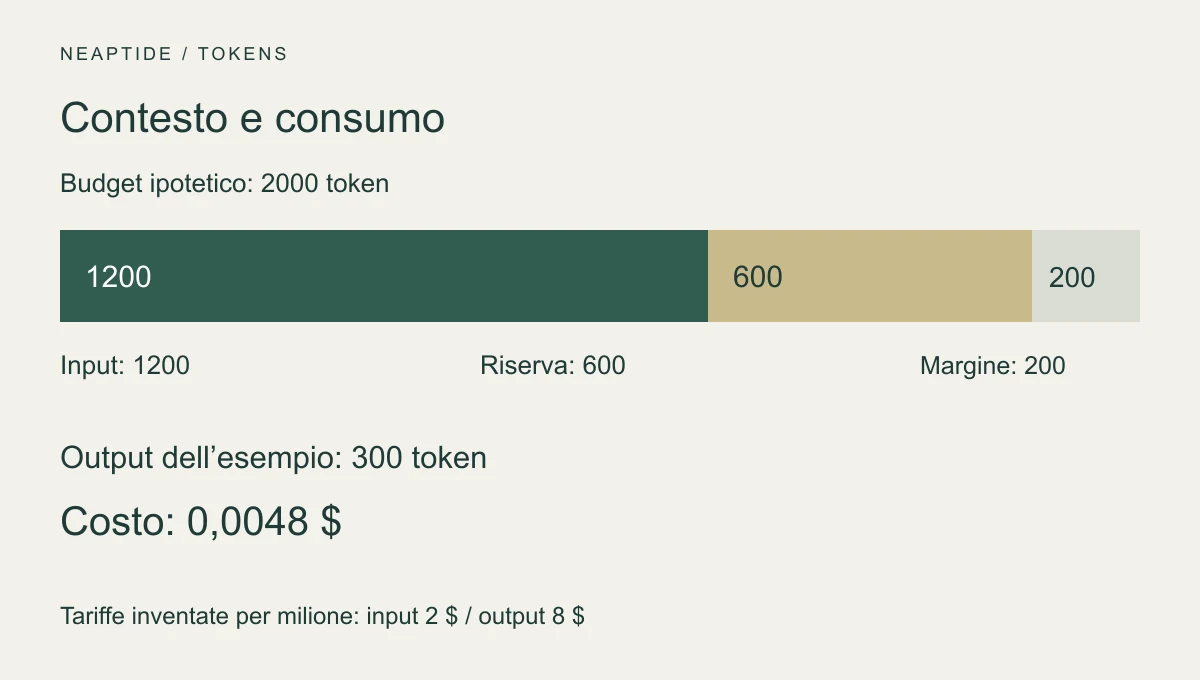
Riserviamo 600 token alla risposta. Se il modello ne genera 300, il consumo è 300 e non i 600 previsti. Con un’API reale vanno considerate anche le regole per il ragionamento e per le altre categorie.
Che cosa contiene l’input oltre al messaggio
- Istruzioni dell’applicazione e cronologia trasmessa.
- Documenti, passaggi recuperati e risultati degli strumenti.
- Immagini e altri dati, secondo le regole del fornitore.
A decidere cosa inviare è l’applicazione. OpenAI precisa che usare previous_response_id non rende gratuiti i token di input precedenti. Una replica breve può quindi richiedere più input di un lungo messaggio iniziale.
Calcolo con il listino di Claude Sonnet 5.5
Al 3 ottobre 2026, Anthropic indica per Claude Sonnet 5.5 un prezzo base di 2 USD per milione di token in ingresso e 10 USD in uscita. I 1.200 token in ingresso e 300 in uscita sono un’ipotesi di calcolo, non una chiamata API misurata. Sono esclusi cache, Batch API, strumenti, imposte e altri supplementi.
| Categoria | Token | Calcolo | Costo, USD |
|---|---|---|---|
| Ingresso | 1 200 | 1 200 × 2 / 1 000 000 | 0.0024 |
| Uscita | 300 | 300 × 10 / 1 000 000 | 0.0030 |
| Totale | 1 500 | 0.0024 + 0.0030 | 0.0054 |
Con questo volume, 1.000 richieste costerebbero 5,40 USD e tre tentativi identici 0,0162 USD. È un calcolo, non una fattura. I tentativi reali variano: somma i costi indicati da usage per tutte le chiamate, comprese quelle fallite.
Misurare prima e dopo
- Prima dell’invio conta l’input completo con lo strumento del fornitore.
- Dopo la risposta, leggi i dati sui consumi restituiti dall’API, come i campi usage. Chiedere al modello quanti token ha usato serve a poco: tirerebbe a indovinare.
- Confronta le categorie con il tariffario e gli addebiti. Il testo visibile potrebbe non rappresentare tutto il consumo.
- Raggruppa le chiamate per attività per sapere quanto costa il risultato.
OpenAI mette a disposizione una funzione dell’API che conta i token di input prima dell’invio. Anche la documentazione di Gemini descrive il conteggio preliminare, oltre ai dati di consumo restituiti con la risposta. Controlla quali campi offre la tua versione dell’API e che cosa comprendono.
Ridurre gli sprechi senza perdere le istruzioni
Elimina duplicati, versioni superate e passaggi estranei al compito. Chiedi un risultato preciso, per esempio cinque errori con citazioni al posto di un riassunto completo. Vincoli, eccezioni e fonti restano dove sono.
Per continuare una conversazione lunga in una nuova chat, prepara una sintesi di decisioni, vincoli, domande aperte e link alle fonti. Confrontala con la conversazione originale prima di usarla. Se manca una condizione importante, correggere il risultato può costare più di quanto hai risparmiato riducendo l’input.
Valuta quanto costa arrivare a un risultato approvato, tempo di verifica e correzione compreso. Una chiamata API economica lascia molto lavoro manuale se poi la risposta va rifatta.