Next.js 元数据出现在 body:九种条件实测
Neaptide · 2026年10月12日 · 8 分钟阅读
在 Next.js 15.5.22 上测试九种条件,对照原始 HTML、浏览器 DOM 与 canonical 位置,说明结果及其 SEO 判断边界。
本文目录
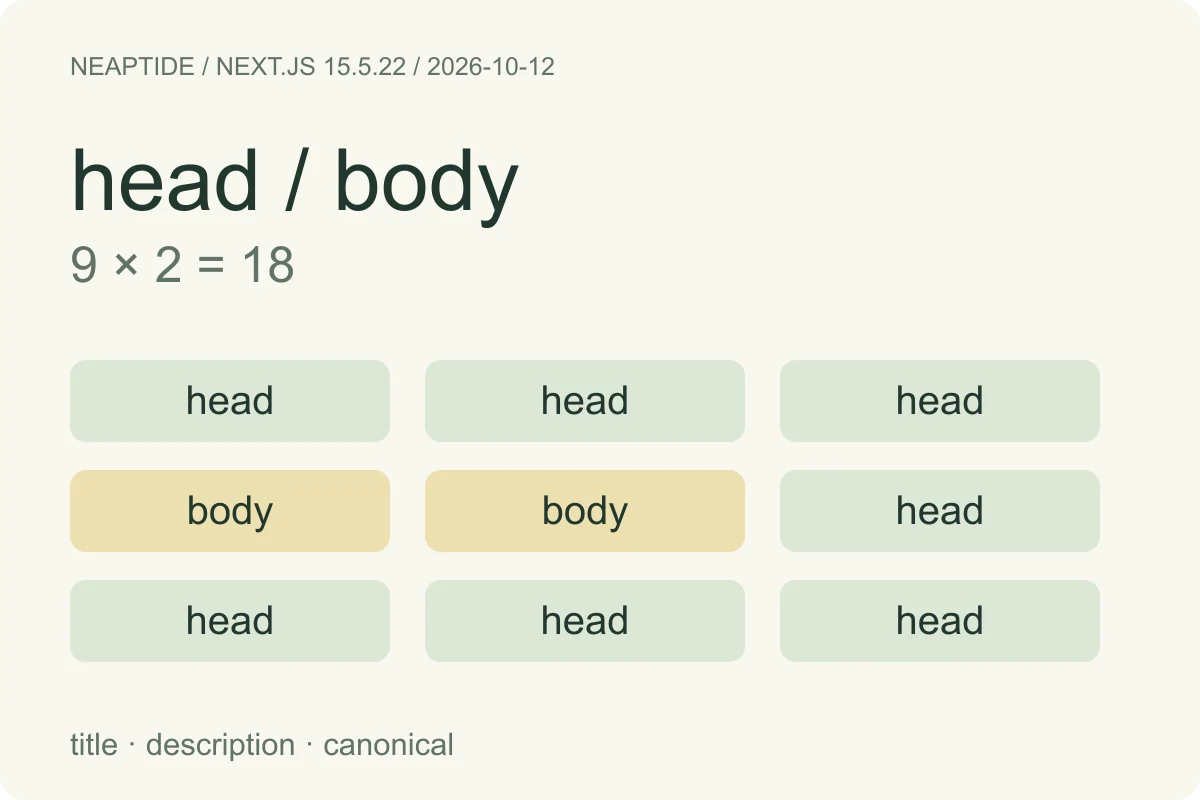
在 head 结束标签之后看到元数据,可能是 Next.js 流式输出的结果。在我们的本地生产构建中,异步元数据对两种请求配置出现在 body,对另一种出现在 head。所有完整响应都包含正确的值,但这并不能证明搜索引擎接受每一种标签的这个位置。
先确认要检查的标签、请求配置,以及您看到的是哪一种文档表示。本次实验解释元数据如何送达。对于 canonical,还要遵循 Google 对 head 位置的要求;仅在文档某处找到正确 URL,不足以判定实现正确。
我们如何测试
2026 年 10 月 12 日,我们测试了 Next.js 15.5.22、React 与 React DOM 19.2.6,以及 Node v25.2.1。三种模式与三种 HTTP User-Agent 配置组成九种条件,每种运行两次,保存了 18 份完整的 HTTP 200 响应、响应头与 HTML。两轮的标签数量、值与位置一致。
三种模式分别为静态 metadata 对象、默认配置下的异步 generateMetadata,以及设置 htmlLimitedBots: /.*/ 后的同一个异步函数。两个路由都使用 force-dynamic,因此“静态”指元数据的声明方式,不代表预渲染页面。异步函数人为等待 250 毫秒,不发起外部请求。这是为了观察输出顺序,不能代表实际负载或性能得分。
请求配置改变了 HTML 中的标签位置

| 元数据模式 | 浏览器式 UA | Googlebot UA | Twitterbot UA |
|---|---|---|---|
| 静态对象 · 默认 | head | head | head |
| 异步函数 · 默认 | body | body | head |
| 异步函数 · 阻塞 | head | head | head |
采集器使用类似 Chrome 134 的字符串、Googlebot/2.1 或 Twitterbot/1.0。这些只是请求头的值,并非相应服务的真实访问。所有请求均使用 Accept: text/html 与 Accept-Encoding: identity,不带 cookie 或客户端导航请求头。完整字符串与请求记录可下载。
浏览器中的默认异步标签仍留在 body
我们另外在已连接的浏览器中打开了三种模式。服务器接收到的 User-Agent 显示 Chrome 154。在渲染后的 DOM 中,静态与阻塞模式的 title、description 和 canonical 位于 head;默认异步模式则仍位于 body,没有观察到移入 head。这三次浏览器加载与 18 次 HTTP 请求是独立记录,也不是 Googlebot 渲染测试。
| 模式 | DOM:三个标签的位置 |
|---|---|
| 静态对象 · 默认 | head |
| 异步函数 · 默认 | body |
| 异步函数 · 阻塞 | head |
canonical 需要单独判断
Next.js 文档说明,流式元数据可输出到 body,对 HTML 处理能力有限的机器人则采用阻塞输出。这解释了本次复现的模式。但 Google 的 canonical 文档要求 HTML canonical 链接位于 head;其 JavaScript 示例也将链接插入 document.head。框架的一般说明无法代替这一标签的具体要求。
在默认异步条件下,我们的 canonical 在响应与 DOM 中均留在 body。不能据此断言 Google 接受或拒绝了它:测试仅在本地运行,使用 noindex,也没有提交索引。应继续检查实际部署的路由。如果 canonical 仍在 head 之外,应采用符合 Google 文档位置要求的实现,再复查结果。下方阻塞配置在本实验中实现了 head 位置;它是一个经过测试的选项,不是排名提升的证据。
如何检查自己的路由
- 保存线上目标 URL 的完整响应、请求头和部署版本。检查真实的 title、description 与 canonical 元素;React 脚本中的字符串不等于额外的 HTML 标签。
- 另行检查渲染后的 DOM,记录值、重复元素以及其所属的 head 或 body。浏览器标签页标题正确,并不能说明 canonical 正确。
- 对比与问题相关的请求配置。区分普通浏览器、替换机器人字符串的请求,以及外部服务的真实请求。修改 User-Agent 只能测试服务器如何选择响应。
- 按具体标签的要求判断。对于 canonical,使用可用的 Google 工具和规范网址报告检查线上页面,同时确保 HTML 链接位于 head。本地 DOM 不能揭示 Google 选择了哪个 canonical。
- 修改必要的实现部分,重新构建并重复相同检查。如果调整元数据流式输出,还应使用真实负载评估加载行为;实验中的人为延迟不能估算线上性能。
实际测试过的配置
第三种模式通过以下选项重新构建同一应用。所有测试请求配置下,三个标签均位于 head。该选项会替换默认的机器人匹配规则;/.*/ 匹配所有 User-Agent。实际采用前应保留其余配置,并确认变更范围。
// next.config.mjs
export default {
  htmlLimitedBots: /.*/,
};
这个选项会影响整个应用的元数据输出。我们没有测试仅匹配特定机器人的正则表达式、线上缓存或路由间导航。本实验不构成让所有网站改用阻塞输出的理由。
复现实验
下载测试应用与依赖锁文件。README 提供两种配置的构建和启动命令,以及 Python 采集器的运行方法。在两个独立终端启动服务器,再从解压目录的根目录运行采集器。测试包含人为延迟、noindex 和 example.test 规范网址,仅用于本地运行。证据压缩包保存原始 HTML 与 DOM 快照;results.json 包含完整请求配置与解析后的观察记录。
查看实验记录
实验覆盖一个版本、两个本地构建和三次浏览器加载。未测试 CDN、真实远程爬虫、客户端导航、元数据失败路径或 Cache Components;也未测量索引、排名、AI 引用、流量、转化或 Core Web Vitals。数据由同一研究者采集并复核。请在自己的版本与部署环境中重新验证。