Jev: come funziona un’IA progettata per decidere in fretta
Neaptide · 27 settembre 2026 · 12 min di lettura · Aggiornato: 3 ottobre 2026
Come funziona Jev: Choice, Score, Noul, probabilità e limiti. System One, dati pubblicati e come provare il modello sui tuoi compiti.
In questo articolo
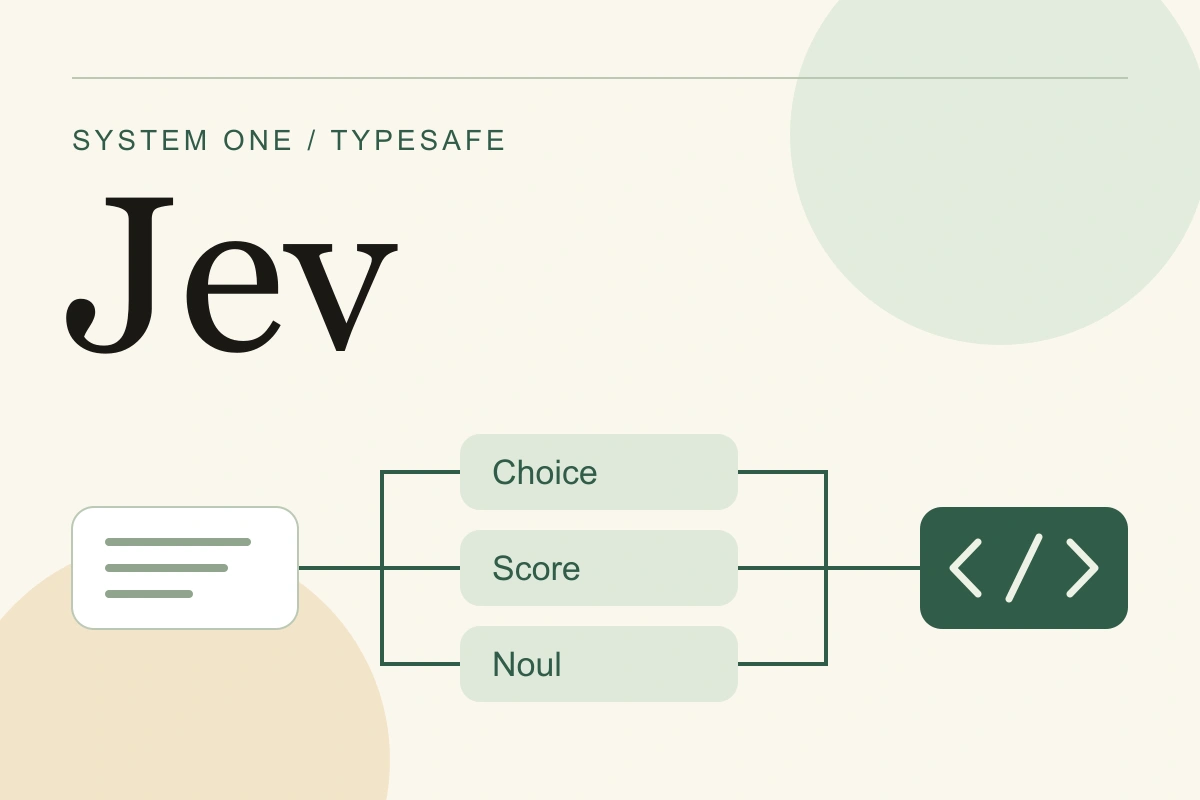
Un cliente scrive: «Non riesco a esportare il catalogo. Il CSV funziona, l’XLSX no. Devo inviare il file a un fornitore entro stasera». L’applicazione deve capire di che cosa parla la richiesta, quanto pesa il problema e che cosa fare dopo. Una risposta lunga del modello qui non aiuta. Al sistema servono pochi valori precisi.
Jev è il modello di TypeSafe pensato per queste valutazioni. Riceve un contesto e domande con tipi di risposta definiti e restituisce valori e probabilità che il software può usare così come sono. TypeSafe chiama questo approccio System One. Il modello non scrive email né codice e non spiega il proprio ragionamento.
Nell’annuncio del 15 settembre 2026 l’azienda ha aperto l’accesso anticipato puntando sulla rapidità e sul basso costo delle decisioni. Per capire quanto vale Jev in pratica conviene seguire l’intero percorso, dalla domanda al modello fino all’azione dell’applicazione.
Dove si inserisce Jev in un’applicazione
Una richiesta contiene state, il materiale da valutare, e questions, le domande su quel materiale. Il contesto può essere un messaggio, un oggetto JSON con i campi di un ticket o un array di dati testuali. Tutte le domande di una chiamata vedono lo stesso contesto e vengono valutate in modo indipendente. Jev accetta solo testo, quindi immagini e audio vanno prima convertiti in testo o nei campi che servono.

In questo esempio puoi chiedere separatamente quale reparto serva al cliente, quanto il problema ostacoli il lavoro e se il cliente voglia parlare con una persona. La regola che invia i ticket tecnici alla coda corretta rimane nel codice. Se il processo di assistenza cambia, lo sviluppatore modifica quella regola e lascia stare le domande.
La suddivisione è utile già di per sé. Chiedere «che cosa dobbiamo fare per questo cliente?» mescola comprensione del testo, priorità aziendali e azioni consentite. Con domande circoscritte si vede in quale punto il sistema ha sbagliato. È l’organizzazione del lavoro che consiglia la documentazione di TypeSafe.
Tre tipi di domanda, tre significati
Jev offre tre tipi fondamentali di domanda: Choice, Score e Noul. Quale usare dipende da ciò che il programma deve sapere.

Choice è adatto quando serve una sola opzione da un insieme definito, per esempio technical, billing oppure other. La risposta comprende l’opzione scelta, una distribuzione di probabilità e confidence. Scrivi le descrizioni delle categorie in modo che si possano distinguere l’una dall’altra.
Score serve per una scala ordinata. Per valutare l’impatto di un problema puoi descrivere i livelli come «non ostacola il lavoro», «lo ostacola, ma esiste una soluzione alternativa» e «il lavoro è bloccato». Il risultato può cadere tra due livelli, perché è la media dei loro indici ponderata con le probabilità. Un valore di 1,4 su una scala da 0 a 2 non significa che il 70% degli utenti sia coinvolto.
Noul valuta una singola domanda con risposta sì o no: per esempio, «Il cliente chiede esplicitamente di parlare con una persona?». Un numero tra 0 e 1 esprime la probabilità di «sì». Vicino a 0,5 indica incertezza, non una «richiesta moderata». Noul non ha un campo confidence separato.
Per verificare una formulazione, chiediti se un collega saprebbe distinguere le opzioni senza farsele spiegare a voce da chi le ha scritte. Se la risposta è no, chiarisci prima categorie e livelli. Il modello non scioglierà al posto dello sviluppatore l’ambiguità di una regola aziendale.
Che cosa copre la promessa «senza allucinazioni»
Nell’annuncio TypeSafe collega l’assenza di allucinazioni a uno spazio di risposta limitato: il modello restituisce solo valori ammessi dalla struttura. Questo risolve un problema preciso, quello di una risposta arbitraria dove il programma si aspetta un determinato tipo.

Supponiamo che i reparti siano tre. Sceglierne uno che esiste non dimostra che il ticket sia arrivato alla squadra giusta. Una garanzia sul formato non dice se il testo è stato capito bene, e il rispetto dello schema non dimostra nemmeno che l’azione aziendale fosse quella corretta.
Non basta nemmeno confrontare Jev con un modello di chat a cui si chiede di «restituire JSON». Lo stesso adattatore di TypeSafe supporta le modalità native di output strutturato dei LLM. In un progetto reale confronta integrazioni complete: qualità delle decisioni, latenza, costo e gestione degli errori.
Le probabilità servono se il programma sa usarle
Immagina due risposte Choice che scelgono entrambe l’assistenza tecnica. Nella prima quell’opzione raccoglie quasi tutta la probabilità. Nella seconda le altre due la seguono da vicino. Dal solo nome del reparto scelto questa differenza non si vede.

Per Choice e Score, confidence viene calcolato dalla forma della distribuzione di probabilità. Non leggerlo come «la probabilità che questa risposta sia corretta». TypeSafe propone di usarlo per decidere come proseguire, con soglie adatte al compito.
La calibrazione è un concetto distinto. Se un modello ben calibrato assegna probabilità 0,8 a un evento in un ampio insieme di previsioni comparabili, quell’evento dovrebbe verificarsi in circa l’80% dei casi. È una proprietà dell’insieme di previsioni e non promette una risposta corretta in ogni singolo caso. Secondo TypeSafe, il metodo RLCD (Reinforcement Learning for Calibrated Decisions) serve ad addestrare queste probabilità.
In pratica, stabilisci in anticipo un percorso per i ticket ambigui. Una scelta netta del reparto può consentire l’instradamento automatico, mentre una distribuzione più dispersa manda il ticket a una coda di verifica generale. La soglia dipende dal costo di un invio errato e dai risultati delle prove sui tuoi messaggi.
Come leggere le cifre su velocità e costi
I numeri pubblicati bastano per una prima valutazione, ma non poggiano tutti sulla stessa base. Il prezzo nella documentazione è una tariffa. Il tempo di risposta è stato misurato in determinate condizioni. Un vantaggio su un insieme di test nasce dal confronto con alternative selezionate.
| Indicatore | Che cosa è stato pubblicato | Come usarlo |
|---|---|---|
| Tempo di risposta | L’annuncio indica 70–500 ms; le valutazioni venivano generalmente eseguite dalla costa occidentale degli Stati Uniti, dove si trovava il servizio | Misura la latenza dalla regione della tua applicazione, comprese le risposte lente |
| Prezzo di Jev 1.13 | 0,042 USD per milione di token in ingresso; i token in uscita sono gratuiti | Calcola l’intero input, includendo contesto e domande |
| Qualità dei workflow | Quattro scenari: incidenti di sicurezza, osservabilità degli agenti, elaborazione delle fatture e assistenza clienti | Esamina il metodo e prova i tuoi scenari |
Fonti: condizioni di misura nell’annuncio, modelli e prezzi, Workflow evals. Verificate il 3 ottobre 2026.
Workflow evals costruisce il riferimento con la media delle risposte di GPT-6 Astra e Claude Fable 5.1 a un livello di ragionamento elevato; gli altri partecipanti usano le impostazioni predefinite del proprio fornitore. Il risultato misura quindi la concordanza con un riferimento prodotto da modelli, all’interno di un processo definito. Non è la stessa cosa dell’accuratezza rispetto a esiti reali etichettati in modo indipendente.
Per farsi un’idea dell’ordine di grandezza, prendiamo un calcolo illustrativo: un milione di chiamate da mille token in ingresso ciascuna fa un miliardo di token, cioè 42 USD alla tariffa pubblicata. In quei mille token devono stare sia il contesto sia le domande. Restano fuori dal calcolo nuovi tentativi, altri modelli, infrastruttura e revisione umana.
Nella scelta di un sistema è più utile guardare il costo per ticket gestito correttamente. Una chiamata economica serve a poco se una persona deve correggere una parte consistente dei risultati.
Dove è utile Jev e dove serve un altro strumento
Le decisioni ripetitive su un testo sono il punto di partenza naturale: riconoscere il tema di una richiesta, valutare la corrispondenza con una descrizione, scegliere una categoria. Il passo successivo dipende da ciò che il sistema deve fare del risultato.

Nel caso dell’errore di esportazione, Jev può valutare il contenuto del reclamo. Verificare la disponibilità del servizio, calcolare la scadenza prevista dallo SLA e cambiare lo stato del ticket rimangono normali operazioni software. L’email al cliente si può comporre da un modello di testo o far scrivere a un’IA generativa, a cui vanno passati i fatti verificati e l’azione scelta.
Questa ripartizione rispecchia i limiti di Jev 1.13 descritti dalla stessa TypeSafe. Il modello non è affidabile nei conteggi precisi e nel confronto tra date, e le informazioni irrilevanti in un contesto lungo peggiorano le risposte. Un testo costruito apposta può influenzare la classificazione. Lo sviluppatore consiglia di tenere i calcoli nel codice, togliere il contesto irrilevante e provare i casi difficili.
Per un prodotto in italiano, prepara un insieme di test in italiano. La documentazione indica l’inglese come lingua principale di addestramento e come quella in cui oggi l’accuratezza è migliore; nelle altre lingue le prestazioni possono variare. Conta ancora di più se i ticket contengono abbreviazioni, refusi e terminologia specialistica.
Come avviare una prova nel tuo prodotto
Scegli una decisione frequente con un esito corretto ben definito, per esempio l’assegnazione dei ticket ai reparti. Tieni il processo attuale come riferimento. Etichetta esempi reali e anonimizzati, compresi quelli ambigui, e separa i dati usati per la messa a punto dall’insieme di valutazione finale.

Osserva insieme la quota di ticket gestiti automaticamente e il tasso di errore all’interno di quella quota. Una soglia che manda quasi tutto a una persona può dare un’ottima accuratezza senza automatizzare granché. Una soglia più permissiva va valutata tenendo conto del costo delle correzioni.
Aggiungi la latenza p95 (il tempo entro cui termina il 95% delle richieste misurate), la spesa per il modello e il carico di lavoro manuale. Confronta Jev con il processo attuale e con un LLM adatto sugli stessi esempi. L’adattatore di TypeSafe può restituire probabilità o decisioni discrete, quindi scegli condizioni di confronto coerenti con le esigenze effettive dell’applicazione.
Conserva la versione del modello, le domande e le soglie insieme ai risultati. L’alias jev-latest può passare a una nuova versione; per questo la documentazione consiglia di fissare un identificativo preciso quando il comportamento è già stato messo a punto per quella versione.
L’idea tecnica di Jev è chiara: trasformare una valutazione del significato in un passaggio piccolo e osservabile di un programma. Provala dove questi passaggi sono frequenti e il gruppo di lavoro sa dire con precisione che cosa conta come errore. La prova mostrerà allora quali decisioni si possono automatizzare e quanta incertezza resta fuori da quell’automazione.
Articolo basato su fonti primarie pubbliche verificate il 3 ottobre 2026. Esempi e schemi hanno scopo illustrativo. Non abbiamo effettuato chiamate API né prove indipendenti di Jev.