Quelle mémoire pour un modèle de langage local ? RAM, VRAM et contexte
Neaptide · 20 septembre 2026 · 10 min de lecture · Mis à jour: 4 octobre 2026
Estimez la mémoire d'un modèle de langage local : poids, quantification, cache KV, RAM et VRAM, avec formules et méthode de mesure.
Dans cet article
Le fichier du modèle pèse 4 Go, la machine dispose de 8 Go de mémoire libre, et pourtant rien ne démarre. Les poids ne sont que le début du calcul. Il faut compter à part le cache KV, les buffers de travail et les autres applications, puis tester votre tâche avec le moteur choisi.
Précisez d’abord le modèle et sa quantification, la longueur de contexte nécessaire et le nombre de requêtes simultanées. Sans ces éléments, la question de la RAM reste trop vague pour qu’on y réponde.
Ce qui occupe la mémoire
| Élément | Principaux facteurs |
|---|---|
| Poids du modèle | Nombre de paramètres et format |
| Cache KV | Architecture, contexte, précision du cache et nombre de séquences |
| Buffers de travail | Moteur et paramètres de lancement |
| Autres applications | Système, éditeur, navigateur et processus en arrière-plan |
Le cache KV conserve des données intermédiaires d’attention pour éviter de tout recalculer à chaque nouveau token. La façon dont il est géré joue sur la consommation de mémoire.
En pratique, un même modèle peut demander nettement plus de mémoire avec un contexte long qu'avec un contexte court.
Ne comblez pas les postes inconnus par une marge inventée de « 20 % pour le reste ». Mesurez la mémoire avant le chargement, après celui-ci et pendant une requête au contexte voulu. Ces trois points montrent où la consommation augmente, sans la répartir précisément entre les buffers internes du moteur.

Estimer la mémoire des poids
Une première approximation :
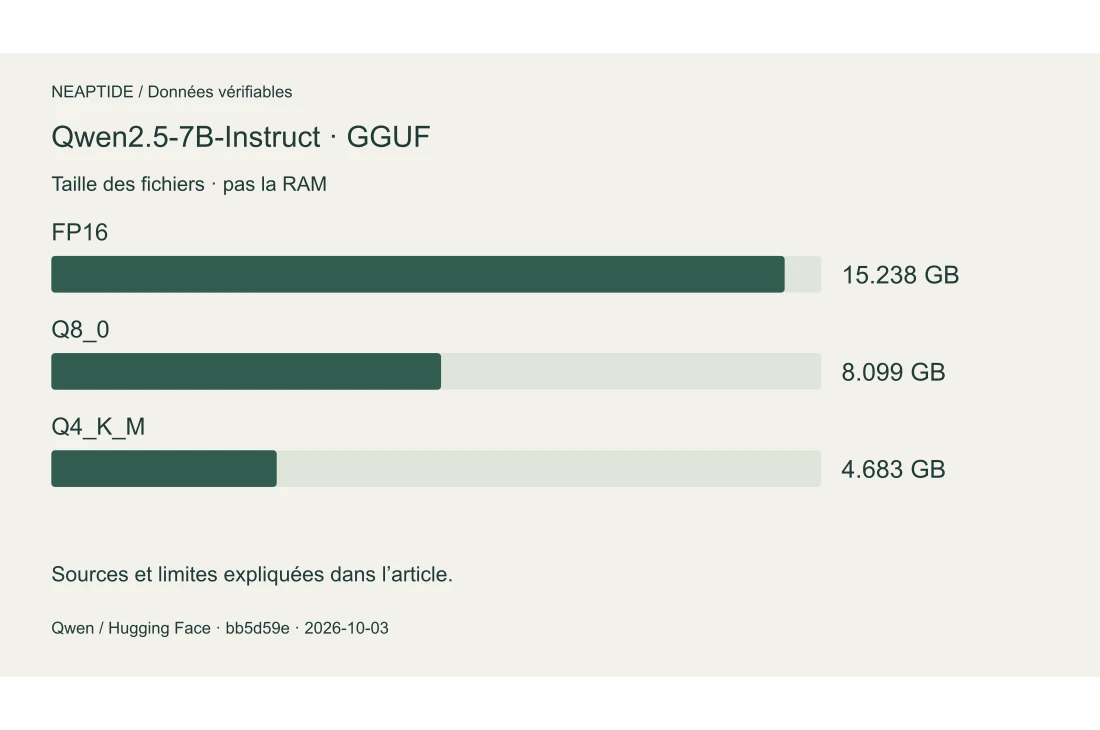
octets des poids ≈ nombre de paramètres × bits par paramètre / 8Prenons les fichiers réels Qwen2.5-7B-Instruct-GGUF du dépôt officiel Qwen. Le 3 octobre 2026, nous avons récupéré les tailles via l’API Hugging Face et additionné toutes les parties de chaque format à la révision bb5d59e06d9551d752d08b292a50eb208b07ab1f. Les poids n’ont pas été téléchargés et le modèle n’a pas été exécuté.
| Format | Parties | Octets au total | GB |
|---|---|---|---|
| FP16 | 4 | 15 237 853 536 | 15.238 |
| Q8_0 | 3 | 8 098 525 408 | 8.099 |
| Q4_K_M | 2 | 4 683 073 632 | 4.683 |
Q4_K_M ne signifie pas quatre bits exactement pour chaque paramètre. Ces tailles comprennent métadonnées, empaquetage et tenseurs de précisions différentes. Les fichiers Q4_K_M totalisent 4,683 GB, contre 3,5 GB dans le calcul simplifié pour sept milliards de paramètres.
Divisez les octets par 1 073 741 824 pour obtenir des GiB, ou par un milliard pour des GB. Il faut ajouter aux fichiers le cache KV, les buffers de travail et les autres programmes pour estimer la RAM ou la VRAM.
FP16, Q8_0 et Q4_K_M concernent le même modèle et la même révision. Les parties sont des fragments de téléchargement : il les faut toutes pour le format choisi.
RAM et VRAM : la différence
La RAM est la mémoire système ; la VRAM est celle du GPU dédié. L’emplacement du modèle dépend du matériel et du moteur. Avec une mémoire unifiée, CPU et GPU puisent dans la même ressource, dont le système d’exploitation a lui aussi besoin.
On ne peut pas additionner 16 Go de RAM et 8 Go de VRAM et tenir le total pour l’équivalent d’une carte graphique de 24 Go. La répartition du travail et le coût des transferts dépendent de la configuration.
Dans Ollama, ollama ps affiche la répartition du modèle chargé entre CPU et GPU.
L'effet du contexte
Pour un cache KV complet classique, l'estimation est :
octets du cache ≈ 2 × couches × têtes KV × dimension d'une tête
                  × tokens × octets par élément × séquences
Le facteur 2 représente les clés et les valeurs. Cette approximation vaut pour les architectures concernées, pas pour toutes les LLM. L’attention glissante, la compression et d’autres implémentations modifient le calcul.
Comparez donc les configurations avec le même contexte paramétré. Si l’une reçoit une petite fonction et l’autre tout un dépôt, l’écart de mémoire ne prouve pas grand-chose.
Ollama permet de régler la longueur du contexte ; l’augmenter demande davantage de mémoire. Vérifiez la répartition et le contexte actuels avec ollama ps.
Prenons une architecture pédagogique : 32 couches, 8 têtes KV, une dimension de tête de 128 et 2 octets par élément du cache. Le cache complet d’une séquence de 4 096 tokens occupe 0,5 GiB ; à 16 384 tokens, il en faut 2. Quatre séquences de cette longueur demandent 8 GiB de cache. Dans le calculateur ci-dessous, les poids sont partagés et le cache augmente avec le contexte et le nombre de requêtes simultanées.

L’effet du contexte sur la mémoire
Modèle pédagogique : 7B, poids à 4 bits ; cache KV complet : 32 couches, 8 têtes KV, dimension 128, 2 octets par élément. Les séquences partagent les poids.
- Poids bruts
- 3,26 GiB
- Cache KV
- 0,5 GiB
- Poids + cache
- 3,76 GiB
Hors système, buffers du moteur et métadonnées de quantification. Ce résultat ne prédit pas la RAM ou la VRAM totale. Une autre architecture exige un autre calcul.
Modifiez le contexte ou la concurrence : la taille des poids reste identique.
Tester votre ordinateur
Notez le modèle, son tag exact, la quantification, le moteur et sa version. Exécutez la même tâche avec une entrée courte, puis plus longue. Consignez :
- Le contexte configuré et les requêtes simultanées.
- La mémoire occupée avant et pendant l'exécution.
- Le placement CPU/GPU.
- Le délai avant la première réponse et la durée totale.
- La qualité selon des critères définis à l'avance.
Répétez l’essai pour distinguer le chargement du régime établi. Si la mémoire vient à manquer, réduisez un seul paramètre à la fois.
Que tenter avec 16 ou 32 Go ?
Aucune liste de configurations garanties ne vaut indépendamment du matériel. Avec peu de mémoire, commencez par un petit modèle quantifié et une tâche courte, comme dans le guide Ollama. Gardez une marge pour le système et les applications.
Choisissez selon votre tâche : un contexte suffisant, un délai acceptable et pas de saturation lors des essais répétés. Conservez le tag du modèle et les paramètres de mesure. L’achat de mémoire ou d’un GPU répondra alors à une limite observée, et non à la taille du fichier.
Sources et vérification
Sources techniques et calculs vérifiés le 3 octobre 2026. Les scénarios et schémas sont des exemples pédagogiques de Neaptide ; aucun benchmark comparatif des produits n’a été réalisé.