Bien configurer Astra dans Codex pour éviter de gaspiller son quota
Neaptide · 20 septembre 2026 · 13 min de lecture · Mis à jour: 3 octobre 2026
Choisir le niveau de raisonnement d’Astra, revoir les consignes du projet et cadrer les tâches dans Codex. Exemples de prompts, contexte et suivi de consommation.
Dans cet article
Codex a modifié le formulaire, mais le nom de l’entreprise n’apparaît pas dans l’e-mail reçu. Avant d’augmenter l’effort de raisonnement, vérifiez si l’agent connaissait cette exigence et pouvait contrôler la livraison. Pour configurer Astra, on commence par délimiter la tâche et par décider comment le résultat sera accepté.
Avant de changer de modèle, examinez les consignes. D’anciennes règles, une demande trop large ou des critères de fin mal définis peuvent expliquer ce détour. Un modèle plus performant a lui aussi besoin d’une demande précise.
Trois ajustements suffisent pour commencer. Adaptez l’effort de raisonnement à la tâche. Supprimez les étapes obligatoires qui ne lui servent pas. Décrivez un résultat vérifiable. Comparez ensuite, sur vos propres projets, la consommation et le nombre de reprises.
Cet article s’appuie sur la présentation de GPT-6 Astra publiée par Edvard Grishin sur sa chaîne consacrée à l’IA et à l’automatisation des entreprises. La vidéo est en russe. Nous en avons retenu des questions pratiques et avons vérifié les détails techniques dans la documentation d’OpenAI. Les exemples ci-dessous sont pédagogiques. Aucun ne provient d’un projet mené pour un client de Neaptide.
- présentation de GPT-6 Astra
- Edvard Grishin sur sa chaîne consacrée à l’IA et à l’automatisation des entreprises
Distinguez le modèle de son environnement de travail
Astra est le modèle. Codex est l’environnement qui lui donne accès aux fichiers et aux outils. La possibilité d’ouvrir un site, de modifier un projet ou de lancer une vérification dépend de cet environnement, de ses réglages et des autorisations accordées.
Un conseil valable pour l’API n’a donc pas toujours son équivalent dans l’application. Et la fenêtre de contexte annoncée pour le modèle ne dit pas ce dont vous disposez réellement dans votre session.
Si vous débutez, consultez d’abord notre guide de prise en main de Codex. Notre présentation de GPT-6 Astra détaille ses capacités et les benchmarks publiés. Nous nous concentrons ici sur le travail quotidien.
Adaptez l’effort de raisonnement à la difficulté
L’API d’Astra propose cinq valeurs pour reasoning.effort : low, medium, high, xhigh et max. Ce réglage détermine l’effort consacré au raisonnement. Les commandes disponibles peuvent varier selon l’interface. Source : fiche du modèle OpenAI.
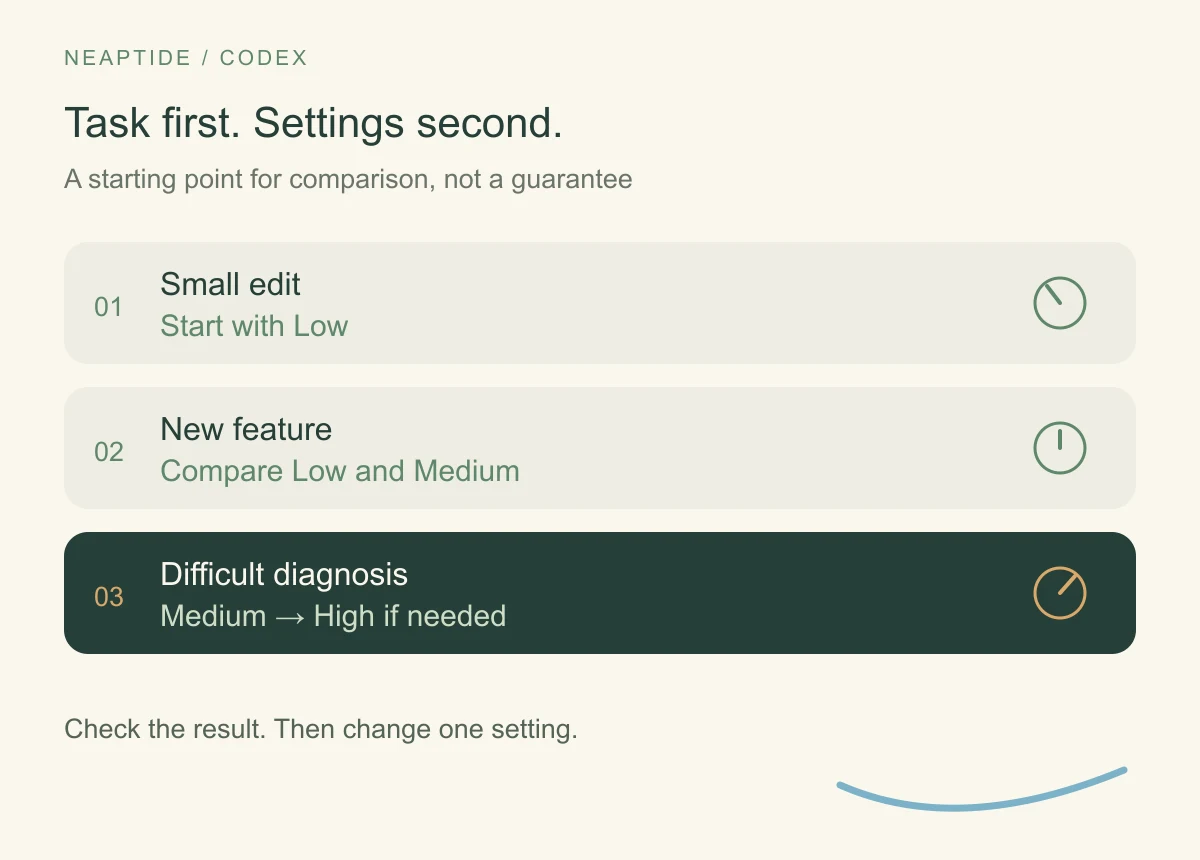
Inutile de choisir le maximum à chaque demande. Faites d’abord des essais sur des tâches familières dont vous savez évaluer le résultat. Le tableau suivant propose des points de départ, sans garantir un niveau de qualité.
| Tâche | Réglage à essayer | Résultat à vérifier |
|---|---|---|
| Corriger une coquille ou remplacer un texte validé | Low | Toutes les occurrences prévues sont modifiées, sans dégrader la mise en page |
| Ajouter un champ à un formulaire existant | Low ou Medium | La validation, l’envoi et l’enregistrement fonctionnent |
| Trouver l’origine d’un bug intermittent | Medium, puis High si nécessaire | La cause est reproductible et la correction a été vérifiée |
| Préparer une migration de données | Inclure High dans la comparaison | Le plan couvre les pertes de données, la compatibilité et le retour arrière ; un spécialiste le relit |
Low n’est pas forcément moins cher à l’arrivée. Trois séries de corrections après le premier résultat, et l’économie initiale a disparu. Un effort élevé ne dispense pas non plus de vérifier : un raisonnement plus long ne prouve pas qu’une réponse est juste.
Comparez le coût d’une tâche terminée et acceptée. Comptez le temps d’attente, la consommation et votre propre intervention : combien de fois avez-vous dû réexpliquer la demande, repérer une erreur ou demander une reprise ?
Après un essai infructueux, notez la cause. Si l’agent ignorait que le champ devait figurer dans l’e-mail, précisez le critère. S’il n’a pas trouvé le traitement de l’envoi, indiquez le fichier ou demandez une recherche. N’augmentez l’effort que si les informations sont là et que le raisonnement reste difficile. Ne changez qu’un facteur à la fois.

Repérez les anciennes règles qui ajoutent du travail inutile
Le projet peut contenir des consignes comme « lire toute l’architecture avant chaque modification » ou « effectuer toutes les vérifications après chaque changement ». Elles ont peut-être été utiles. Aujourd’hui, elles imposent le même travail pour une nouvelle intégration et pour un simple titre.
OpenAI recommande de revoir les instructions des fichiers AGENTS.md et des compétences utilisées avec Astra : le modèle y est sensible. Des règles contradictoires peuvent provoquer des arrêts ou des demandes de validation inutiles. Recommandations d’OpenAI pour Astra.
Une règle utile précise quand et pourquoi une action est nécessaire.
| Règle trop générale | Formulation plus précise pour un projet d’exemple |
|---|---|
| Lire toute la documentation avant chaque modification | Avant de modifier le formulaire, lire la documentation de ses champs et de son envoi |
| Toujours demander avant de passer à l’étape suivante | Effectuer les modifications et vérifications locales de manière autonome ; demander séparément l’accord pour publier |
| Lancer tous les tests après chaque changement | Après une modification du calcul des prix, vérifier ce calcul et la commande ; effectuer les contrôles obligatoires du projet avant la mise en ligne |
Ne supprimez pas les exigences de test au motif que le nouveau modèle « vérifie déjà tout ». Conservez les contrôles obligatoires et les restrictions d’accès. Revoyez surtout les règles qui imposent le même volume de travail à toutes les tâches.
Vous pouvez demander cet audit ainsi :
Examine les consignes actuelles du projet et les compétences utilisées.
Repère les répétitions, les contradictions et les exigences qui
ajoutent du travail inutile sur les petites tâches.

Pour chaque remarque, indique le fichier, la règle concernée,
un exemple du problème et une nouvelle formulation.
Conserve les exigences de sécurité, de gestion des données
et de vérification obligatoire.
Présente d’abord tes propositions, sans modifier les règles.
La concision a aussi une raison technique. Codex assemble des instructions provenant de plusieurs fichiers, avec une limite totale de 32 KiB par défaut. Si les règles sont nombreuses, vérifiez lesquelles ont réellement été chargées. Lecture des fichiers AGENTS.md par Codex.
Définissez ce qui permettra d’accepter le travail
« Rends le formulaire plus pratique » laisse beaucoup de décisions ouvertes. L’agent pourrait en revoir l’apparence alors que le vrai problème est ailleurs : les demandes n’arrivent pas à l’équipe commerciale.
Un dirigeant a plutôt intérêt à décrire le parcours du client et un résultat observable. Par exemple :
Ajoute un champ facultatif « Entreprise » au formulaire de la page service.
Sa valeur doit apparaître dans l’email envoyé à l’équipe commerciale.

Le travail est terminé lorsque :
1. Le formulaire s’envoie avec ce champ rempli ou vide.
2. L’email de test contient le nom d’entreprise saisi.
3. Le champ et le bouton tiennent dans la largeur d’un écran mobile.
4. Les champs obligatoires existants sont contrôlés comme auparavant.

Effectue les modifications et vérifications locales de façon autonome.
Utilise des données de test. Ne publie rien et n’envoie pas d’emails
à de vrais clients.
Présente le résultat, les points vérifiés et ceux qui n’ont pas pu l’être.
Nul besoin de dicter le code. On sait pourquoi le formulaire change et comment le travail sera accepté. Si le service d’envoi d’e-mails est inaccessible, l’agent doit le signaler. Un formulaire d’apparence correcte ne prouve pas qu’un message a été reçu.
Gardez cette structure comme modèle : tâche, comportement attendu, limites, vérifications et livrable. Les détails changeront d’une demande à l’autre.
Pour ce formulaire, il faut trois preuves distinctes : la valeur apparaît à l’écran, le serveur l’accepte et un destinataire de test reçoit l’e-mail qui la contient. Une réponse HTTP 200 ne valide qu’une étape. Si la dernière reste inaccessible, le compte rendu doit préciser ce qui n’a pas été vérifié.

Augmentez le contexte seulement si la tâche le justifie
Le contexte regroupe les informations utilisées par le modèle dans une requête : échanges, consignes, documents et résultats des outils. Une grande fenêtre est utile quand il faut vraiment comparer beaucoup de matière. Elle ne rend pas pertinents des fichiers sans rapport avec la tâche.
La fiche officielle d’Astra annonce une fenêtre de 1 050 000 tokens. Dans l’API, les requêtes dépassant 272 000 tokens en entrée sont facturées plus cher : les tarifs d’entrée et de cache sont multipliés par 2, ceux de sortie par 1,5, pour l’ensemble de la requête. Ces conditions valent pour l’API. Le quota d’un abonnement ne se calcule pas ainsi. Caractéristiques et tarification d’Astra.
Avant d’augmenter le contexte, triez les documents. Une modification de formulaire nécessite son code, ses règles de validation et son fonctionnement à l’envoi. D’anciennes propositions commerciales ou l’intégralité des notes du projet n’apporteront sans doute pas grand-chose.
Pour un travail réparti sur plusieurs jours, tenez un court document de suivi : décisions, fichiers modifiés, vérifications effectuées et tâches restantes. Dans une nouvelle session, joignez les sources à jour. Une synthèse ne remplace pas les documents qui fondent ses conclusions.
Réservez les sous-agents aux tâches qui peuvent être séparées
Un sous-agent est un assistant distinct auquel l’agent principal confie une partie du travail. Pour un audit de site, l’un peut examiner le formulaire, un autre la recherche dans le catalogue et un troisième le menu mobile. Chacun rapporte ses observations avec les étapes permettant de reproduire les problèmes.
OpenAI recommande de vérifier l’indépendance des tâches et d’être prudent lorsque plusieurs agents modifient des fichiers simultanément : leurs changements peuvent entrer en conflit. Chaque agent consomme aussi des tokens pour son propre travail. En multiplier le nombre ne garantit aucune économie. Documentation sur les sous-agents.
Plusieurs assistants se justifient difficilement pour une petite correction. Pour une vérification importante, donnez à chacun un périmètre et un résultat attendu. Au lieu de « vérifie le site », demandez « teste ces trois scénarios d’envoi du formulaire, liste les erreurs et les étapes de reproduction, sans modifier le code ».
Après avoir réuni les observations, vérifiez le parcours complet. Trois contrôles isolés réussis ne démontrent pas que l’ensemble fonctionne.
Un schéma de dépendances aide à répartir le travail. Le contrôle du menu peut avancer sans attendre celui de la recherche. Le parcours client complet, lui, ne se vérifie qu’une fois les modifications réunies. Deux assistants qui modifient le même traitement de formulaire ne travaillent plus indépendamment.

Suivez la consommation réelle
La vidéo propose d’exprimer le budget en langage courant. Cette consigne peut fixer une intention, mais « arrête-toi lorsqu’il reste 25 % » n’est pas un plafond garanti. Pour cela, il faudrait que l’agent dispose d’informations à jour sur la consommation et puisse s’arrêter à temps.
Dans Codex, la consommation dépend du modèle, de la difficulté, du contexte, des outils et du cache. OpenAI précise que la longueur du message ne suffit pas à l’estimer. Consultez l’interface de suivi pour connaître le quota restant et les dates de réinitialisation. Fonctionnement des limites de Codex.
Tenez un journal simple pour quelques tâches habituelles :
| Tâche | Modèle et effort | Consommation indiquée | Reprises | Résultat accepté |
|---|---|---|---|---|
| Remplacement d’un texte | … | … | … | Oui / non |
| Modification d’un formulaire | … | … | … | Oui / non |
| Recherche d’un bug | … | … | … | Oui / non |
Ce tableau est un modèle à remplir. Il ne contient aucune mesure de Neaptide. Si d’autres tâches tournent en parallèle, la baisse du quota total ne peut pas être attribuée entièrement à l’une d’elles. Avec l’API, conservez les statistiques par requête. Avec un abonnement, utilisez le détail disponible et notez ses limites.
Ne modifiez qu’un réglage à la fois. Si vous raccourcissez les règles, changez de modèle et ajoutez des assistants simultanément, vous ne saurez pas ce qui a fait la différence.
Automatisez les opérations qui se répètent
Supposons que vous receviez chaque semaine un fichier de demandes clients, dont vous harmonisez les colonnes avant d’en tirer une synthèse. La première fois, l’agent peut vous aider à comprendre le format et à écrire le traitement. Si les règles ne bougent pas, les exécutions suivantes se contentent de ce script.
Prévoyez le comportement en cas de nouvelle colonne, de fichier vide ou de date invalide. Conservez l’original et signalez les erreurs. Sinon, l’automatisation produira simplement des rapports faux plus vite.
Le processus n’est pas gratuit pour autant : exécution, services externes et maintenance ont toujours un coût. Mais il n’est plus nécessaire de demander au modèle de réinventer le même traitement chaque semaine. Refaites appel à l’agent lorsque les données ou les besoins changent.
Commencez par une tâche familière
Pour votre prochaine tâche connue, notez les critères d’acceptation, les informations disponibles et l’effort initial. Après examen du résultat, ne modifiez que le facteur qui explique le problème. Quelques comparaisons de ce type seront plus utiles qu’un effort maximal systématique ou une consigne demandant de « dépenser moins ».
- Présentation de GPT-6 Astra par Edvard Grishin : plus de 35 fonctions et comparaison entre Codex et Claude Code
- Chaîne d’Edvard Grishin consacrée à l’IA et à l’automatisation des entreprises
- OpenAI : GPT-6 Astra
- OpenAI : Model guidance
- OpenAI : Reasoning models
- OpenAI : AGENTS.md
- OpenAI : Subagents
- OpenAI : Pricing
Sources et vérification
Sources techniques et calculs vérifiés le 3 octobre 2026. Les scénarios et schémas sont des exemples pédagogiques de Neaptide. Aucun benchmark comparatif des produits n’a été réalisé.