Jev : comment fonctionne une IA conçue pour décider vite
Neaptide · 27 septembre 2026 · 12 min de lecture · Mis à jour: 3 octobre 2026
Comprendre Jev : Choice, Score, Noul, probabilités et limites. System One, chiffres publiés et méthode pour tester le modèle sur vos propres tâches.
Dans cet article
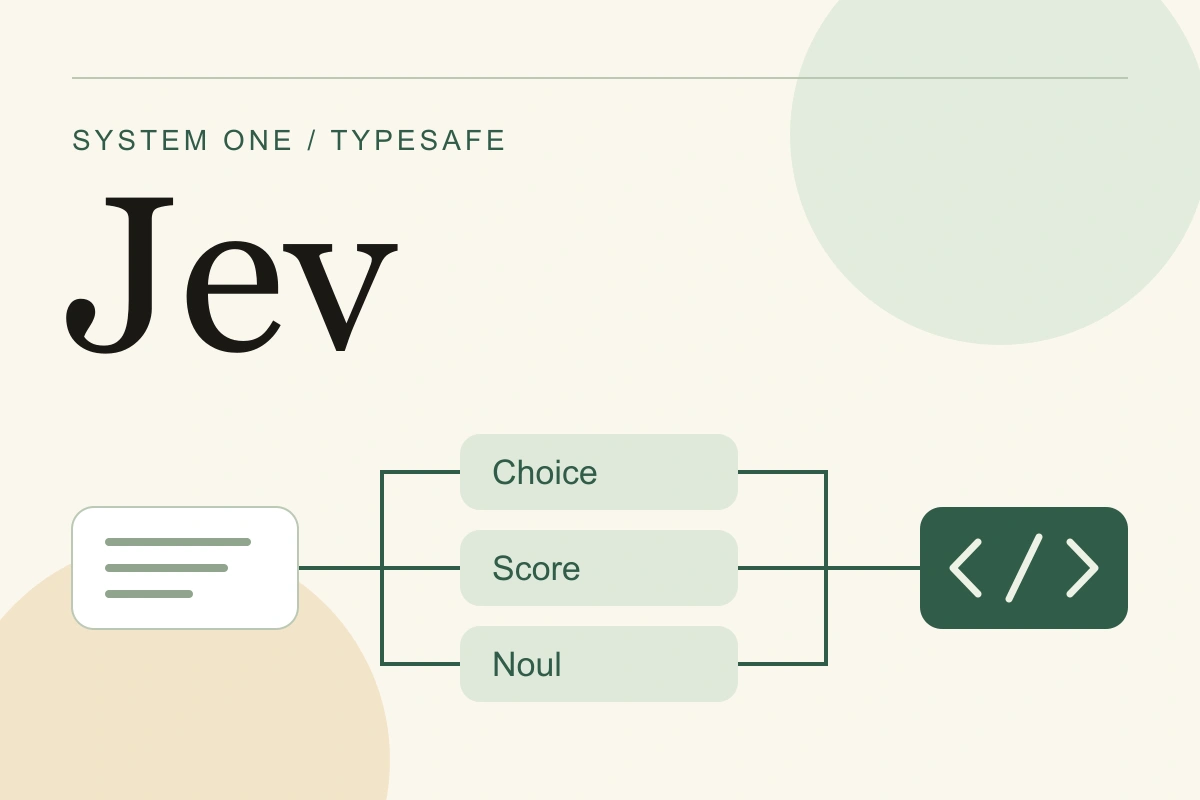
Un client écrit : « Je n’arrive pas à exporter le catalogue. Le CSV fonctionne, mais pas le XLSX. Je dois envoyer le fichier à un fournisseur avant ce soir. » L’application doit déterminer le sujet de la demande, mesurer la gêne causée par la panne et décider de la suite. Une longue réponse du modèle ne lui servirait à rien. Il lui faut quelques valeurs précises.
Jev est le modèle de TypeSafe conçu pour ce type d’évaluation. On lui transmet un contexte et des questions dont le type de réponse est fixé à l’avance ; il renvoie des valeurs et des probabilités qu’un logiciel peut utiliser telles quelles. TypeSafe appelle cette approche System One. Le modèle ne rédige ni courriels ni code et n’explique pas son raisonnement.
Dans son annonce du 15 septembre 2026, l’entreprise a ouvert un accès anticipé en misant sur la rapidité et le faible coût des décisions. Pour juger de l’intérêt pratique de Jev, suivons le parcours complet, de la question posée au modèle à l’action de l’application.
Quelle place pour Jev dans une application ?
Une requête comprend deux parties : state, le contenu à évaluer, et questions, la liste des questions portant sur ce contenu. Le contexte peut être un message, un objet JSON avec les champs d’un ticket ou un tableau de données textuelles. Dans un même appel, toutes les questions voient le même contexte et sont évaluées indépendamment. Jev n’accepte que du texte : les images et les enregistrements audio doivent d’abord être convertis en texte ou en champs exploitables.

Dans cet exemple, vous pouvez demander séparément quel service doit intervenir, à quel point le problème gêne le travail et si le client souhaite parler à quelqu’un. La règle qui envoie les tickets techniques vers la bonne file reste dans le code. Si le processus d’assistance change, le développeur modifie cette règle sans toucher aux questions.
Ce découpage est utile en soi. Demander « que devons-nous faire pour ce client ? » mêle compréhension du texte, priorités commerciales et actions autorisées. Avec des questions ciblées, on repère plus vite l’étape où le système s’est trompé. C’est l’organisation que recommande la documentation de TypeSafe.
Trois types de questions, trois sens différents
Jev propose trois types de questions : Choice, Score et Noul. Lequel retenir dépend de ce que le programme doit savoir.

Choice convient lorsqu’il faut retenir une option dans un ensemble défini, par exemple technical, billing ou other. La réponse contient l’option choisie, une distribution de probabilités et confidence. Rédigez les descriptions des catégories de façon qu’on puisse les distinguer.
Score sert à situer un cas sur une échelle ordonnée. Pour l’impact d’un problème, les niveaux pourraient être « ne gêne pas le travail », « gêne le travail, mais une solution de contournement existe » et « le travail est bloqué ». Le résultat peut tomber entre deux niveaux, car il correspond à la moyenne de leurs indices, pondérée par les probabilités. Un score de 1,4 sur une échelle de 0 à 2 ne signifie pas que 70 % des utilisateurs sont touchés.
Noul évalue une seule question à laquelle on répond par oui ou par non, par exemple : « Le client demande-t-il explicitement à parler à une personne ? » Une valeur entre 0 et 1 exprime la probabilité de « oui ». Proche de 0,5, elle signale une incertitude et non une « demande modérée ». Noul n’a pas de champ confidence distinct.
Pour vérifier une formulation, demandez-vous si un collègue saurait distinguer les options sans que leur auteur les lui explique de vive voix. Sinon, précisez d’abord les catégories et les niveaux. Le modèle ne lèvera pas l’ambiguïté d’une règle métier à la place du développeur.
Que couvre la promesse « sans hallucinations » ?
Dans son annonce, TypeSafe relie l’absence d’hallucinations à un espace de réponses limité : le modèle ne renvoie que les valeurs autorisées par la structure. Cela règle un problème précis, celui d’une réponse arbitraire là où le programme attend un type donné.

Supposons trois services. Que le modèle en choisisse un qui existe ne prouve pas que le ticket est arrivé au bon endroit. Une garantie de format ne dit rien de la bonne compréhension du texte, et le respect du schéma ne prouve pas davantage que l’action métier était la bonne.
Comparer Jev au seul modèle de conversation à qui l’on demande de « renvoyer du JSON » ne suffit pas non plus. L’adaptateur de TypeSafe prend lui-même en charge les modes natifs de sortie structurée des LLM. Pour un projet réel, comparez des intégrations complètes : qualité des décisions, latence, coût et gestion des défaillances.
Les probabilités sont utiles si le programme sait les exploiter
Imaginons deux réponses Choice qui désignent toutes deux l’assistance technique. Dans la première, cette option concentre presque toute la probabilité. Dans la seconde, les deux autres la talonnent. Le nom du service retenu, à lui seul, ne laisse rien voir de cette différence.

Pour Choice et Score, confidence est calculé à partir de la forme de la distribution de probabilités. Ne le lisez pas comme « la probabilité que cette réponse soit correcte ». TypeSafe propose de s’en servir pour décider de la suite du traitement, avec des seuils adaptés à la tâche.
La calibration est une autre notion. Si un modèle bien calibré attribue une probabilité de 0,8 à un événement dans un grand nombre de prédictions comparables, cet événement devrait se produire environ 80 % du temps. Cette propriété vaut pour un ensemble de prédictions et ne promet pas une réponse correcte dans chaque cas. Selon TypeSafe, la méthode RLCD (Reinforcement Learning for Calibrated Decisions) sert à entraîner ces probabilités.
En pratique, prévoyez à l’avance le sort des tickets ambigus. Un choix de service net peut autoriser une orientation automatique, tandis qu’une distribution dispersée envoie le ticket vers une file de vérification générale. Le seuil dépend du coût d’une mauvaise orientation et des résultats obtenus sur vos propres messages.
Comment lire les annonces de rapidité et de coût ?
Les chiffres publiés suffisent pour une première estimation, mais ils ne reposent pas tous sur la même base. Le prix indiqué dans la documentation est un tarif. Le temps de réponse a été mesuré dans certaines conditions. Un avantage sur un jeu de test résulte d’une comparaison avec des solutions choisies.
| Indicateur | Ce qui est publié | Comment l’utiliser |
|---|---|---|
| Temps de réponse | L’annonce indique 70–500 ms ; les évaluations étaient généralement réalisées depuis la côte ouest des États-Unis, où le service était hébergé | Mesurez la latence depuis la région de votre application, y compris les réponses lentes |
| Prix de Jev 1.13 | 0,042 $ US par million de tokens en entrée ; les tokens de sortie sont gratuits | Comptez toute l’entrée, contexte et questions compris |
| Qualité des workflows | Quatre scénarios : incidents de sécurité, observabilité des agents, traitement des factures et service client | Examinez la méthode et testez vos propres scénarios |
Sources : conditions de mesure dans l’annonce, modèles et tarifs, Workflow evals. Vérifiées le 3 octobre 2026.
Workflow evals construit sa référence à partir des réponses moyennes de GPT-6 Astra et Claude Fable 5.1 avec un niveau de raisonnement élevé ; les autres participants gardent les réglages par défaut de leur fournisseur. Le résultat mesure donc l’accord avec une référence produite par des modèles, dans un processus défini. Ce n’est pas une précision mesurée sur des résultats réels annotés indépendamment.
Pour donner un ordre de grandeur, prenons un calcul fictif : un million d’appels à mille tokens d’entrée chacun représentent un milliard de tokens, soit 42 $ US au tarif publié. Ces mille tokens doivent contenir le contexte et les questions. Le calcul laisse de côté les nouvelles tentatives, les autres modèles, l’infrastructure et la vérification humaine.
Pour choisir une solution, mieux vaut regarder le coût par ticket correctement traité. Un appel bon marché n’avance pas à grand-chose si quelqu’un doit corriger une grande partie des résultats.
Où Jev est utile, et où un autre outil est nécessaire
Les décisions répétitives portant sur du texte sont le terrain d’essai naturel : déterminer le sujet d’une demande, évaluer la correspondance avec une description, choisir une catégorie. La suite dépend de ce que le système doit faire du résultat.

Pour la panne d’export, Jev peut évaluer le contenu de la réclamation. Vérifier la disponibilité du service, calculer l’échéance prévue par le SLA et modifier le statut du ticket restent des opérations logicielles ordinaires. Le courriel au client peut être composé à partir d’un modèle de texte ou rédigé par une IA générative à laquelle on fournit les faits vérifiés et l’action retenue.
Cette répartition tient compte des limites de Jev 1.13 que TypeSafe décrit elle-même. Le modèle manque de fiabilité pour les comptages précis et la comparaison de dates, et les informations inutiles dans un long contexte dégradent ses réponses. Un texte conçu à dessein peut influencer la classification. TypeSafe recommande donc de garder les calculs dans le code, d’écarter le contexte hors sujet et de tester les cas difficiles.
Pour un produit francophone, prévoyez un jeu de test en français. D’après la documentation, l’anglais est la principale langue d’entraînement et celle où la précision est actuellement la meilleure ; les performances peuvent varier dans les autres langues. Le point compte d’autant plus que les tickets contiennent des abréviations, des fautes de frappe et du vocabulaire spécialisé.
Comment lancer un essai dans votre produit ?
Choisissez une décision fréquente dont le bon résultat est clair, par exemple l’attribution des tickets aux services. Gardez le processus actuel comme référence. Annotez des exemples réels et anonymisés, cas ambigus compris, en séparant les données de réglage du jeu d’évaluation final.

Suivez ensemble la part des tickets traités automatiquement et le taux d’erreur au sein de cette part. Un seuil qui renvoie presque tout vers une personne peut afficher une excellente précision sans automatiser grand-chose. Un seuil plus souple s’évalue au regard du coût des corrections.
Ajoutez la latence p95 (le délai dans lequel se terminent 95 % des requêtes mesurées), les dépenses liées au modèle et la charge de travail humaine. Comparez Jev au processus actuel et à un LLM adapté sur les mêmes exemples. L’adaptateur de TypeSafe propose un mode de probabilités et un mode de décisions discrètes : choisissez des conditions de comparaison qui correspondent aux besoins réels de l’application.
Conservez la version du modèle, les questions et les seuils avec les résultats. L’alias jev-latest peut basculer vers une nouvelle version, d’où la recommandation de la documentation : fixer un identifiant précis une fois le comportement réglé pour cette version.
L’idée technique de Jev est claire : faire d’une évaluation du sens une petite étape observable dans un programme. Testez-la là où ces étapes sont nombreuses et où l’équipe sait dire précisément ce qu’est une erreur. L’essai montrera alors quelles décisions peuvent être automatisées et quelle incertitude subsiste en dehors de cette automatisation.
Article fondé sur des sources primaires publiques vérifiées le 3 octobre 2026. Les exemples et schémas sont illustratifs. Nous n’avons effectué ni appel à l’API ni test indépendant de Jev.