Jev: cómo funciona una IA diseñada para decidir rápido
Neaptide · 27 de septiembre de 2026 · 12 min de lectura · Actualizado: 3 de octubre de 2026
Cómo funciona Jev: Choice, Score, Noul, probabilidades y límites. System One, cifras publicadas y cómo probar el modelo con tus propias tareas.
En este artículo
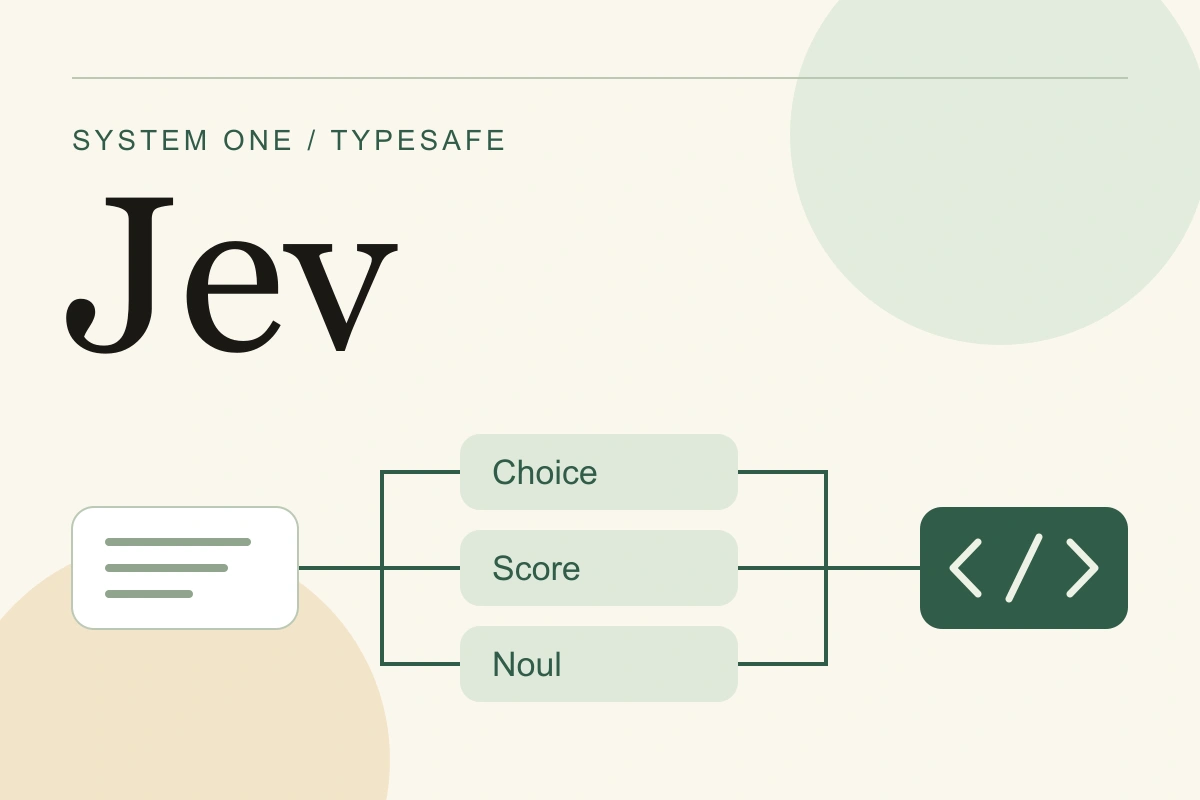
Un cliente escribe: «No puedo exportar el catálogo. CSV funciona, pero XLSX no. Necesito enviar el archivo a un proveedor antes de esta noche». La aplicación tiene que identificar el tema de la solicitud, valorar cuánto afecta el fallo y decidir el siguiente paso. Una respuesta larga del modelo aquí solo estorba. Al sistema le bastan unos pocos valores concretos.
Jev es el modelo de TypeSafe para este tipo de decisiones. Recibe un contexto y preguntas con tipos de respuesta definidos, y devuelve valores y probabilidades que el software puede usar directamente. TypeSafe llama a este enfoque System One. El modelo no redacta correos ni código, y tampoco explica su razonamiento.
En su anuncio del 15 de septiembre de 2026, la empresa abrió el acceso anticipado y apostó por la rapidez y el bajo coste de las decisiones. Para saber qué vale Jev en la práctica, conviene seguir todo el recorrido, desde la pregunta al modelo hasta la acción de la aplicación.
Dónde encaja Jev en una aplicación
Una petición contiene state, el material que se va a evaluar, y questions, las preguntas sobre ese material. El contexto puede ser un mensaje, un objeto JSON con los campos de una solicitud de soporte o un array con datos de texto. Todas las preguntas de una llamada ven el mismo contexto y se evalúan de forma independiente. Jev solo acepta texto, así que las imágenes y el audio hay que convertirlos antes en texto o en los campos pertinentes.

En este ejemplo puedes preguntar por separado qué departamento necesita el cliente, cuánto afecta el problema a su trabajo y si quiere hablar con una persona. La regla que envía las solicitudes técnicas a la cola correspondiente se queda en el código. Si cambia el proceso de atención, el desarrollador modifica esa regla y no toca las preguntas.
La separación ya es útil de por sí. Preguntar «¿qué debemos hacer con este cliente?» mezcla comprensión del texto, prioridades del negocio y acciones permitidas. Con preguntas concretas es más fácil localizar el paso en el que el sistema se equivocó. Es la forma de trabajar que recomienda la documentación de TypeSafe.
Tres tipos de pregunta, tres significados
Jev ofrece tres tipos básicos de pregunta: Choice, Score y Noul. Cuál usar depende de lo que el programa necesite averiguar.

Choice sirve cuando se necesita una opción de un conjunto definido, como technical, billing u other. La respuesta incluye la opción elegida, una distribución de probabilidades y confidence. Redacta las descripciones de las categorías de modo que se puedan distinguir entre sí.
Score se usa con una escala ordenada. Para valorar el impacto de un fallo, puedes definir los niveles «no afecta al trabajo», «lo dificulta, pero hay una alternativa» y «el trabajo está bloqueado». El resultado puede quedar entre dos niveles, porque se calcula como la media de sus índices ponderada por las probabilidades. Un valor de 1,4 en una escala de 0 a 2 no significa que el 70 % de los usuarios esté afectado.
Noul evalúa una sola pregunta de sí o no: por ejemplo, «¿El cliente pide explícitamente hablar con una persona?». Un número entre 0 y 1 expresa la probabilidad de «sí». Cerca de 0,5 indica incertidumbre, y no una «petición moderada». Noul no tiene un campo confidence independiente.
Para comprobar la redacción, pregúntate si un compañero sabría distinguir las opciones sin que quien las escribió se las explique de palabra. Si no, aclara primero las categorías y los niveles. El modelo no va a resolver por el desarrollador la ambigüedad de una regla de negocio.
Qué cubre la promesa de «no alucinar»
En el anuncio, TypeSafe atribuye la ausencia de alucinaciones a un espacio de respuestas limitado: el modelo solo devuelve valores permitidos por la estructura. Eso resuelve un problema concreto, el de una respuesta arbitraria donde el programa espera un tipo determinado.

Supongamos que hay tres departamentos. Que el modelo elija uno que existe no demuestra que la solicitud haya llegado al equipo adecuado. Una garantía de formato no dice nada sobre si el texto se entendió bien, y cumplir el esquema tampoco demuestra que la acción de negocio fuera la correcta.
Tampoco basta con comparar Jev con un modelo de chat al que se le pide «devuelve JSON». El propio adaptador de TypeSafe admite los modos nativos de salida estructurada de los LLM. En un proyecto real, compara integraciones completas: calidad de las decisiones, latencia, coste y gestión de fallos.
Las probabilidades sirven si el programa sabe utilizarlas
Imagina dos respuestas Choice con la misma opción ganadora, soporte técnico. En la primera, esa opción se lleva casi toda la probabilidad. En la segunda, las otras dos le siguen de cerca. Con el nombre del departamento elegido no se ve esa diferencia.

En Choice y Score, confidence se calcula a partir de la forma de la distribución de probabilidades. No lo leas como «la probabilidad de que esta respuesta sea correcta». TypeSafe propone usarlo para decidir cómo continuar, con umbrales adaptados a cada tarea.
La calibración es otro concepto. Si un modelo bien calibrado asigna una probabilidad de 0,8 a un suceso en un conjunto amplio de predicciones comparables, ese suceso debería ocurrir aproximadamente el 80 % de las veces. Es una propiedad del conjunto de predicciones y no promete una respuesta correcta en cada caso. Según TypeSafe, el método RLCD (Reinforcement Learning for Calibrated Decisions) está orientado a entrenar esas probabilidades.
En la práctica, decide de antemano qué ruta siguen las solicitudes ambiguas. Una elección clara de departamento puede permitir el envío automático, mientras que una distribución dispersa lleva la solicitud a una cola de revisión general. El umbral depende de lo que cuesta enviarla al lugar equivocado y de las pruebas con tus propios mensajes.
Cómo interpretar las cifras de velocidad y coste
Las cifras publicadas sirven para una primera estimación, aunque no todas tienen la misma base. El precio de la documentación es una tarifa. El tiempo de respuesta se midió en determinadas condiciones. Una ventaja en un conjunto de pruebas sale de comparar con alternativas seleccionadas.
| Indicador | Qué se ha publicado | Cómo utilizarlo |
|---|---|---|
| Tiempo de respuesta | El anuncio indica 70–500 ms; las evaluaciones se realizaban generalmente desde la costa oeste de EE. UU., donde estaba el servicio | Mide la latencia desde la región de tu aplicación, incluidas las respuestas lentas |
| Precio de Jev 1.13 | 0,042 USD por millón de tokens de entrada; los de salida son gratuitos | Calcula toda la entrada, incluidos contexto y preguntas |
| Calidad de los flujos | Cuatro escenarios: incidentes de seguridad, observabilidad de agentes, procesamiento de facturas y atención al cliente | Revisa la metodología y prueba tus propios escenarios |
Fuentes: condiciones de medición del anuncio, modelos y tarifas, Workflow evals. Comprobadas el 3 de octubre de 2026.
Workflow evals construye su referencia con el promedio de las respuestas de GPT-6 Astra y Claude Fable 5.1 con un nivel de razonamiento alto; los demás participantes usan la configuración predeterminada de su proveedor. El resultado mide, por tanto, la concordancia con una referencia producida por modelos dentro de un proceso definido. No es lo mismo que la precisión frente a resultados reales etiquetados de forma independiente.
Para hacerse una idea de la tarifa, tomemos un cálculo ilustrativo: un millón de llamadas de mil tokens de entrada cada una suma mil millones de tokens, es decir, 42 USD a la tarifa publicada. En esos mil tokens tienen que caber el contexto y las preguntas. Quedan fuera del cálculo los reintentos, otros modelos, la infraestructura y la revisión humana.
Al elegir una solución, es más útil calcular el coste por solicitud resuelta correctamente. Una llamada barata sirve de poco si una persona tiene que corregir buena parte de los resultados.
Dónde ayuda Jev y dónde hace falta otra herramienta
Las decisiones repetitivas sobre texto son el punto de partida natural: identificar el tema de una solicitud, evaluar si algo coincide con una descripción, elegir una categoría. El siguiente paso depende de lo que el sistema deba hacer con el resultado.

En el fallo de exportación, Jev puede evaluar el contenido de la queja. Comprobar la disponibilidad del servicio, calcular el plazo del SLA y cambiar el estado de la solicitud siguen siendo operaciones de software corrientes. El correo al cliente puede componerse con una plantilla o redactarse con un modelo generativo al que se le pasen los datos verificados y la acción elegida.
Este reparto responde a las limitaciones de Jev 1.13 que describe la propia TypeSafe. El modelo no es fiable al contar con precisión ni al comparar fechas, y la información irrelevante en un contexto largo empeora las respuestas. Un texto escrito a propósito puede influir en la clasificación. El desarrollador recomienda dejar los cálculos en el código, quitar el contexto irrelevante y probar los casos difíciles.
Para un producto en español, prepara un conjunto de pruebas en español. La documentación señala el inglés como idioma principal de entrenamiento y aquel en el que la precisión es hoy mejor; en otros idiomas el rendimiento puede variar. Pesa más todavía si las solicitudes contienen abreviaturas, erratas y vocabulario especializado.
Cómo empezar una prueba piloto en tu producto
Elige una decisión frecuente con un resultado correcto claro, como asignar solicitudes a departamentos. Conserva el proceso actual como referencia. Etiqueta ejemplos reales y anonimizados, también los ambiguos, y separa el material de ajuste del conjunto de evaluación final.

Mira dos magnitudes a la vez: qué proporción de solicitudes se procesa automáticamente y con qué frecuencia se equivoca el sistema dentro de esa proporción. Un umbral que envía casi todo a una persona puede dar una precisión excelente sin automatizar apenas nada. Un umbral más permisivo hay que valorarlo junto con el coste de las correcciones.
Añade la latencia p95 (el tiempo en el que termina el 95 % de las peticiones medidas), el gasto del modelo y la carga de trabajo manual. Compara Jev con el proceso actual y con un LLM adecuado usando los mismos ejemplos. El adaptador de TypeSafe permite devolver probabilidades o decisiones discretas, así que elige condiciones de comparación que reflejen lo que la aplicación necesita de verdad.
Guarda la versión del modelo, las preguntas y los umbrales junto con los resultados. El alias jev-latest puede pasar a señalar una nueva versión; por eso la documentación recomienda fijar un identificador concreto cuando el comportamiento ya se ha ajustado a esa versión.
La idea de ingeniería de Jev es clara: convertir una evaluación del significado en un paso pequeño y observable dentro de un programa. Pruébala donde esos pasos sean frecuentes y el equipo pueda decir con precisión qué cuenta como error. El piloto mostrará entonces qué decisiones se pueden automatizar y cuánta incertidumbre queda fuera de esa automatización.
Artículo basado en fuentes primarias públicas comprobadas el 3 de octubre de 2026. Los ejemplos y diagramas son ilustrativos. No hicimos llamadas a la API ni pruebas independientes de Jev.