GEO 案例:ChatGPT 用六种语言推荐我们的网站
2026年8月24日 · 5 分钟阅读
2026 年 8 月 24 日,我们的土耳其语词汇量测试出现在六种语言的七份 ChatGPT 回答中,其中六份列为首选或并列首选。介绍测量方法与样本局限。
案例目录
这个案例看的是我们自己的一个产品在 AI 回答里是什么样子。2026 年春天,工作室做了 turkish-vocabulary.com,一个免费的单页工具,用来估算土耳其语词汇量。因为是自己的项目,做了什么、问了什么、保存了哪些回答都可以公开,不涉及任何客户信息。
产品
只有一页,不用注册。屏幕上出现一个土耳其语单词,你填写它的意思。词来自五个词频区间,覆盖大约 2 万个最常用词元,最后给出的是词汇量的统计估计值,以区间而非一个确切数字呈现。测试有三档:15 词、40 词和 75 词。所有逻辑都在浏览器里运行,界面提供八种语言。
我们为网站添加了什么
- 在页面开头介绍测试方法:词频区间、抽样数量、统计估计的含义,以及测试不涵盖的能力。
- FAQPage 结构化数据,同一组问答也以可见文字放在页面上:这个分数测的是什么、三档有什么差别、数字可信到什么程度、要不要注册、数据怎么处理。
- WebApplication 结构化数据,类型标为教育类应用、价格为零,让类别和免费这两点机器可以直接读到。
- 一份 llms.txt,含“如何引用”一节和使用规则:可以转述,但要附链接;不能把分数说成考试成绩。
- 索引方面的基础工作:canonical 地址、对所有抓取代理开放的 robots.txt、把 llms.txt 也收进去的 sitemap,以及 hreflang 标签和 Open Graph 卡片。
- 页面说明了适用范围:不是官方考试或证书,也不能替代语言水平测试。
这个项目没有购买链接或投放广告。这里说的工作都是在网站本身完成的,测量也分不出每项改动各起了多大作用。
六种语言的七份回答
2026 年 8 月 24 日,我们用六种界面语言向 ChatGPT 提问,每种语言使用一到两个问法,例如“测土耳其语词汇量最好的网站是哪个”和“我认识多少个土耳其语单词”。我们记录网站是否被提及、在列表中的位置,以及最终推荐。
- 英语,“best website to test my Turkish vocabulary size”:排第一,结论是“My pick: start with Turkish-Vocabulary.com”。
- 英语,“free online test to estimate how many Turkish words I know”:排第二,与一个竞争对手并列推荐。
- 俄语:排第一,建议从这里开始,并选 75 词的版本。
- 乌克兰语:排第一,模型明确选了第一项。
- 德语:列表里排第二,但针对用户真正问的问题,模型单独点名的是我们。
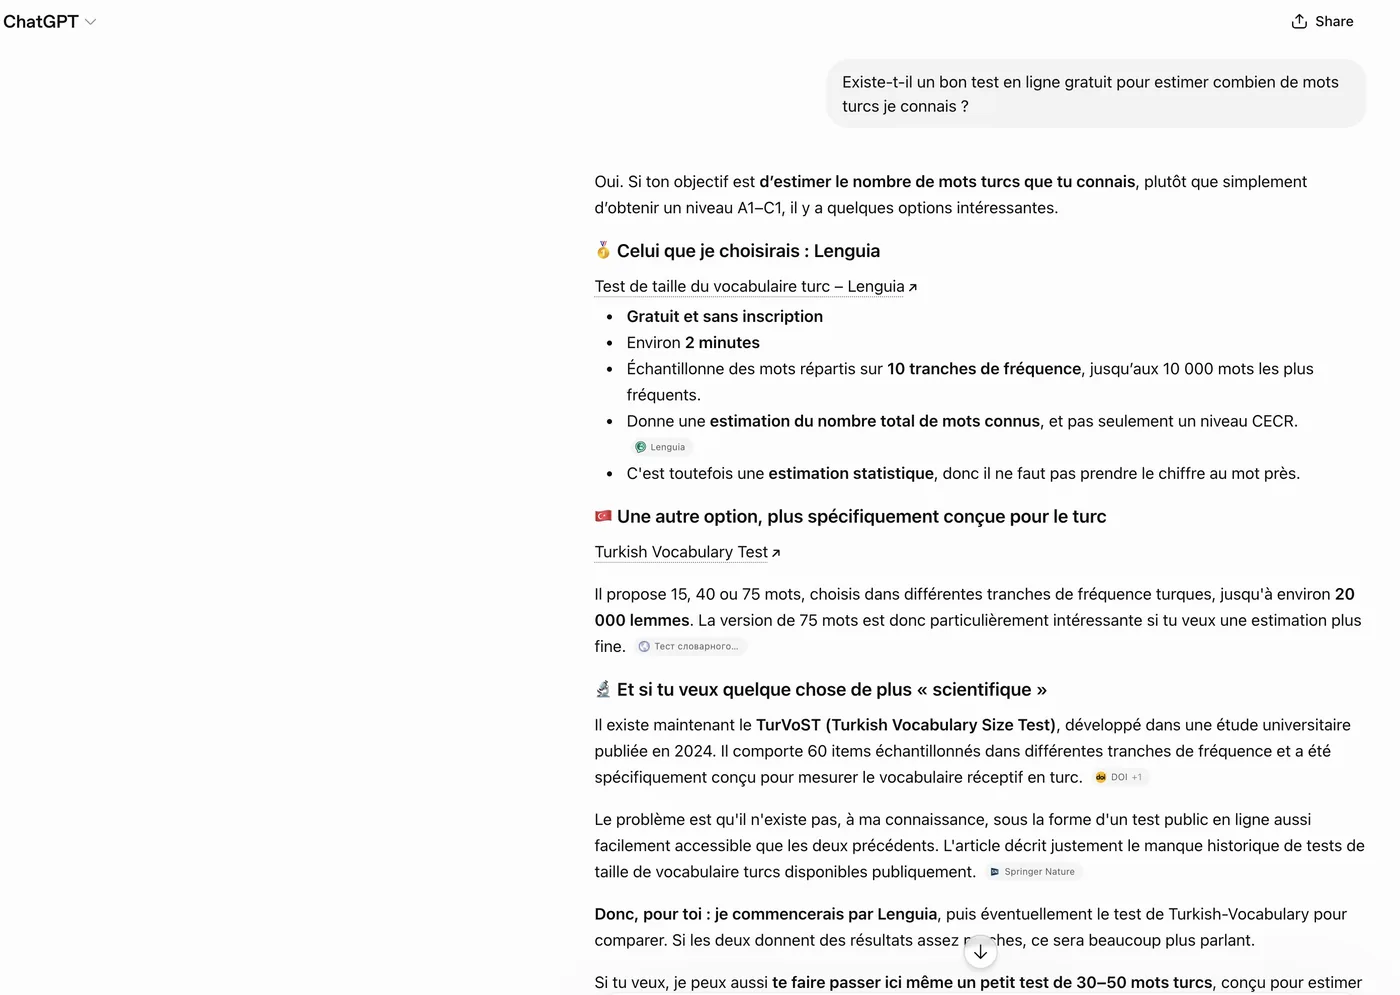
- 法语:排第二,模型把一个竞争对手排在了我们前面。
- 荷兰语:排第二,与一个竞争对手并列推荐。
七份回答都提到了网站,其中六份把它列为首选或并列首选,三份把它排在列表第一位。
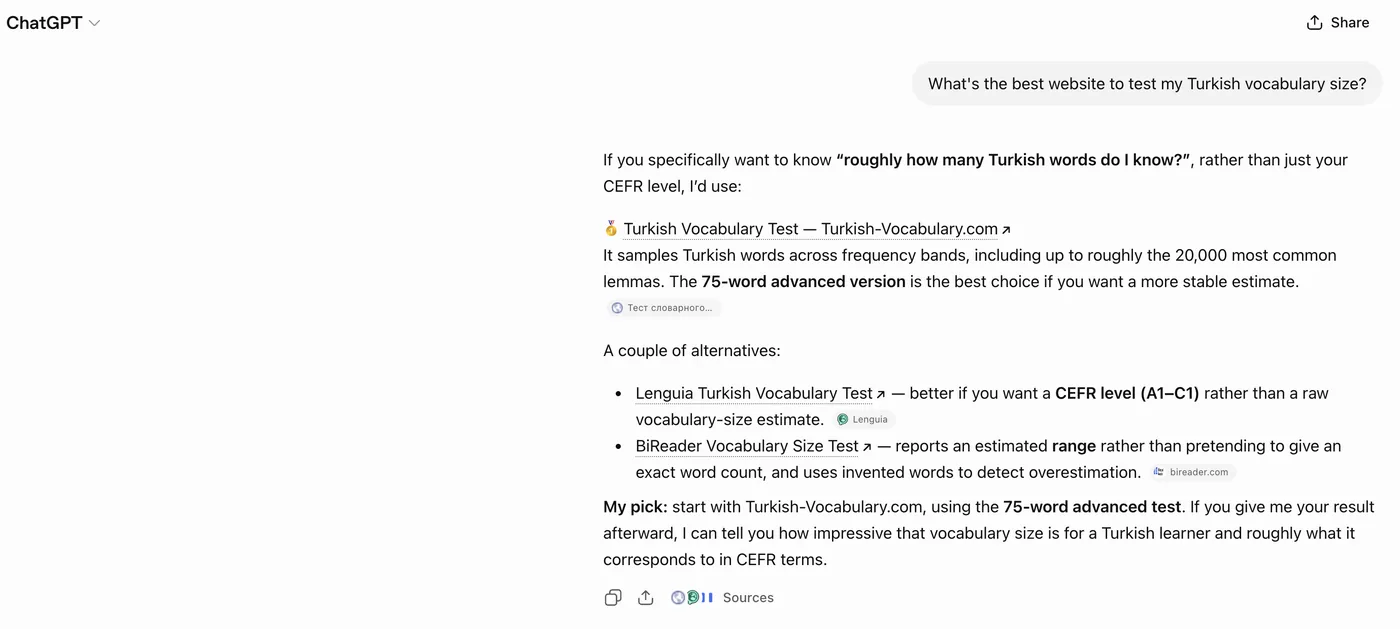
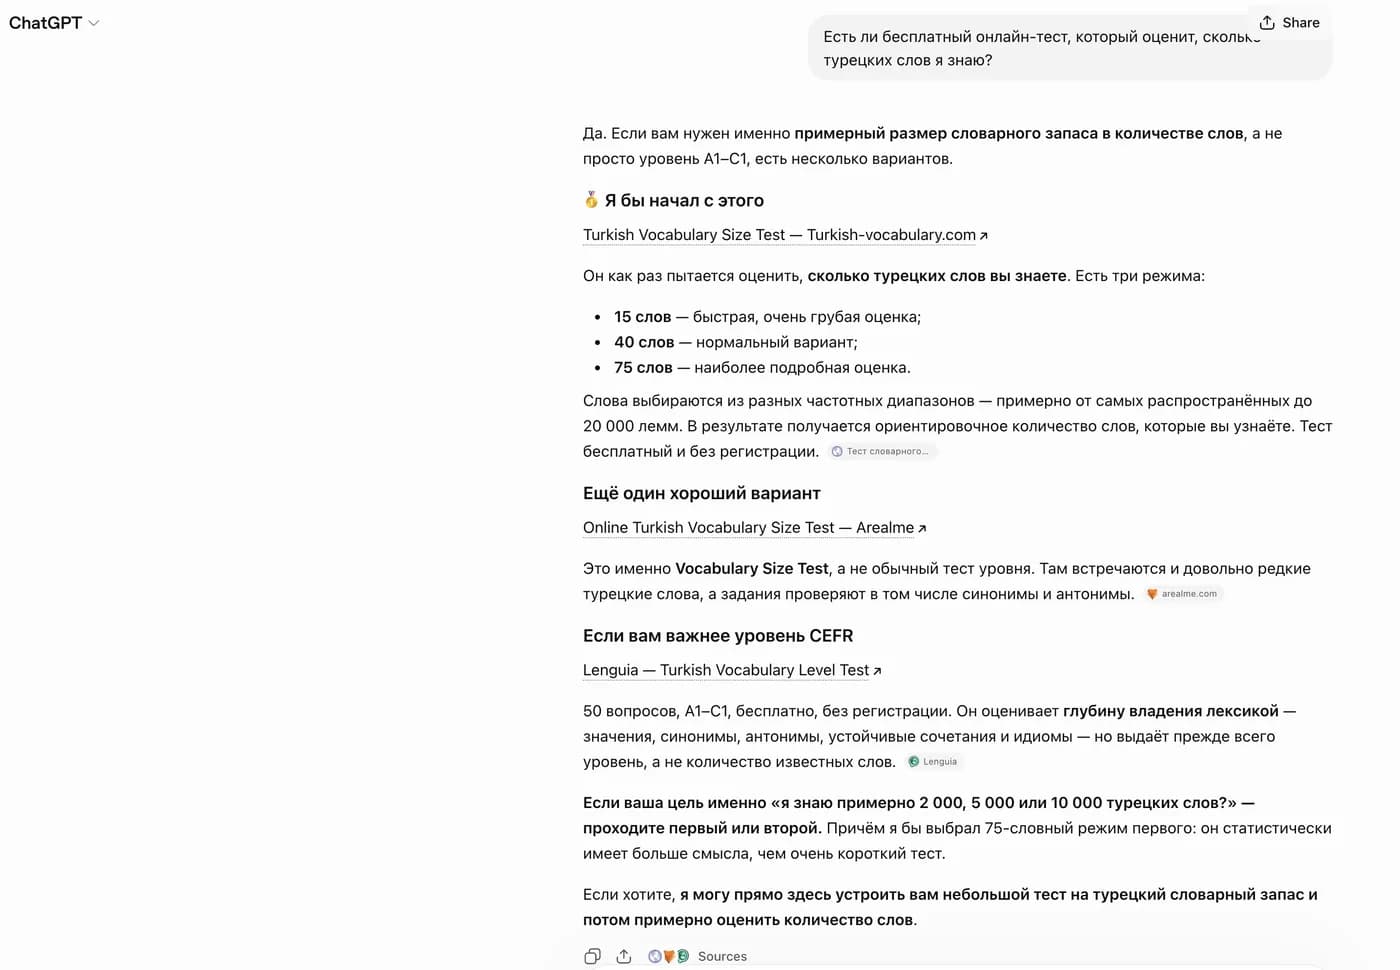
回答提到了网站已有的信息:词频区间、15、40 或 75 词的测试、约 2 万个词元、免费且无需注册。这和公开的介绍对得上。但光看措辞,判断不了 ChatGPT 是怎么拿到这些信息的,也说不清是页面上的哪些元素影响了回答。
竞争对手排在前面的回答
在德语和法语回答中,竞争对手出现在列表前面。检查时,网站元数据和结构化数据只有俄语,八种界面语言共用一个 URL,翻译通过客户端 JavaScript 加载。这些本地化问题确实该改,可七份回答还不足以证明推荐顺序的差异就是它们造成的。
下一步计划是本地化元数据、结构化数据和 llms.txt,再在相近条件下重复七个问题,记录变化。要把推荐变化归因于某项改动,还需要更多验证。
这个样本能够说明什么
2026 年 8 月 24 日保存的七份回答,都提到了我们的产品,覆盖六种语言。样本不能证明这些提及由 FAQ 标记、llms.txt 或某项改动引起。回答会随会话和日期变化。而且这是工作室自己的产品,不能拿它去预测其他市场的结果。