本地大模型需要多少内存:RAM、显存与上下文
Neaptide · 2026年9月20日 · 10 分钟阅读 · 更新于: 2026年10月4日
估算本地大模型内存:权重、量化、KV 缓存、RAM 与显存,附公式、容量表和电脑测试步骤。
本文目录
模型文件只有 4 GB,电脑有 8 GB 空闲内存,却还是跑不起来。权重大小只是计算的起点。KV 缓存、工作缓冲区和其他程序的占用要分别算进去,再用实际的推理引擎验证自己的任务。
先明确三个条件:具体模型及量化方式、所需上下文长度、同时处理多少个请求。缺了这些条件,“AI 需要多少内存”这个问题太笼统,没法回答。
哪些部分占用内存
| 组成部分 | 主要影响因素 |
|---|---|
| 模型权重 | 参数数量与存储格式 |
| KV 缓存 | 架构、上下文、缓存精度与序列数量 |
| 工作缓冲区 | 推理引擎与启动设置 |
| 其他应用 | 操作系统、编辑器、浏览器及后台进程 |
KV 缓存保留注意力计算的中间数据,避免生成每个新 token 时都从头计算。缓存策略会影响内存用量。
落到实际使用上,同一个模型用长上下文时,需要的内存可能比短上下文多出不少。
不要把未知开销统一假设成“再留 20%”。分别记录加载前、加载后,以及按所需上下文执行请求时的内存占用。这几个测量点能看出增长发生在哪里,但没法精确拆分到引擎内部的每一个缓冲区。

粗略估算权重占用
初步估算公式:
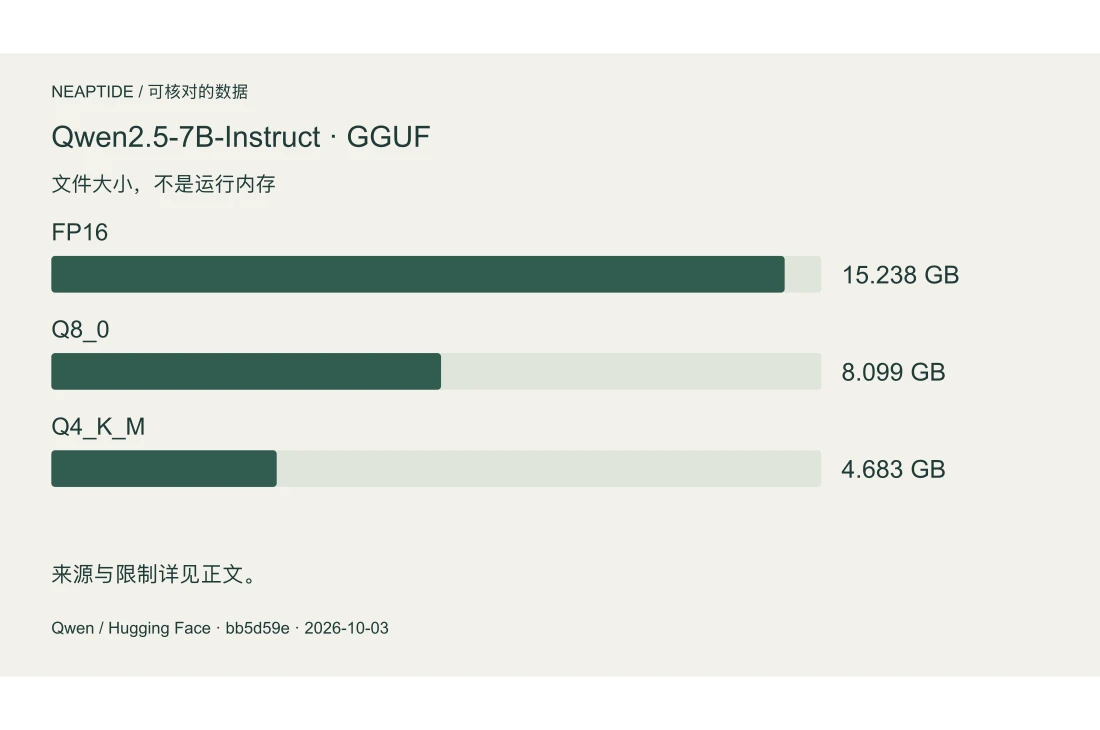
权重字节数 ≈ 参数数量 × 每参数位数 / 8使用 Qwen 官方仓库中的真实 Qwen2.5-7B-Instruct-GGUF 文件。2026年10月3日,我们通过 Hugging Face API 获取元数据,按格式汇总全部分片,固定版本为 bb5d59e06d9551d752d08b292a50eb208b07ab1f。未下载权重,也未运行模型。
| 格式 | 分片数 | 总字节数 | GB |
|---|---|---|---|
| FP16 | 4 | 15 237 853 536 | 15.238 |
| Q8_0 | 3 | 8 098 525 408 | 8.099 |
| Q4_K_M | 2 | 4 683 073 632 | 4.683 |
Q4_K_M 并非每个参数都恰好四位。文件大小已包括元数据、打包和不同精度的张量,因此合计4.683 GB,而非按假设的70亿参数粗算所得的3.5 GB。
字节数除以1,073,741,824得到 GiB,除以十亿得到 GB。文件大小不等于 RAM 或 VRAM 用量,还需要 KV 缓存、工作缓冲区及其他程序的内存。
FP16、Q8_0 和 Q4_K_M 属于同一模型和同一版本。分片数表示下载文件的拆分,不是多个模型;所选格式的全部分片都需要。
RAM 与显存有什么区别
RAM 是系统内存,VRAM 是独立 GPU 的显存。模型放在哪里,取决于硬件和引擎。在统一内存系统中,CPU 和 GPU 共享同一资源,操作系统也需要使用它。
不能把 16 GB RAM 与 8 GB 显存直接相加,就当成一张 24 GB 的显卡。任务能否拆分执行、数据传输要付出多少代价,取决于具体组合。
Ollama 的 ollama ps 可以显示已加载模型在 CPU 与 GPU 之间的分配。
上下文如何影响内存
对于常规的完整 KV 缓存,可以粗略计算:
缓存字节数 ≈ 2 × 层数 × KV 头数 × 头维度
             × token 数 × 每元素字节数 × 序列数
系数 2 对应键和值。这是适用于相应架构的简化模型,不是所有 LLM 通用的计算器。滑动注意力、压缩等实现会改变计算方式。
所以比较两种配置时,应设置相同的上下文。如果一个模型只拿到一个短函数,另一个却拿到整个仓库,光看内存差异说明不了什么。
Ollama 可以调整上下文长度,长度越大,需要的内存越多。用 ollama ps 查看当前分配与上下文。
以一个教学架构为例:32 层、8 个 KV 头、头维度 128,缓存元素各占 2 字节。完整缓存下,一条 4096 token 的序列需要 0.5 GiB,16,384 token 需要 2 GiB。四条这样的序列共需 8 GiB 缓存。在下面的计算器里,模型权重是共享的,缓存则随上下文和并发数增长。

上下文如何影响内存占用
教学模型:7B,4 位权重;完整 KV 缓存:32 层、8 个 KV 头、头维度 128、每个元素 2 字节。所有序列共享权重。
- 原始权重
- 3.26 GiB
- KV 缓存
- 0.5 GiB
- 权重 + 缓存
- 3.76 GiB
不含系统、引擎缓冲区和量化元数据,不代表完整 RAM 或 VRAM 需求。其他架构需要采用不同计算方式。
改变上下文或并发数,权重大小保持不变。
怎样测试自己的电脑
记录模型、准确标签、量化方式、引擎及版本。用短输入和较长输入执行同一项任务,保存:
- 配置的上下文长度与并发请求数。
- 启动前及运行中的内存占用。
- CPU/GPU 分配情况。
- 首次响应等待时间与总耗时。
- 按预先设定条件检查的结果质量。
重复运行,区分模型加载与稳定运行阶段。如果内存不足,先只减少一个参数,不要同时更换模型、上下文和所有设置。
16 GB 或 32 GB 可以尝试什么
不看硬件条件,就没有一份“保证能运行”的固定清单。内存有限时,从小型量化模型和短任务开始,例如 Ollama 入门指南中的示例,并为系统和应用留出余量。
按真实工作负载选配置:上下文够用、响应时间可接受,重复运行也不会耗尽内存。保存模型标签和测量参数。这样,要不要添置内存或显卡,依据的是实测出的瓶颈,而不是模型文件的大小。
来源与核对
技术来源和计算已于 2026 年 10 月 3 日核对。场景与图示为 Neaptide 教学示例,未开展产品性能对比测试。