企业 AI 智能体:第一个自动化场景怎么选?
Neaptide · 2026年9月6日 · 9 分钟阅读 · 更新于: 2026年10月4日
从一个具体业务环节开始,测试错误与异常,计算人工审核后的实际价值。附原创流程图、在线计算器和试点记录表。
本文目录
企业的第一个 AI 智能体试点,适合选择反复发生、资料可获取、结果可核验的任务。先让系统整理信息或准备草稿,再测量员工还需要投入多少时间。模型回复得快,并不能说明整个流程就更划算。
以处理手工课程咨询为例,有的客户写清了日期和人数,有的只说“想组织团队参加”。复制这些信息不难。难的是判断还缺什么、查阅适用的服务条件,再向客户补问。试点可以先从这一段工作做起。
需要智能体,还是固定工作流就够了?
本文所说的 AI 智能体,是由模型根据目标选择下一步并调用工具的系统。这个词有不同用法,立项时应先说清楚:系统是执行预先确定的路线,还是自行决定去哪里查、接下来做什么?Anthropic 区分固定工作流与智能体,依据的也是这一点。
| 任务 | 优先考虑 |
|---|---|
| 把表单中的人数写入表格 | 字段明确的常规集成 |
| 从自由文本提取日期并生成草稿 | 包含模型调用和字段校验的固定工作流 |
| 跨多个来源调查特殊需求并判断是否需要追问 | 范围受限、能够选择查询步骤的智能体 |
比较时,把优化后的表单、回复模板和简单集成也放进来。如果只和完全手工操作相比,可能会漏掉成本更低的方案。
先看员工怎么做,再确定试点范围
请实际处理业务的员工带你看几条近期咨询,逐步说明从收到消息到准备回复的过程。重点记录哪些地方要复制信息、作出判断,或者补充缺失资料。这样更容易确定系统需要承担的具体任务。
- 任务反复发生,能收集到案例,也能观察时间变化。
- 有明确、有效的依据,访问范围可以限制在任务所需内容。
- 员工能区分正确答案和看似合理的答案,而且不必把整件事重做一遍。
- 在发送消息、付款或修改记录之前,草稿还来得及纠正。
- 有人接收结果、处理异常,失败案例不会被搁置在无人管理的队列里。
如果五份资料里的价格互相矛盾,先解决版本问题。没有记录说明哪一份经过批准,再强的模型也无法知道负责人的决定。整理出一份可信资料,可能就是试点准备阶段最有用的收获。
示例:为课程咨询准备回复草稿
我们沿用上一篇建站指南中的虚构陶艺工作室 Forma。下面只是一个设想中的流程:智能体并未上线,也没有用客户的业务数据验证过效果。
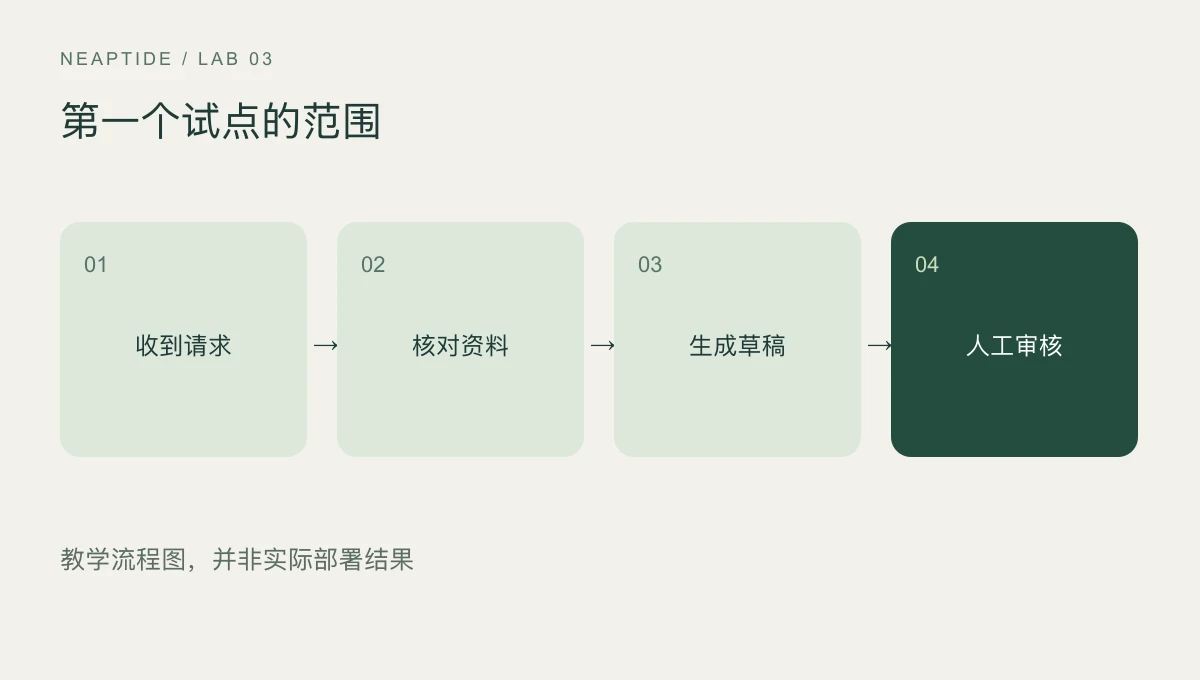
系统提取客户需求,核对已确认的服务条件,再准备带来源依据的草稿。没有日期,就提出补充问题。课程表只能说明有哪些课程,不能证明还有余位;余位需要另一个及时更新的数据来源。
| 输入 | 预期结果 | 错误行为 |
|---|---|---|
| 六个人参加,没有日期 | 询问日期 | 自行编造日期 |
| 两个价格冲突,无法确认有效版本 | 向负责人报告冲突 | 无依据地选择一个价格 |
| 人数超过允许上限 | 标记为需要人工处理的例外 | 承诺所有人都能参加 |
| 资料来源不可用 | 说明哪些信息未能核实 | 猜测服务条件 |
初期只给必要的读取权限,并把草稿放在单独位置。如果以后增加发送功能,审批应对应明确的收件人和最终正文。故障后重试不能在员工不知情的情况下重复发信。
接触客户之前,怎样验证试点?
- 先测量现有流程,包括修改时间。把实际人工操作与等待客户回复的时间分开。
- 收集常见案例和异常案例,提前写下预期结果、可接受的追问和禁止执行的动作。
- 部分案例用于调整指令,另一部分留作评估,不要只测试刚刚用来调试的案例。
- 在不向客户发消息的条件下运行,记录系统版本、输出和审核耗时。
- 统计所有尝试,包括失败后由人工完成的工作。
- 据此决定扩大范围、缩小任务、修复数据来源,或者停止项目。
一个总“准确率”会掩盖错误的差别。称呼不自然是一回事,编造价格是另一回事。应分别记录条件错误、遗漏追问和越权动作。对于少见但后果严重的错误,要补充针对性测试。小样本里没出现,不代表它很少发生。
测试前先约定什么结果才值得继续:所有草稿经过审核,未确认的价格不能发给客户,平均人工耗时下降,需要人工处理的异常也在团队承受范围内。具体时间和修改比例应根据业务设定,没有适用于所有试点的通过率或案例数量。
真实研究说明什么,如何测量自己的结果
Generative AI at Work 研究了5,172名客服人员,报告使用 AI 助手后每小时解决的问题数平均提高15%。它测量的是特定工作流程,不是代理自主程度,也不是所有项目的回本水平。
| 来源 | 样本 | 实测结果 |
|---|---|---|
| Generative AI at Work | 5,172名客服人员 | 每小时解决问题数平均增加15% |
| METR,2025年初 | 16名开发者,246项任务 | 使用 AI 的完成时间增加19% |
- Generative AI at Work — authors / Stanford
- METR — randomized study, 2025
- METR — limitations of the follow-up, 2026
METR 将真实任务随机分配到允许或不允许使用 AI 的条件中。参与者是熟悉仓库的资深开发者,使用2025年初的工具。2026年2月24日的更新指出,新样本存在参与者选择偏差,无法可靠估计当前加速幅度。
不能把客服与开发研究取平均,也不能直接套用到自己的工作室。它们说明应测量完成的工作,但不能提供你的审核时间、人工单价或项目预算。
释放工时 = 任务量 ×(原分钟数 − 新分钟数)/ 60。
时间净估值 = 工时 × 你的时薪估值 − 经常性费用。
回本期 = 一次性费用 / 正的月度收益。| 输入 | 证据 |
|---|---|
| 任务量及前后耗时 | 真实任务日志,包括失败 |
| 小时成本 | 企业认可的内部估值 |
| API 与维护 | 账单与实际工作记录 |
| 一次性投入 | 报价或实施记录 |
计算器仍是教学工具,默认数值并非实测。请填入自己的数据。只有明确减少了哪些支出,或团队能完成哪些额外工作,才能讨论释放工时的经济价值。
和开发人员沟通前,准备一页说明
写清负责人、输入、可信来源、预期输出、资料缺失时的处理方式,以及禁止执行的动作。附上匿名化案例、当前耗时和验证假设的预算上限。这样讨论的就是具体业务,而不是笼统的“数字员工”。
更换模型、修改指令或更新数据来源后,应重新运行预留的评估案例,继续记录人工修改时间。首个试点的用处,是让你有依据判断下一步值不值得投入。如果结果显示改进表单和回复模板就够了,那就选这个更简单的方案。