Jev: как работает ИИ для быстрых решений
Neaptide · 27 сентября 2026 г. · 12 мин чтения · Обновлено: 3 октября 2026 г.
Что умеет Jev: Choice, Score и Noul, вероятности и ограничения. Разбираем System One, заявления о скорости и проверку модели на своих задачах.
В этой статье
Клиент пишет: «Не могу выгрузить каталог. CSV работает, XLSX — нет. До вечера нужно отправить файл поставщику». Программе надо понять, о чём обращение, насколько сбой мешает работе и что делать дальше. Развёрнутый ответ модели тут ни к чему. Системе хватит нескольких конкретных значений.
Jev — модель TypeSafe для таких суждений. Ей передают контекст и вопросы с заданными типами ответа, обратно приходят значения и вероятности, с которыми программа может работать напрямую. TypeSafe называет этот подход System One. Писем и кода модель не пишет, хода рассуждений не объясняет.
В анонсе от 15 сентября 2026 года компания открыла ранний доступ и сделала ставку на скорость и низкую стоимость решений. Чтобы оценить, чего Jev стоит на практике, пройдём весь путь от вопроса к модели до действия приложения.
Как Jev встраивается в программу
В запросе две части: state, то есть материал для оценки, и questions, вопросы об этом материале. Контекстом может быть сообщение, JSON-объект с полями заявки или массив с текстовыми данными. Все вопросы одного вызова видят один и тот же контекст и оцениваются независимо. Jev принимает только текст, поэтому изображения и аудио придётся заранее превратить в текст или в нужные поля.

В нашем примере можно отдельно спросить, какой отдел нужен клиенту, насколько проблема мешает работе и просит ли он связать его с сотрудником. Правило «передавать технические заявки в нужную очередь» остаётся в коде. Изменится порядок обслуживания — разработчик поправит правило, а вопросы не тронет.
У такого разложения есть и своя польза. Вопрос «что нам делать с этим клиентом?» смешивает понимание текста, приоритеты бизнеса и разрешённые действия. По узким вопросам видно, на каком шаге система ошиблась. Так советует строить работу и документация TypeSafe.
Три типа вопроса — три разных смысла ответа
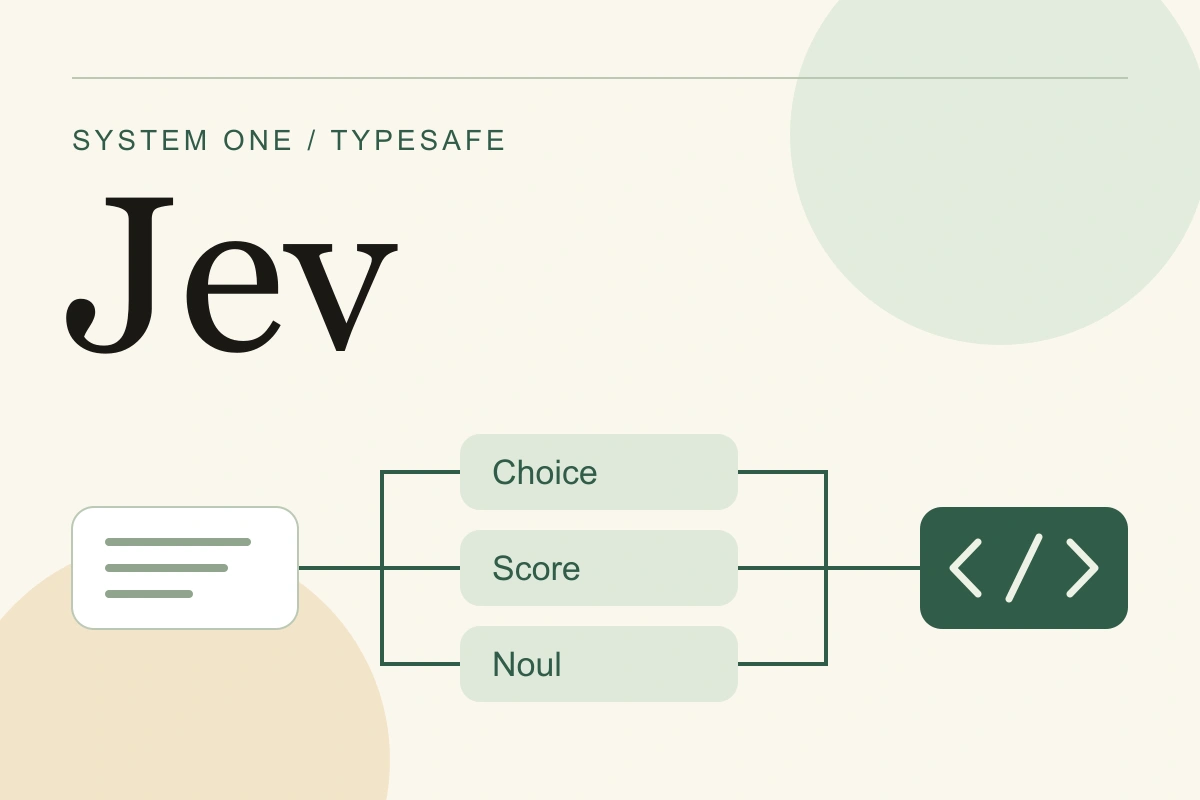
У Jev три основных типа вопросов: Choice, Score и Noul. Какой взять, зависит от того, что должна узнать программа.

Choice подходит, когда нужен один вариант из списка: например, technical, billing или other. В ответе приходят выбранный вариант, распределение вероятностей и confidence. Описания категорий пишите так, чтобы по ним можно было отличить одну от другой.
Score нужен для упорядоченной шкалы. Влияние сбоя можно описать тремя уровнями: «работе не мешает», «мешает, но есть обходной путь», «работа остановлена». Результат бывает дробным и попадает между уровнями, потому что считается как среднее их номеров с весами из распределения вероятностей. Значение 1,4 на шкале 0–2 не означает, что пострадали 70% пользователей.
Noul отвечает на один вопрос с вариантами «да» и «нет»: например, «Клиент прямо просит соединить его с сотрудником?». Число от 0 до 1 выражает вероятность «да». Около 0,5 — это неопределённость, никакой «умеренной просьбы» за таким числом нет. Отдельного поля confidence у Noul нет.
Формулировку легко проверить: поймёт ли другой сотрудник, чем отличаются варианты, если автор ничего не пояснит устно? Если нет, сначала уточните категории и уровни. Неоднозначное бизнес-правило модель за разработчика не исправит.
Что означает обещание «без галлюцинаций»
В анонсе TypeSafe объясняет отсутствие галлюцинаций ограниченным пространством ответов: модель возвращает только значения, предусмотренные структурой. Это снимает одну конкретную проблему — произвольный ответ там, где программа ждёт определённый тип.

Допустим, отделов три. Модель выбрала один из существующих, но это ещё не доказывает, что заявка попала по адресу. Гарантия формата не гарантирует, что текст понят верно. И тем более соответствие схеме не подтверждает, что бизнес-действие выполнено правильно.
Сравнивать Jev только с чат-моделью, которую попросили «вернуть JSON», тоже мало. В адаптере самой TypeSafe предусмотрены нативные режимы структурированного вывода LLM. Для проекта сравнивайте полноценные варианты интеграции: качество решения, задержку, цену и обработку сбоев.
Вероятности полезны, если программа умеет на них реагировать
Представим два ответа Choice с одним и тем же победителем, технической поддержкой. В первом ей отдана почти вся вероятность, во втором два других варианта идут почти вровень. По одному названию отдела эту разницу не увидеть.

У Choice и Score поле confidence вычисляется из формы распределения вероятностей. Читать его как «вероятность того, что этот ответ верен» нельзя. TypeSafe предлагает выбирать по этому показателю дальнейшее поведение программы, а пороги подбирать под конкретную задачу.
Калибровка — отдельная идея. Если среди большого числа сопоставимых прогнозов событию присваивается вероятность 0,8, у хорошо откалиброванной модели оно должно происходить примерно в 80% случаев. Это свойство группы прогнозов, и правильного ответа в каждом отдельном случае оно не обещает. Такие вероятности, по описанию TypeSafe, обучает метод RLCD — Reinforcement Learning for Calibrated Decisions.
Отсюда практический вывод: заранее предусмотрите путь для неоднозначных заявок. Скажем, при уверенном выборе отдела заявка уходит по маршруту автоматически, а при размазанных вероятностях попадает в общую очередь разбора. Порог зависит от цены ошибочного маршрута и от результатов проверки на ваших сообщениях.
Как читать обещания скорости и стоимости
Опубликованные цифры годятся для первой прикидки, только природа у них разная. Цена в документации — это тариф. Время ответа получено в определённых условиях. Преимущество на тестовом наборе показывает сравнение с выбранными альтернативами.
| Показатель | Что опубликовано | Как это использовать |
|---|---|---|
| Время ответа | В анонсе указан диапазон 70–500 мс; замеры обычно выполнялись с западного побережья США, где находился сервис | Измерить задержку из региона своего приложения, включая медленные ответы |
| Цена Jev 1.13 | $0,042 за миллион входных токенов; выходные токены бесплатны | Рассчитать стоимость всего входа: контекста и вопросов |
| Качество workflow | Четыре сценария: инциденты безопасности, наблюдение за агентом, обработка счетов и поддержка клиентов | Изучить методику и проверить собственные сценарии |
Источники: условия замеров в анонсе, модели и тариф, Workflow evals. Проверено 3 октября 2026 года.
В Workflow evals эталон строится по усреднённым ответам GPT-6 Astra и Claude Fable 5.1 с высоким уровнем reasoning; остальные участники работают с настройками провайдера по умолчанию. Значит, результат показывает согласие с выбранным модельным эталоном в заданном процессе. Это не то же самое, что точность по независимо размеченным реальным исходам.
Чтобы почувствовать масштаб цены, возьмём учебный расчёт: миллион вызовов по тысяче входных токенов — это миллиард токенов, или $42 по опубликованному тарифу. В тысячу токенов должны уместиться и контекст, и вопросы. Повторные вызовы, другие модели, инфраструктура и ручная проверка в расчёт не входят.
При выборе полезнее считать, во сколько обходится одна корректно обработанная заявка. От дешёвого вызова мало толку, если заметную часть обращений потом исправляет человек.
Где Jev помогает, а где понадобится другой инструмент
Естественная область применения — повторяющиеся решения над текстом: определить тему обращения, оценить соответствие описанию, выбрать категорию. Что дальше, зависит от того, как система должна распорядиться результатом.

При сбое экспорта Jev может оценить содержание жалобы. Проверить доступность сервиса, рассчитать срок по SLA и сменить статус заявки — обычные операции программы. Письмо клиенту можно собрать из шаблона или поручить генеративной модели, передав ей подтверждённые сведения и выбранное действие.
Такое разделение согласуется с ограничениями Jev 1.13, которые описывает сама TypeSafe. Модель ненадёжна в точном счёте и сравнении дат, а лишние сведения в длинном контексте ухудшают ответы. Специально составленный текст способен повлиять на классификацию. Разработчик советует оставлять вычисления в коде, убирать нерелевантный контекст и проверять сложные случаи.
Для русскоязычного проекта нужен отдельный набор примеров на русском. В документации английский назван основным языком обучения, на нём точность сейчас лучше всего; на других языках качество может отличаться. Для пилота это существенно, если в заявках встречаются сокращения, опечатки и профессиональный жаргон.
С чего начать проверку в своём продукте
Выберите одно частое решение с понятным правильным результатом, например распределение обращений по отделам. Текущий способ обработки сохраните как базу сравнения. Для пилота разметьте реальные обезличенные примеры, включая неоднозначные, и отделите материалы для настройки от набора для окончательной проверки.

Смотрите на две величины сразу: какую долю заявок система обрабатывает автоматически и как часто она ошибается именно в этой доле. При пороге, который почти всё отправляет человеку, точность выходит красивой, а автоматизации почти нет. Более мягкий порог оценивайте с учётом стоимости исправлений.
Добавьте задержку p95 (время, в которое укладываются 95% измеренных запросов), расходы на модель и объём ручной работы. Сравните Jev с вашим текущим процессом и подходящей LLM на одних и тех же примерах. В адаптере TypeSafe есть режимы возврата вероятностей и отдельных решений, так что условия сравнения выбирайте по реальным потребностям приложения.
Сохраняйте версию модели, вопросы и пороги вместе с результатами. Имя jev-latest может переключиться на новую версию, поэтому документация рекомендует закреплять конкретный идентификатор, когда поведение уже настроено под него.
Инженерная идея Jev понятна: сделать смысловое суждение небольшим наблюдаемым шагом программы. Проверять её стоит там, где таких шагов много и команда может точно сказать, что считать ошибкой. Тогда пилот покажет, какие решения можно автоматизировать и сколько неопределённости остаётся за пределами автоматизации.
Материал подготовлен по открытым первичным источникам, проверенным 3 октября 2026 года. Примеры и схемы созданы для объяснения. Собственных замеров Jev и вызовов API мы не делали.