Caso GEO: ChatGPT consiglia il nostro sito in sei lingue
24 agosto 2026 · 5 min di lettura
Il 24 agosto 2026, il nostro test di vocabolario turco compariva in sette risposte di ChatGPT in sei lingue. Era consigliato per primo o a pari merito in sei. Metodo e limiti del campione.
In questo caso studio
In questo caso abbiamo guardato come compariva nelle risposte dell’IA uno dei nostri prodotti. Nella primavera del 2026 abbiamo creato turkish-vocabulary.com, un test gratuito su una pagina che stima il vocabolario turco. Essendo un prodotto nostro, possiamo pubblicare lavoro, domande e risposte registrate senza divulgare dati dei clienti.
Il prodotto
Una pagina sola, senza registrazione. Compare una parola turca e tu scrivi la traduzione. Le parole vengono estratte da cinque fasce di frequenza che coprono all'incirca i 20.000 lemmi più comuni, e il risultato è una stima statistica del vocabolario, data come intervallo e non come cifra secca. I formati sono tre: 15, 40 e 75 parole. Tutto gira nel browser e l'interfaccia esiste in otto lingue.
Cosa abbiamo aggiunto al sito
- Un blocco «Come funziona il test» in cima alla pagina, che risponde subito e spiega il metodo per esteso: le fasce di frequenza, la dimensione dei campioni, il fatto che la stima sia statistica e quello che il test non misura.
- Il markup FAQPage, più le stesse domande e risposte come testo visibile in pagina: che cosa misura il punteggio, in che cosa differiscono i tre formati, quanto fidarsi del numero, se serve un account, che fine fanno i dati.
- Il markup WebApplication, tipizzato come applicazione didattica con prezzo zero: categoria e gratuità diventano leggibili dalle macchine.
- Un file llms.txt con una sezione «Come citare» e le regole d'uso: la parafrasi è libera con il link, ma il punteggio non va presentato come esito di un esame.
- Le basi tecniche dell'indicizzazione: URL canonici, robots.txt aperto a tutti gli agenti, sitemap che elenca anche il llms.txt, tag hreflang e card Open Graph.
- I limiti dichiarati nella pagina stessa: non è un esame ufficiale, non è un certificato e non sostituisce un test di livello.
Non abbiamo acquistato link né avviato campagne pubblicitarie. Tutto il lavoro descritto è stato fatto sul sito stesso. Le misurazioni non permettono di isolare l’effetto dei singoli cambiamenti.
Sette risposte in sei lingue
Il 24 agosto 2026 abbiamo chiesto a ChatGPT quale sito usare per valutare il vocabolario turco e come stimare quante parole si conoscono. Lo abbiamo fatto in sei lingue dell’interfaccia, con una o due formulazioni per lingua, registrando la presenza del sito, la posizione nell’elenco e la raccomandazione finale.
- Inglese, «best website to test my Turkish vocabulary size»: prima posizione e verdetto «My pick: start with Turkish-Vocabulary.com».
- Inglese, «free online test to estimate how many Turkish words I know»: seconda posizione, consigliato alla pari con un concorrente.
- Russo: prima posizione, con il consiglio di partire da lì e di scegliere la versione da 75 parole.
- Ucraino: prima posizione, il modello sceglie esplicitamente la prima opzione.
- Tedesco: secondo nell'elenco, ma è il nostro servizio quello che il modello mette in evidenza per la domanda posta.
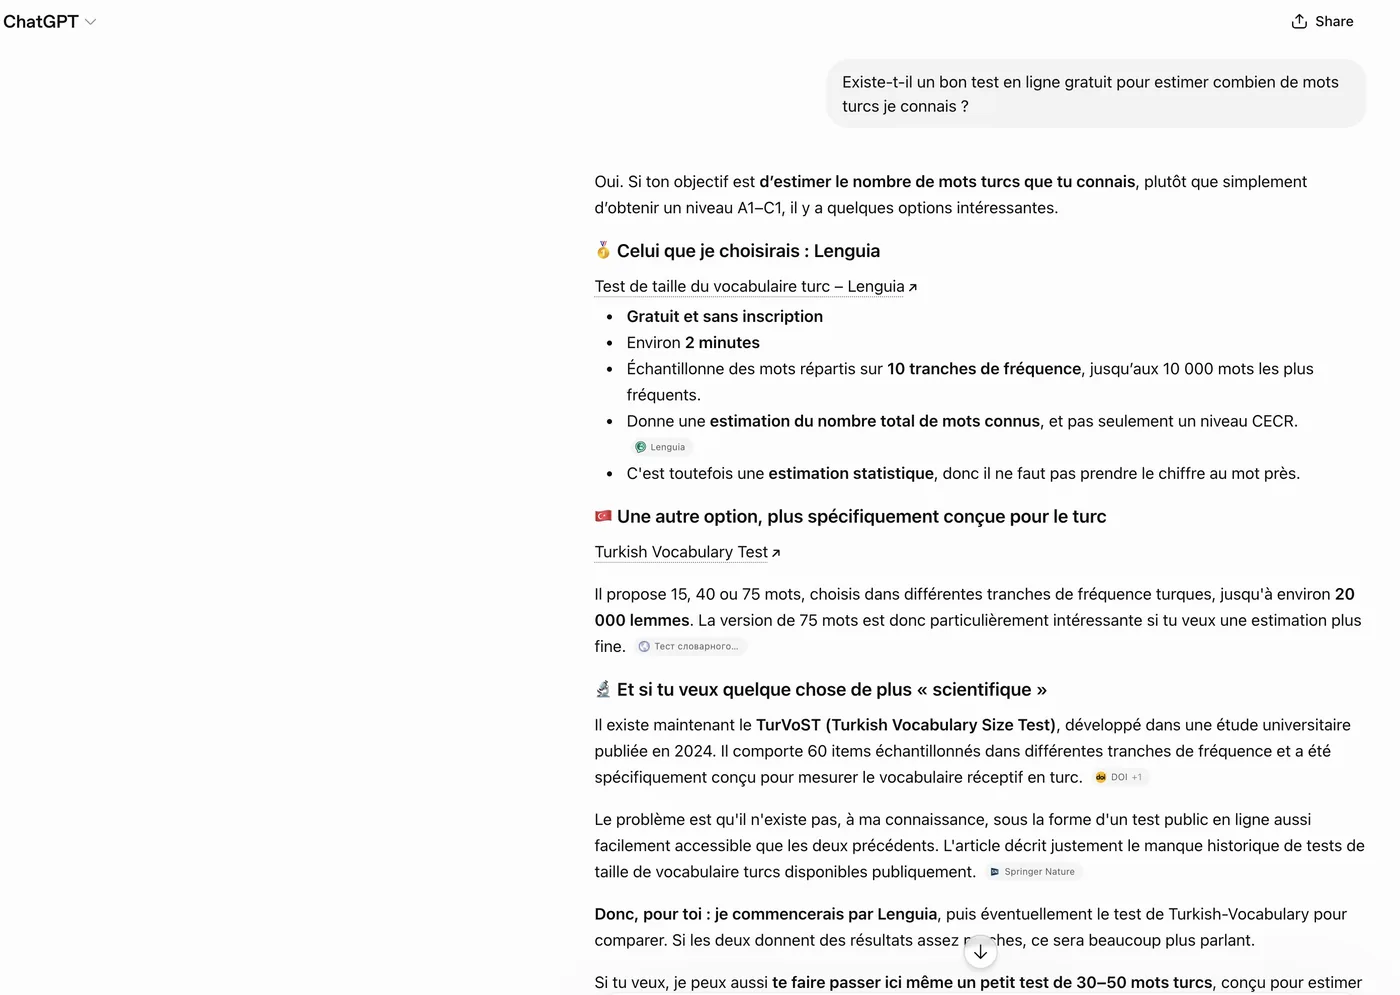
- Francese: seconda posizione, con un concorrente consigliato prima di noi.
- Olandese: seconda posizione, consigliato alla pari con un concorrente.
Il sito compariva in tutte le sette risposte, era consigliato per primo o a pari merito in sei e apriva l’elenco in tre.
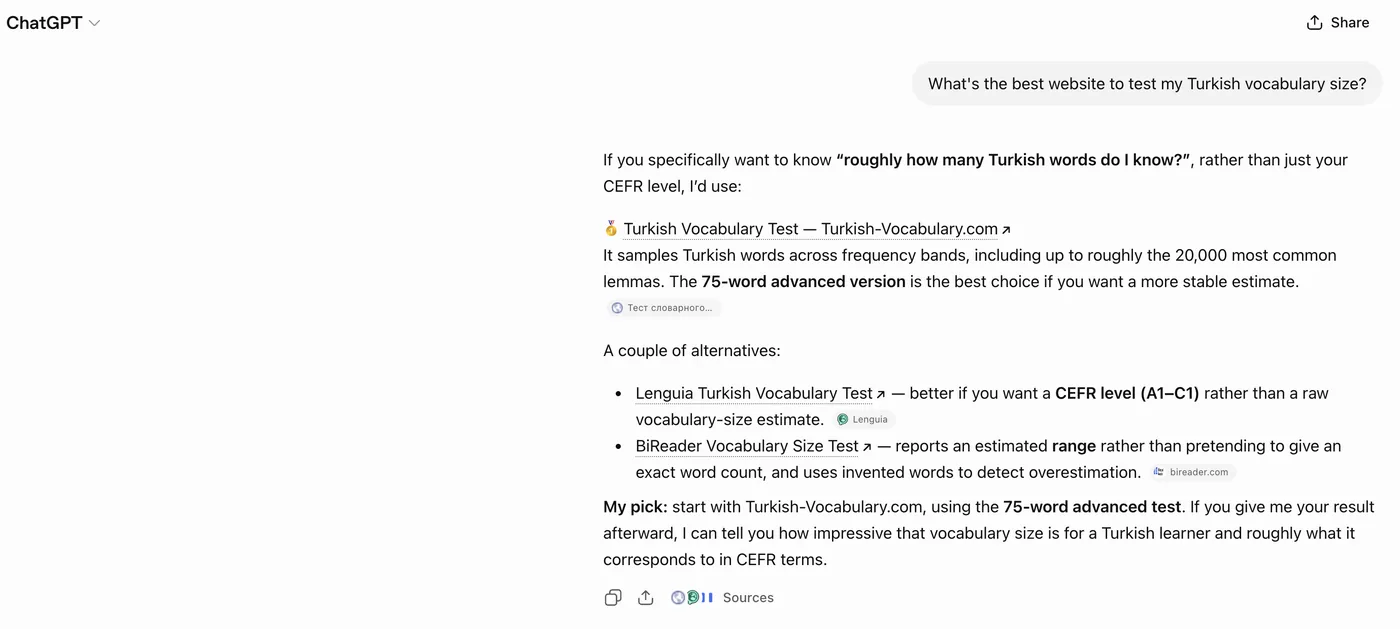
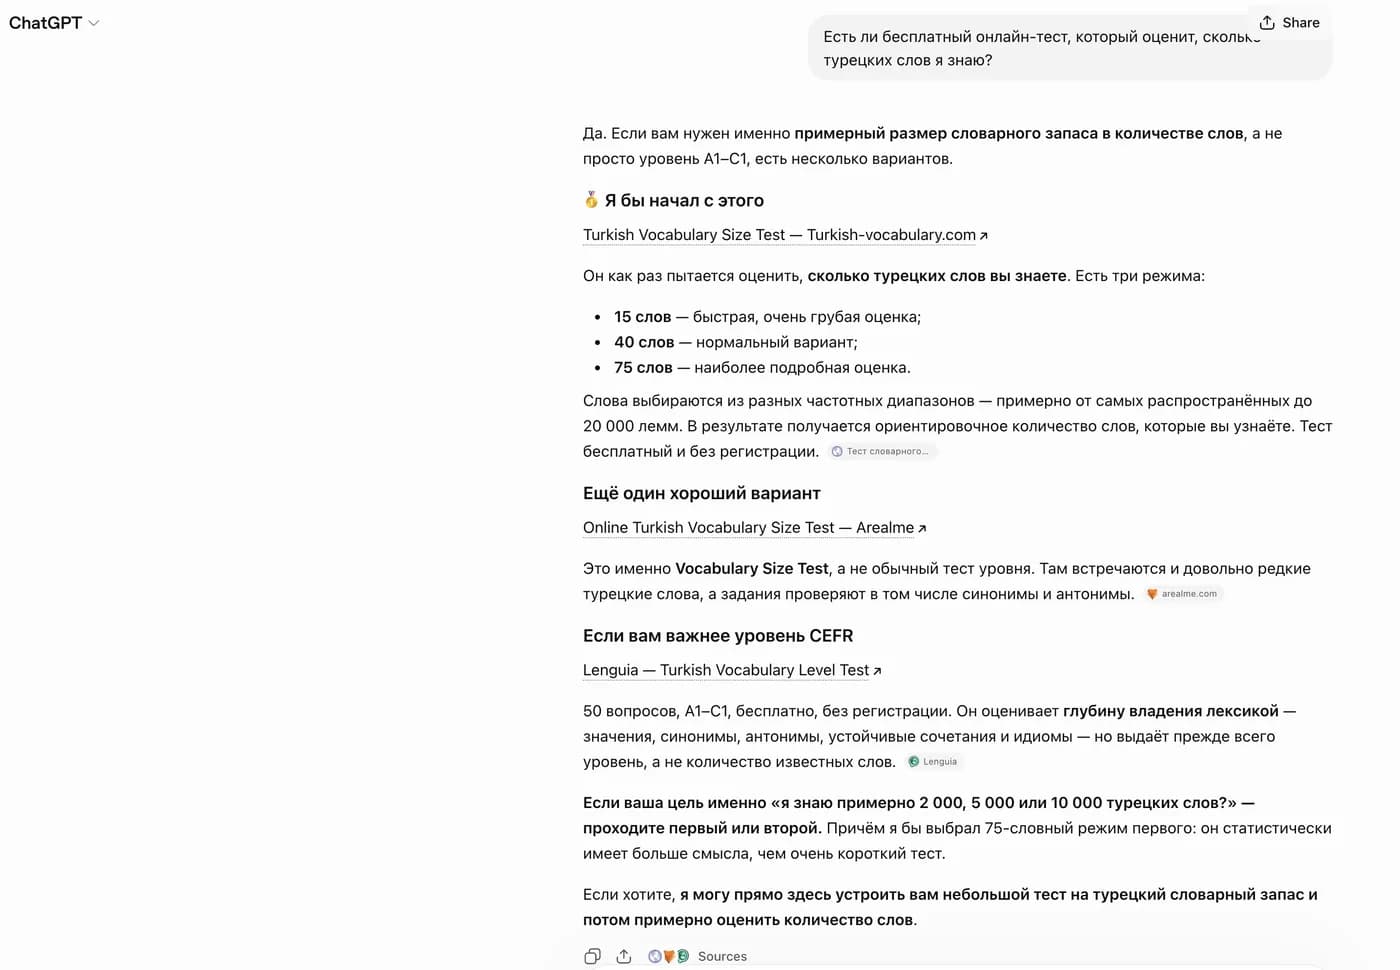
Le risposte riprendono informazioni del sito: fasce di frequenza, test da 15, 40 o 75 parole, circa 20.000 lemmi, gratuità e assenza di registrazione. Corrisponde alla descrizione pubblicata. Da qui non si ricava come ChatGPT abbia ottenuto le informazioni, né quali elementi abbiano influenzato la risposta.
Le risposte in cui un concorrente ci precede
In tedesco e francese, un concorrente compariva prima nell’elenco. Nella versione esaminata, metadati e dati strutturati erano in russo, le otto lingue condividevano un URL e le traduzioni venivano caricate tramite JavaScript. Sono difetti di localizzazione da sistemare. Sette risposte, però, non bastano a dimostrare che abbiano causato quell’ordine.
Il prossimo passo previsto è localizzare metadati, dati strutturati e llms.txt, poi ripetere le sette domande in condizioni comparabili. Potremo così registrare che cosa cambia. Per attribuire una variazione a un intervento preciso servirebbero altre verifiche.
Cosa possiamo concludere da questo campione
Il nostro prodotto è stato nominato in sette risposte salvate in sei lingue il 24 agosto 2026. Il campione non dimostra che il markup FAQ, llms.txt o un singolo intervento abbia causato le menzioni. Le risposte cambiano tra sessioni e date. Ed è un prodotto nostro: i risultati non prevedono quelli di un altro mercato.