Quanta memoria serve per un modello linguistico locale: RAM, VRAM e contesto
Neaptide · 20 settembre 2026 · 10 min di lettura · Aggiornato: 4 ottobre 2026
Stima la memoria di un modello linguistico locale: pesi, quantizzazione, cache KV, RAM e VRAM, con formule e metodo di misura.
In questo articolo
Il file del modello occupa 4 GB, il computer ha 8 GB di memoria libera, eppure non parte. I pesi sono solo l’inizio del calcolo. Considera a parte cache KV, buffer di lavoro e altre applicazioni, poi prova il tuo compito con il motore che userai davvero.
Definisci prima modello e quantizzazione, lunghezza del contesto richiesta e numero di richieste simultanee. Senza questi dati la domanda su quanta RAM serve resta troppo generica per avere una risposta.
Che cosa occupa memoria
| Componente | Da che cosa dipende |
|---|---|
| Pesi del modello | Numero di parametri e formato |
| Cache KV | Architettura, contesto, precisione e numero di sequenze |
| Buffer di lavoro | Motore e parametri di avvio |
| Altre applicazioni | Sistema, editor, browser e processi in background |
La cache KV conserva dati intermedi dell’attenzione per evitare di ricalcolarli tutti a ogni token generato. Il modo in cui è gestita influisce sul consumo di memoria.
In pratica, lo stesso modello può richiedere molta più memoria con un contesto lungo che con uno breve.
Non coprire le parti sconosciute con un ipotetico «20% per tutto il resto». Misura la memoria prima del caricamento, dopo il caricamento e durante una richiesta con il contesto necessario. Questi tre punti mostrano dove cresce il consumo, anche se non lo attribuiscono con precisione a ogni buffer interno del motore.

Stimare la memoria dei pesi
Una prima approssimazione:
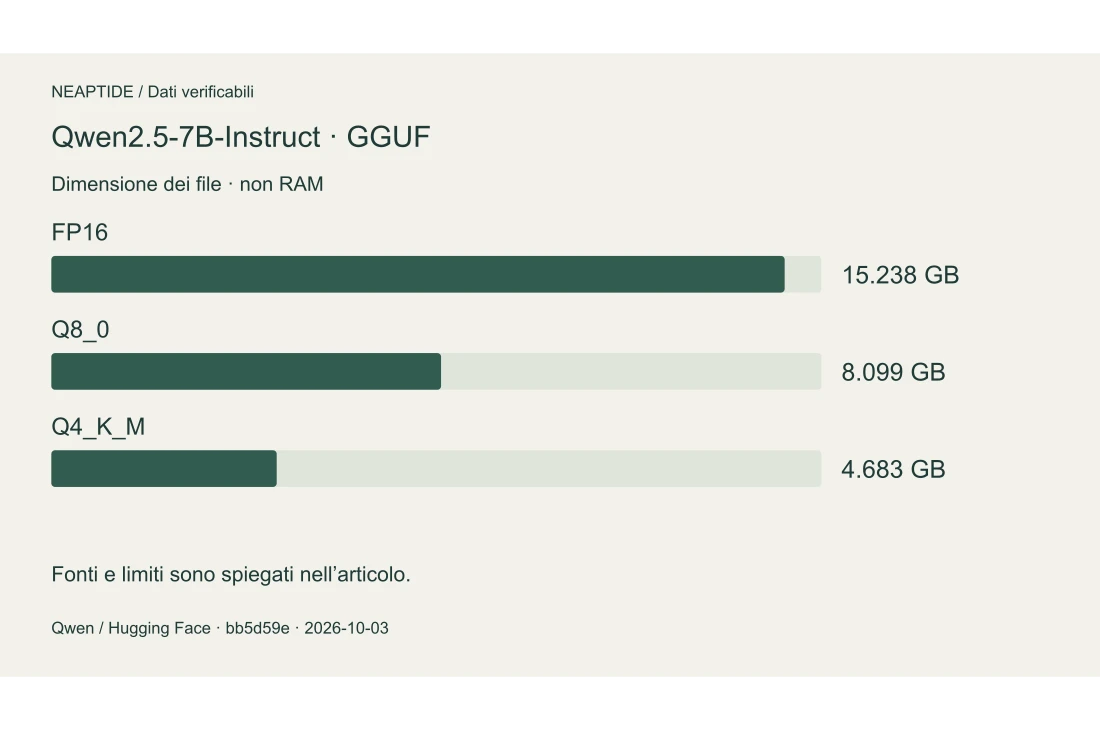
byte dei pesi ≈ numero di parametri × bit per parametro / 8Prendiamo i file reali Qwen2.5-7B-Instruct-GGUF dal repository ufficiale Qwen. Il 3 ottobre 2026 abbiamo ottenuto le dimensioni dall’API Hugging Face e sommato tutte le parti per formato, alla revisione bb5d59e06d9551d752d08b292a50eb208b07ab1f. Non abbiamo scaricato i pesi o eseguito il modello.
| Formato | Parti | Byte totali | GB |
|---|---|---|---|
| FP16 | 4 | 15 237 853 536 | 15.238 |
| Q8_0 | 3 | 8 098 525 408 | 8.099 |
| Q4_K_M | 2 | 4 683 073 632 | 4.683 |
Q4_K_M non significa esattamente quattro bit per parametro. Queste dimensioni includono metadati, impacchettamento e tensori con precisioni diverse. Q4_K_M occupa 4,683 GB anziché i 3,5 GB della formula semplificata per sette miliardi di parametri.
Dividi i byte per 1.073.741.824 per i GiB, o per un miliardo per i GB. La dimensione dei file non è il consumo di RAM o VRAM: servono anche cache KV, buffer e memoria per altri programmi.
FP16, Q8_0 e Q4_K_M appartengono allo stesso modello e revisione. Le parti descrivono il download, non modelli diversi: servono tutte quelle del formato scelto.
Differenza tra RAM e VRAM
La RAM è la memoria di sistema; la VRAM è quella della GPU dedicata. Dove finisce il modello dipende da hardware e motore. Nei sistemi con memoria unificata, CPU e GPU condividono una risorsa che serve anche al sistema operativo.
Non puoi sommare 16 GB di RAM e 8 GB di VRAM e considerarli l’equivalente di una scheda video da 24 GB. La suddivisione del lavoro e il costo dei trasferimenti dipendono dalla configurazione.
In Ollama, ollama ps mostra come il modello caricato è distribuito tra CPU e GPU.
L'effetto del contesto
Per una normale cache KV completa, la stima è:
byte della cache ≈ 2 × livelli × teste KV × dimensione della testa
                   × token × byte per elemento × sequenze
Il fattore 2 rappresenta chiavi e valori. È una semplificazione valida per le architetture a cui si applica, non un calcolatore universale. Attenzione scorrevole, compressione e altre implementazioni cambiano il calcolo.
Per questo confronta le configurazioni con lo stesso contesto impostato. Se una riceve una funzione breve e l’altra un intero repository, la differenza di memoria da sola dice poco.
Ollama permette di cambiare la lunghezza del contesto; aumentarla richiede più memoria. Controlla distribuzione e contesto con ollama ps.
Consideriamo un’architettura didattica: 32 strati, 8 teste KV, dimensione della testa 128 e 2 byte per elemento di cache. La cache completa di una sequenza di 4096 token richiede 0,5 GiB; con 16.384 token ne servono 2. Quattro sequenze di questa lunghezza arrivano a 8 GiB di cache. Nel calcolatore qui sotto i pesi sono condivisi, mentre la cache cresce con contesto e concorrenza.

Come il contesto cambia la memoria
Modello didattico: 7B, pesi a 4 bit; cache KV completa: 32 strati, 8 teste KV, dimensione 128, 2 byte per elemento. Tutte le sequenze condividono i pesi.
- Pesi grezzi
- 3,26 GiB
- Cache KV
- 0,5 GiB
- Pesi + cache
- 3,76 GiB
Esclusi sistema, buffer del motore e metadati di quantizzazione. Non è una previsione del consumo totale di RAM o VRAM. Altre architetture richiedono un calcolo diverso.
Cambia contesto o concorrenza: la dimensione dei pesi resta invariata.
Verificare il proprio computer
Annota modello, tag esatto, quantizzazione, motore e versione. Esegui lo stesso compito con un input breve e uno più lungo. Registra:
- Contesto configurato e richieste simultanee.
- Memoria occupata prima e durante l'esecuzione.
- Distribuzione CPU/GPU.
- Tempo alla prima risposta e durata totale.
- Qualità rispetto a condizioni definite in anticipo.
Ripeti la prova per distinguere il caricamento dal funzionamento a regime. Se la memoria finisce, riduci prima un solo parametro. Non cambiare tutto insieme.
Che cosa provare con 16 o 32 GB
Non esiste un elenco di configurazioni garantite che valga per qualsiasi hardware. Con poca memoria, parti da un piccolo modello quantizzato e da un compito breve, come nella guida Ollama. Lascia margine al sistema e alle applicazioni.
Scegli in base al tuo carico di lavoro: contesto sufficiente, risposta abbastanza rapida e nessun esaurimento della memoria nelle prove ripetute. Salva il tag del modello e i parametri misurati. Così l’acquisto di memoria o di una GPU risponderà a un limite osservato, non alla dimensione del file.
Fonti e verifica
Fonti tecniche e calcoli verificati il 3 ottobre 2026. Scenari e schemi sono esempi didattici di Neaptide; non sono stati eseguiti benchmark comparativi dei prodotti.