Étude de cas GEO : ChatGPT recommande notre site en six langues
24 août 2026 · 5 min de lecture
Le 24 août 2026, notre test de vocabulaire turc figurait dans sept réponses de ChatGPT en six langues. Il était recommandé en premier ou à égalité dans six réponses. Méthode et limites de l’échantillon.
Dans cette étude de cas
Pour ce cas, nous avons regardé comment l’un de nos propres produits apparaît dans les réponses des IA. Au printemps 2026, nous avons créé turkish-vocabulary.com, un test gratuit sur une page qui estime le vocabulaire turc. Comme le produit est à nous, nous pouvons publier le travail, les questions et les résultats enregistrés sans divulguer de données clients.
Le produit
Une page, sans inscription. Un mot turc s'affiche, vous saisissez la traduction. Les mots sont tirés de cinq bandes de fréquence qui couvrent environ les 20 000 lemmes les plus courants, et le résultat est une estimation statistique du vocabulaire, donnée sous forme de fourchette plutôt que de chiffre unique. Trois formats : 15, 40 ou 75 mots. Tout tourne dans le navigateur et l'interface existe en huit langues.
Les ajouts au site
- Un bloc « Comment fonctionne le test » placé en tête de page, qui répond d'entrée et expose la méthode : les bandes de fréquence, la taille des échantillons, le caractère statistique de l'estimation et ce que le test ne mesure pas.
- Un balisage FAQPage, doublé de la même FAQ en texte visible sur la page : ce que mesure le score, ce qui distingue les trois formats, la confiance à lui accorder, la nécessité ou non d'un compte, le sort des données.
- Un balisage WebApplication, typé application éducative au prix de zéro : la catégorie et la gratuité deviennent lisibles par la machine.
- Un fichier llms.txt avec une section « Comment citer » et des règles d'usage : la reprise est libre avec un lien, mais le score ne doit pas être présenté comme un résultat d'examen.
- Les bases techniques de l'indexation : URL canoniques, robots.txt ouvert à tous les agents, sitemap qui référence aussi le llms.txt, balises hreflang et cartes Open Graph.
- Les limites annoncées sur la page elle-même : ce n'est ni un examen officiel, ni un certificat, ni un substitut à un test de niveau.
Nous n’avons acheté aucun lien et n’avons pas lancé de campagne publicitaire. Tout le travail décrit a été fait sur le site lui-même. Les mesures ne permettent pas d’isoler l’effet de chaque changement.
Sept réponses dans six langues
Le 24 août 2026, nous avons posé à ChatGPT des questions comme « meilleur site pour tester mon vocabulaire turc » ou « combien de mots turcs est-ce que je connais », dans six langues de l’interface, avec une ou deux formulations par langue. Nous avons enregistré la présence du site, sa place dans la liste et la recommandation finale.
- Anglais, « best website to test my Turkish vocabulary size » : première place, verdict « My pick: start with Turkish-Vocabulary.com ».
- Anglais, « free online test to estimate how many Turkish words I know » : deuxième place, recommandé à égalité avec un concurrent.
- Russe : première place, avec le conseil de commencer par là et de prendre la version de 75 mots.
- Ukrainien : première place, le modèle retient explicitement la première option.
- Allemand : deuxième dans la liste, mais c'est notre service que le modèle met en avant pour la question posée.
- Français : deuxième place, un concurrent est recommandé avant nous.
- Néerlandais : deuxième place, recommandé à égalité avec un concurrent.
Le site figurait dans les sept réponses, était recommandé en premier ou à égalité dans six, et apparaissait en tête de liste dans trois.
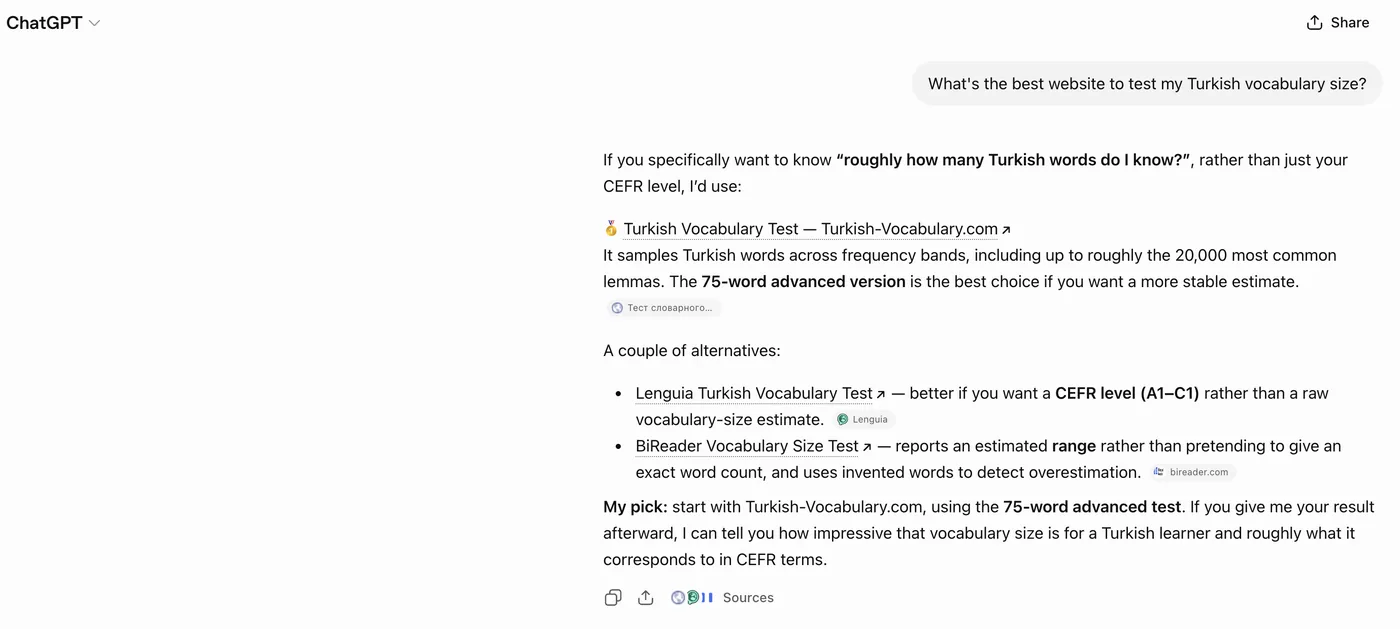
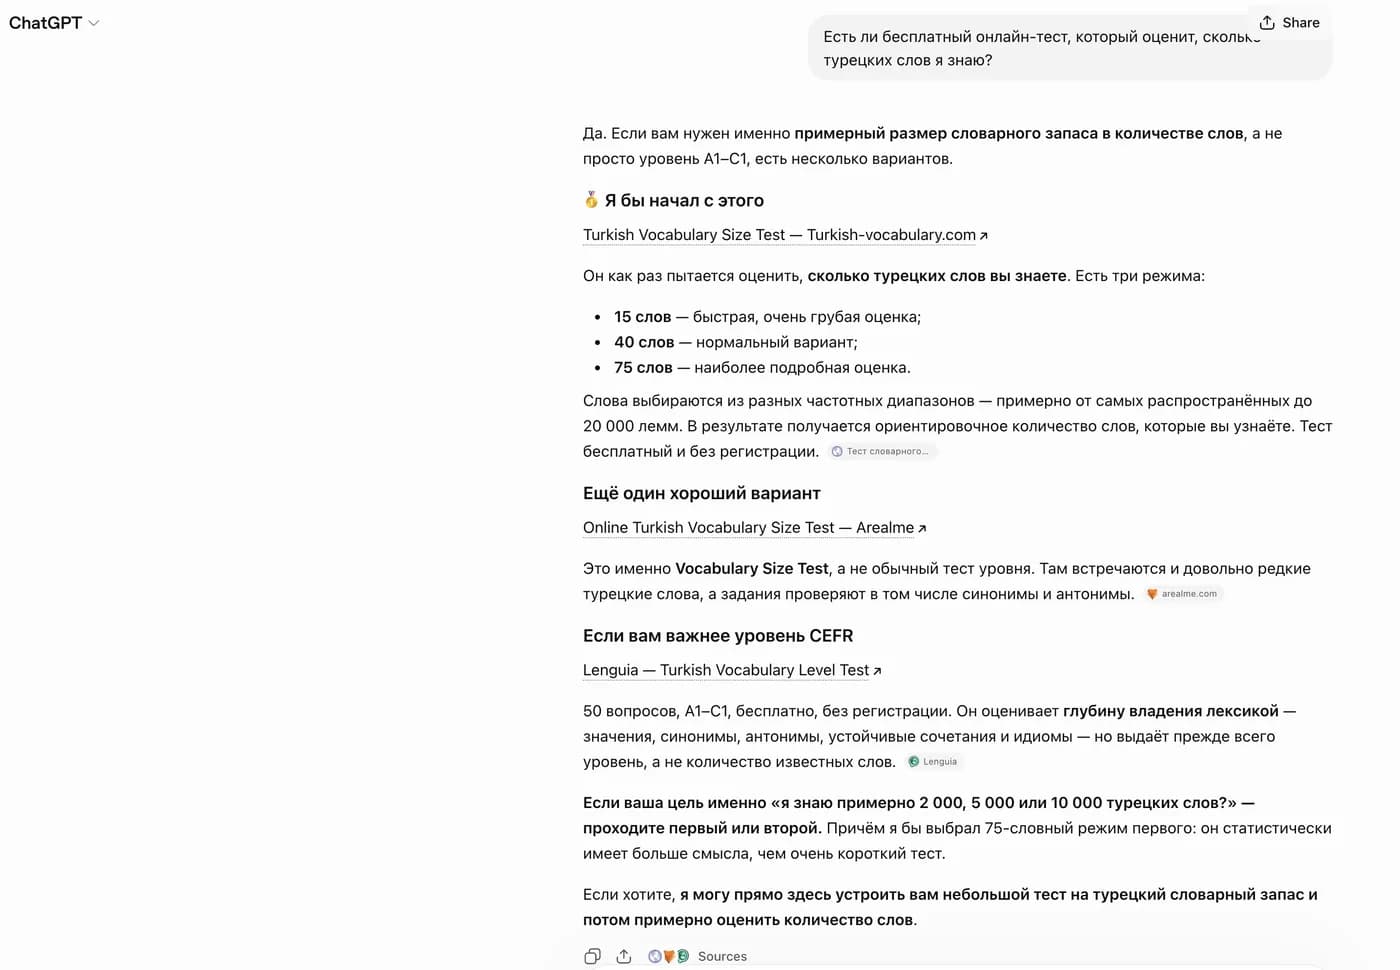
Les réponses reprennent des informations du site : bandes de fréquence, formats de 15, 40 ou 75 mots, environ 20 000 lemmes, gratuité et absence d’inscription. Cela correspond à la description publiée. On ne peut pas en déduire comment ChatGPT a obtenu ces informations, ni quels éléments ont influencé sa réponse.
Les réponses où un concurrent nous précède
En allemand et en français, un concurrent apparaît avant nous dans la liste. Dans la version examinée, les métadonnées et les données structurées étaient en russe, les huit langues partageaient une URL et les traductions étaient chargées par JavaScript. Ces défauts de localisation sont à corriger. Sept réponses ne suffisent pourtant pas à prouver qu’ils expliquent l’ordre des recommandations.
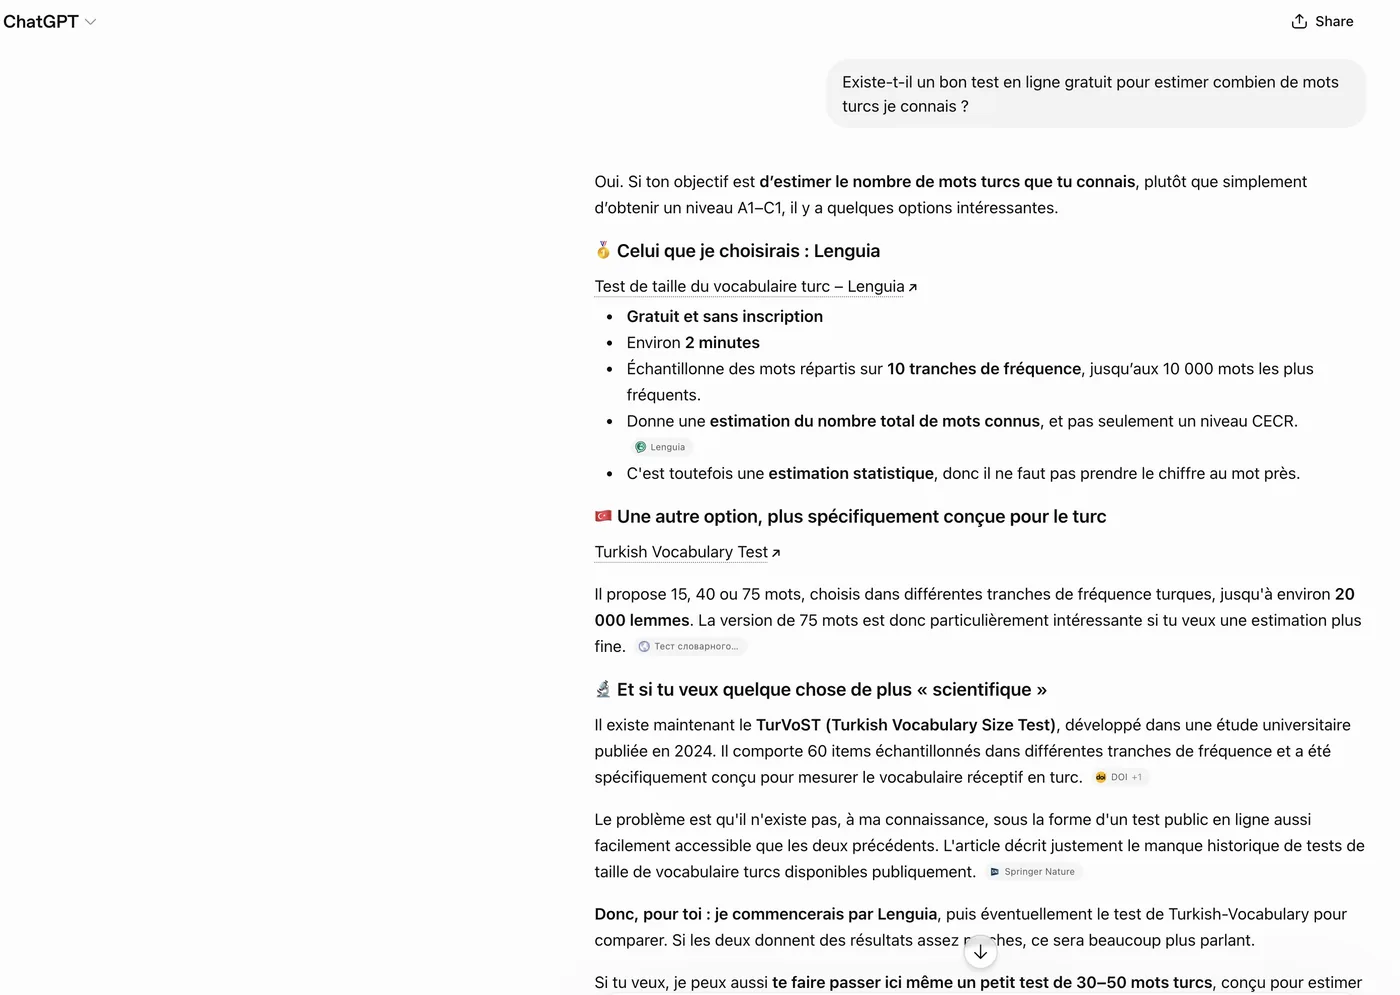
Prochaine étape prévue : traduire les métadonnées, les données structurées et llms.txt, puis reposer les sept questions dans des conditions comparables. Nous pourrons alors relever ce qui change. Il faudrait d’autres vérifications pour attribuer une évolution à une modification précise.
Ce que cet échantillon permet de conclure
Notre produit a été nommé dans sept réponses enregistrées en six langues le 24 août 2026. Cet échantillon ne prouve pas que le balisage FAQ, llms.txt ou une modification particulière a provoqué ces mentions. Les réponses varient selon la session et la date. Et c’est notre propre produit : ces résultats ne prédisent pas ceux d’un autre marché.