Agent IA en entreprise : quel processus automatiser en premier ?
Neaptide · 6 septembre 2026 · 9 min de lecture · Mis à jour: 4 octobre 2026
Choisir un premier cas d’usage, tester les erreurs et estimer la valeur après vérification humaine. Schémas, calculateur et journal de suivi à télécharger.
Dans cet article
Pour un premier pilote d’agent IA, choisissez une tâche récurrente, des données accessibles et un résultat qu’une personne sait vérifier. Limitez le périmètre à la collecte d’informations ou à la préparation d’un brouillon, puis mesurez le travail humain restant. La rapidité du modèle ne suffit pas à démontrer l’intérêt du projet.
Prenons une personne qui traite les demandes d’inscription à des ateliers. Certains messages précisent la date et le nombre de participants, d’autres disent seulement « nous aimerions venir en équipe ». Copier des champs est simple. Repérer ce qui manque et préparer la bonne question demande davantage de jugement, et c’est ce travail-là qui fait un bon premier périmètre.
Agent, scénario prédéfini ou simple intégration ?
Un agent IA s’appuie sur un modèle pour choisir ses prochaines étapes et utiliser des outils. Les définitions varient : précisez donc si le système doit suivre un parcours fixé à l’avance ou décider quelles recherches mener. Anthropic distingue ainsi les processus prédéfinis des agents qui dirigent leur propre progression.
| Besoin | Solution à examiner |
|---|---|
| Copier le nombre de participants d’un formulaire | Une intégration classique |
| Extraire une date d’un texte et préparer un brouillon | Un scénario fixe avec appel au modèle et validation |
| Examiner une demande inhabituelle dans plusieurs sources | Un agent au périmètre limité, capable de choisir ses recherches |
Comparez le pilote à une solution simple, par exemple un formulaire mieux conçu, un modèle de réponse et une intégration. Si vous ne le comparez qu’au travail entièrement manuel, une option moins coûteuse peut vous échapper.
Observer le travail avant de choisir le cas d’usage
Reprenez quelques demandes récentes avec la personne qui les traite. Repérez les étapes où elle copie des informations, prend une décision ou constate qu’un renseignement manque. Ce travail à partir de cas réels donne des exigences plus précises que « automatiser les ventes ».
- La tâche revient assez souvent pour réunir des exemples et observer une différence.
- Il existe une source à jour qui fait autorité, et l’accès peut être limité à ce que la tâche exige.
- Quelqu’un sait reconnaître une réponse correcte sans refaire tout le travail.
- Un brouillon erroné peut être corrigé avant un envoi, un paiement ou une modification.
- Une personne désignée valide les résultats et traite les exceptions.
Si plusieurs documents affichent des prix contradictoires, commencez par les mettre en ordre. Le modèle ne peut pas deviner lequel a été approuvé. Un référentiel fiable peut être le premier bénéfice de cette préparation.
Exemple : préparer une réponse pour un atelier
Forma est l’atelier de céramique fictif de notre précédent guide. Nous décrivons ici un processus possible. Aucun agent n’a été déployé et aucun résultat ne vient d’un client.
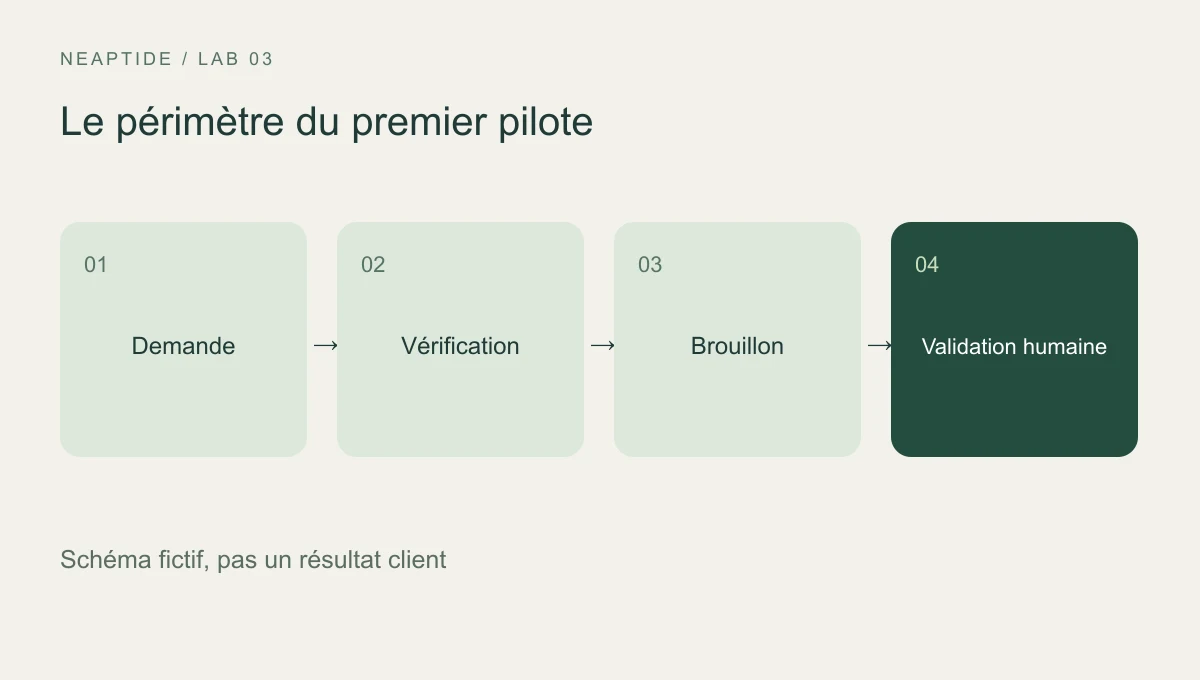
Le système extrait les informations de la demande, consulte les conditions approuvées et prépare un brouillon avec ses sources. Si la date manque, il rédige une question pour la demander. Un calendrier de cours ne prouve pas qu’il reste des places : cette disponibilité doit être vérifiée dans une autre source tenue à jour.
| Entrée | Résultat attendu | Erreur |
|---|---|---|
| Six personnes, aucune date | Demander la date | En inventer une |
| Deux prix contradictoires | Signaler le conflit au responsable | Choisir un prix sans justification |
| Groupe dépassant la limite | Transmettre la demande au responsable pour décision | Promettre une place à tous |
| Source inaccessible | Indiquer ce qui reste à vérifier | Deviner les conditions |
Commencez par des droits de lecture et un espace de brouillons. Si vous autorisez ensuite l’envoi, la validation doit porter sur le destinataire et le texte exacts. Une reprise après incident ne doit pas expédier un doublon à l’insu du responsable.
Évaluer le pilote avant de solliciter les clients
- Mesurez le processus actuel, corrections comprises. Séparez le temps de travail de l’attente d’une réponse client.
- Rassemblez cas courants et exceptions, avec les résultats attendus et les actions interdites.
- Gardez des cas à part pour l’évaluation, au lieu de tester uniquement ceux qui ont servi à améliorer les instructions.
- Exécutez sans envoyer de messages. Notez la version du système, le résultat et le temps de vérification.
- Comptez toutes les tentatives, y compris les échecs terminés manuellement.
- Décidez : élargir, réduire le périmètre, corriger les données ou arrêter.
Un taux global de précision met sur le même plan une formule maladroite et un prix inventé. Suivez séparément les conditions erronées, les questions oubliées et les actions non autorisées. Ajoutez des tests ciblés pour les erreurs rares mais graves. Ne pas les voir dans un petit échantillon ne prouve pas qu’elles sont improbables.
Fixez avant le test ce qui justifierait de continuer : tous les brouillons sont relus, aucun prix non confirmé n’arrive au client, le temps humain diminue et l’équipe parvient à traiter les exceptions. Les seuils chiffrés dépendent de votre activité. Il n’existe ni taux de réussite ni taille d’échantillon valables pour tous.
Ce que montrent les études, et comment mesurer votre résultat
Generative AI at Work étudie 5 172 agents de support et rapporte une hausse moyenne de 15 % des problèmes résolus par heure avec l’assistance IA. Cela mesure un processus précis, pas l’autonomie d’un agent ni la rentabilité de tout déploiement.
| Source | Échantillon | Résultat mesuré |
|---|---|---|
| Generative AI at Work | 5 172 agents de support | Problèmes résolus par heure : +15 % en moyenne |
| METR, début 2025 | 16 développeurs, 246 tâches | Temps de réalisation avec IA : +19 % |
- Generative AI at Work — authors / Stanford
- METR — randomized study, 2025
- METR — limitations of the follow-up, 2026
METR a réparti aléatoirement les tâches avec ou sans IA. Les développeurs expérimentés travaillaient sur des dépôts familiers avec les outils de début 2025. Dans sa mise à jour du 24 février 2026, METR signale des biais de sélection qui empêchent d’estimer solidement l’accélération actuelle.
Ne faites pas la moyenne de ces résultats et ne les transposez pas à votre atelier. Ils montrent l’intérêt de mesurer le travail terminé. Ils ne donnent ni votre temps de vérification, ni votre coût horaire, ni votre budget.
Heures libérées = volume × (minutes avant − minutes après) / 60.
Valorisation nette = heures × votre tarif − frais récurrents.
Délai de retour = coût initial / bénéfice mensuel positif.| Donnée | Justificatif |
|---|---|
| Volume et minutes avant/après | Journal réel, échecs compris |
| Coût horaire | Valorisation interne convenue |
| API et maintenance | Factures et temps consignés |
| Coût initial | Devis ou suivi du déploiement |
Le calculateur reste pédagogique ; ses valeurs initiales ne sont pas des mesures. Saisissez vos données. Le temps libéré ne devient une économie financière que si vous identifiez des dépenses réduites ou du travail supplémentaire réalisable.
Préparer le cahier des charges pour le développeur
Préparez une page qui précise le responsable, les informations reçues, les sources approuvées et le résultat attendu. Indiquez quoi faire lorsqu’une information manque et quelles actions sont interdites. Ajoutez des exemples sans données identifiantes, les durées actuelles et un budget maximal pour l’essai.
Rejouez les cas de contrôle après tout changement de modèle, d’instructions ou de sources. Continuez à mesurer les reprises manuelles. Le pilote doit permettre une décision argumentée, y compris celle de retenir un formulaire et des modèles de réponse plus simples.