Caso GEO: ChatGPT recomienda nuestro sitio en seis idiomas
24 de agosto de 2026 · 5 min de lectura
El 24 de agosto de 2026, nuestro test de vocabulario turco apareció en siete respuestas de ChatGPT en seis idiomas. Fue recomendado primero o junto a otra opción en seis. Método y límites de la muestra.
En este caso de estudio
En este caso miramos cómo aparecía uno de nuestros propios productos en las respuestas de IA. En la primavera de 2026 creamos turkish-vocabulary.com, un test gratuito de una página que estima el vocabulario turco. Al ser un producto propio, podemos publicar el trabajo, las preguntas y las respuestas registradas sin divulgar datos de clientes.
El producto
Una página, sin registro. Aparece una palabra en turco y escribes la traducción. Las palabras salen de cinco bandas de frecuencia que cubren alrededor de los 20.000 lemas más habituales, y el resultado es una estimación estadística del vocabulario, expresada como un rango y no como una cifra exacta. Hay tres formatos: 15, 40 y 75 palabras. Todo funciona en el navegador y la interfaz está en ocho idiomas.
Qué añadimos al sitio
- Un bloque «Cómo funciona el test» al principio de la página, que responde de entrada y explica el método sin rodeos: las bandas de frecuencia, el tamaño de las muestras, el carácter estadístico de la estimación y lo que el test no mide.
- Marcado FAQPage y esas mismas preguntas y respuestas como texto visible en la página: qué mide la cifra, en qué se diferencian los tres formatos, cuánto conviene fiarse del número, si hace falta cuenta y qué pasa con los datos.
- Marcado WebApplication, tipado como aplicación educativa con precio cero: la categoría y la gratuidad quedan legibles para las máquinas.
- Un archivo llms.txt con una sección «Cómo citar» y reglas de uso: se puede parafrasear con enlace, pero la cifra no debe presentarse como resultado de un examen.
- Base técnica de la indexación: URL canónicas, robots.txt abierto a todos los agentes, sitemap que incluye también el propio llms.txt, etiquetas hreflang y tarjetas de Open Graph.
- Los límites, dichos en la propia página: no es un examen oficial, no es un certificado y no sustituye a una prueba de nivel.
No compramos enlaces ni lanzamos campañas publicitarias. Todo el trabajo descrito se hizo en el propio sitio. Las mediciones no permiten aislar el efecto de cada cambio.
Siete respuestas en seis idiomas
El 24 de agosto de 2026 preguntamos a ChatGPT por el mejor sitio para medir el vocabulario turco y por cómo estimar cuántas palabras conoce una persona. Lo hicimos en seis idiomas de la interfaz, con una o dos formulaciones por idioma, y registramos si aparecía el sitio, su posición en la lista y la recomendación final.
- Inglés, «best website to test my Turkish vocabulary size»: primera posición y veredicto «My pick: start with Turkish-Vocabulary.com».
- Inglés, «free online test to estimate how many Turkish words I know»: segunda posición, recomendado a la par que un competidor.
- Ruso: primera posición, con el consejo de empezar por ahí y elegir la versión de 75 palabras.
- Ucraniano: primera posición, el modelo se queda expresamente con la primera opción.
- Alemán: segundo en la lista, pero es nuestro servicio el que el modelo destaca para lo que el usuario preguntaba.
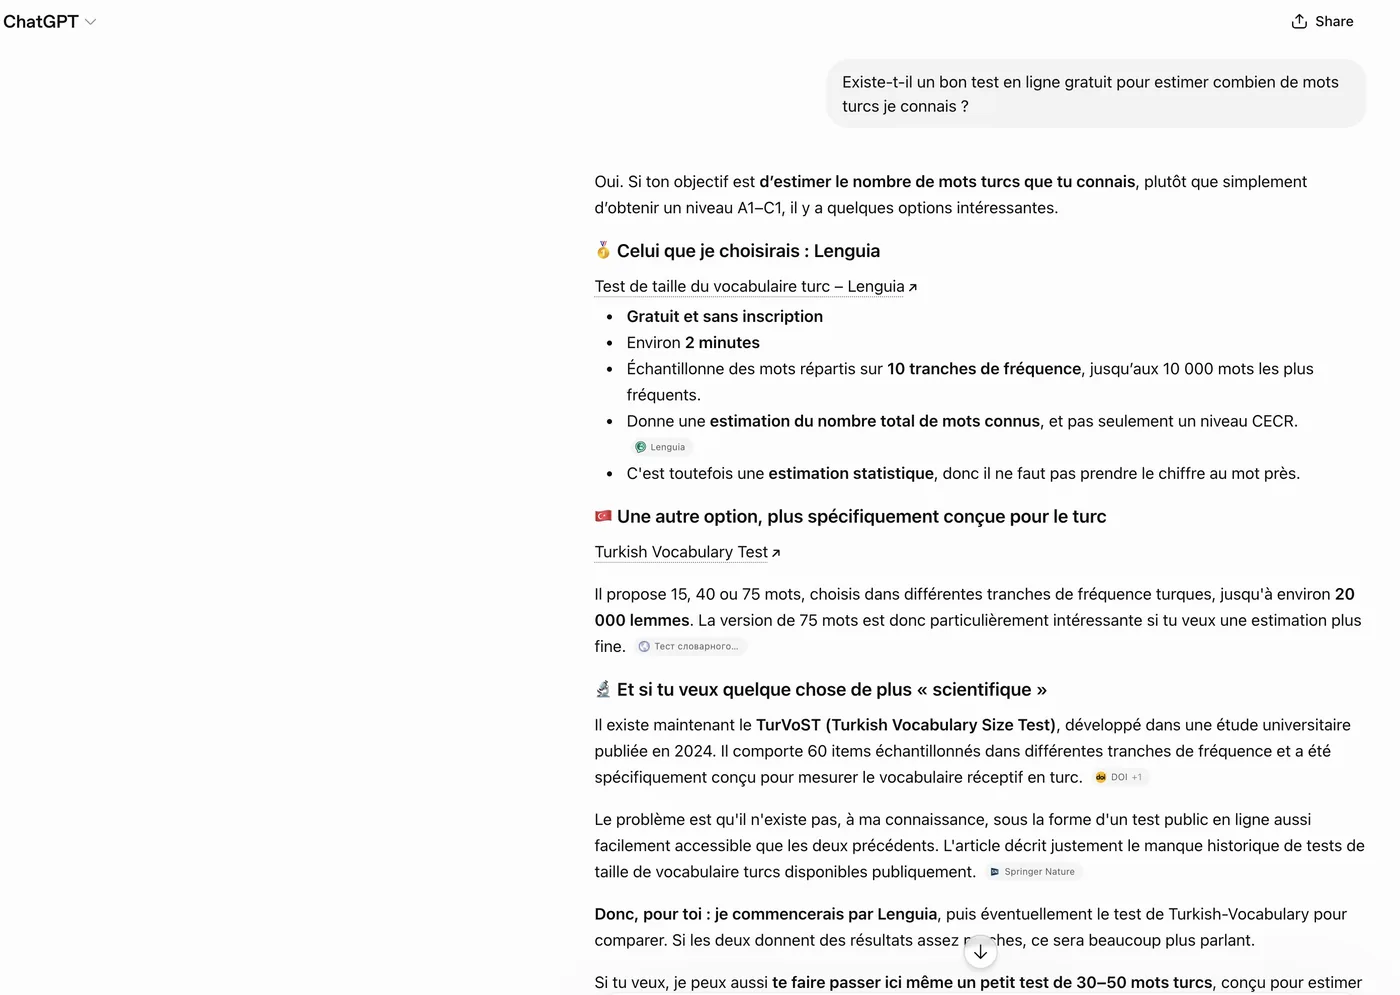
- Francés: segunda posición, con un competidor recomendado por delante.
- Neerlandés: segunda posición, recomendado a la par que un competidor.
El sitio apareció en las siete respuestas, fue recomendado primero o junto a otra opción en seis y encabezó la lista en tres.
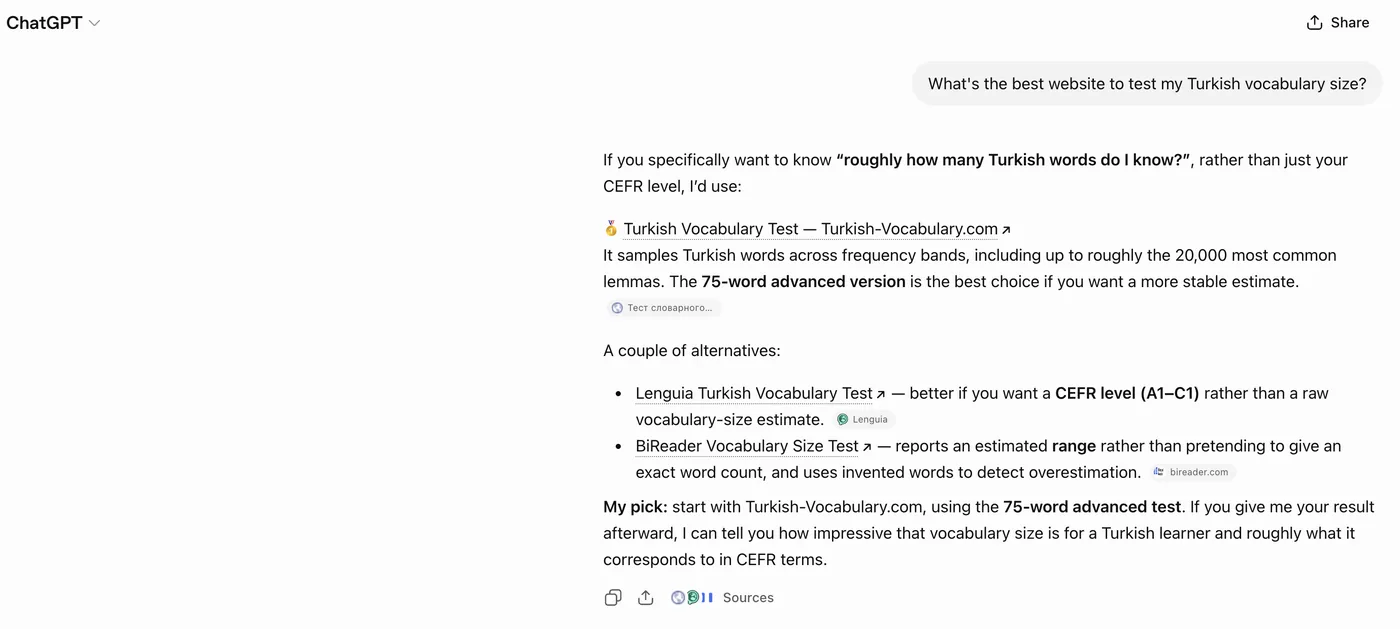
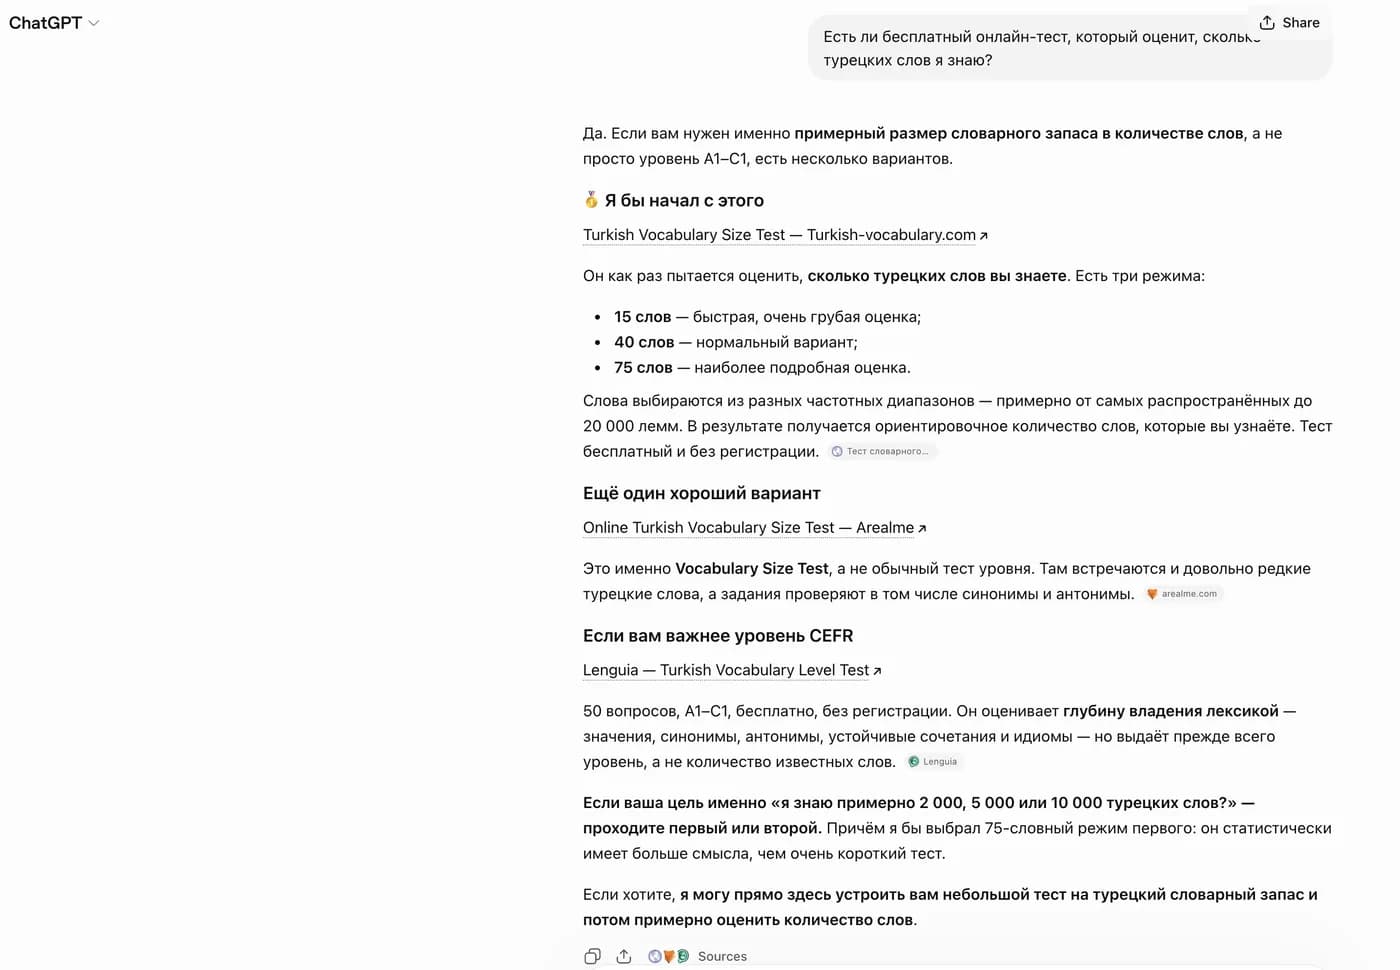
Las respuestas repiten datos del sitio: bandas de frecuencia, pruebas de 15, 40 o 75 palabras, unos 20 000 lemas, gratuidad y ausencia de registro. Coincide con la descripción publicada. De ahí no se deduce cómo obtuvo ChatGPT la información ni qué elementos influyeron en la respuesta.
Respuestas en las que un competidor aparece antes
En alemán y francés, un competidor apareció antes en la lista. En la versión revisada, los metadatos y los datos estructurados estaban en ruso, los ocho idiomas compartían una URL y las traducciones se cargaban mediante JavaScript. Son fallos de localización que conviene corregir. Aun así, siete respuestas no bastan para demostrar que causaran ese orden.
El siguiente paso previsto es localizar los metadatos, los datos estructurados y llms.txt, y repetir las siete preguntas en condiciones comparables. Así podremos registrar qué cambia. Para atribuir una variación a una modificación concreta harían falta más comprobaciones.
Qué permite concluir esta muestra
Nuestro producto fue mencionado en siete respuestas guardadas en seis idiomas el 24 de agosto de 2026. La muestra no demuestra que el marcado FAQ, llms.txt o un cambio concreto provocaran las menciones. Las respuestas varían entre sesiones y fechas. Y es un producto propio: los resultados no predicen los de otro mercado.