Cuánta memoria necesita un modelo de lenguaje local: RAM, VRAM y contexto
Neaptide · 20 de septiembre de 2026 · 10 min de lectura · Actualizado: 4 de octubre de 2026
Calcula la memoria de un modelo de lenguaje local: pesos, cuantización, caché KV, RAM y VRAM, con fórmulas y un método de medición.
En este artículo
El archivo del modelo ocupa 4 GB, el equipo tiene 8 GB de memoria libre y aun así no arranca. Los pesos son solo el comienzo del cálculo. Cuenta por separado la caché KV, los búferes de trabajo y las demás aplicaciones, y después prueba tu tarea con el motor que vayas a usar.
Define primero el modelo y su cuantización, la longitud de contexto necesaria y el número de peticiones simultáneas. Sin esos datos, la pregunta de cuánta RAM necesita una IA es demasiado general para tener respuesta.
Qué ocupa memoria
| Componente | De qué depende |
|---|---|
| Pesos del modelo | Número de parámetros y formato |
| Caché KV | Arquitectura, contexto, precisión y número de secuencias |
| Búferes de trabajo | Motor y parámetros de ejecución |
| Otras aplicaciones | Sistema, editor, navegador y procesos en segundo plano |
La caché KV conserva datos intermedios de atención para no recalcularlos por completo con cada token generado. La forma de gestionarla afecta al uso de memoria.
En la práctica, el mismo modelo puede necesitar bastante más memoria con un contexto largo que con uno corto.
No rellenes las partes desconocidas con un supuesto «20 % para todo lo demás». Mide la memoria antes de cargar, después de cargar y durante una petición con el contexto necesario. Así verás dónde aumenta el consumo, aunque no puedas atribuirlo con precisión a cada búfer interno.

Estimar la memoria de los pesos
Como primera aproximación:
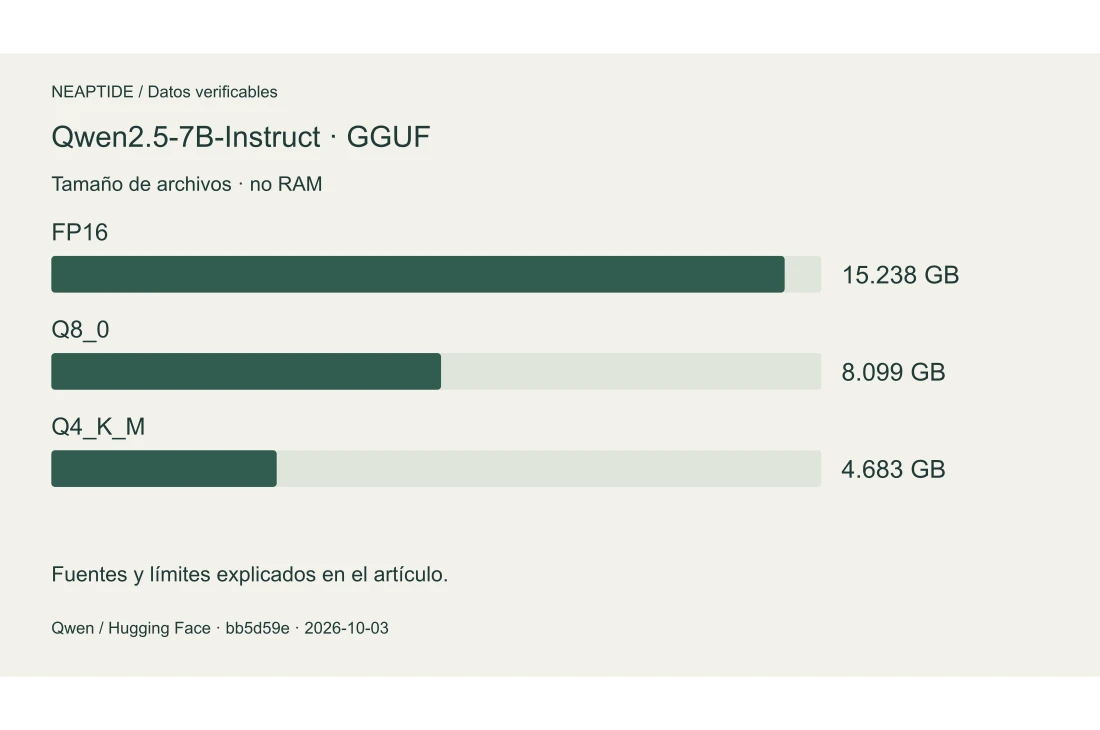
bytes de pesos ≈ número de parámetros × bits por parámetro / 8Tomemos los archivos reales de Qwen2.5-7B-Instruct-GGUF del repositorio oficial Qwen. El 3 de octubre de 2026 obtuvimos sus tamaños mediante la API de Hugging Face y sumamos todas las partes por formato, en la revisión bb5d59e06d9551d752d08b292a50eb208b07ab1f. No descargamos los pesos ni ejecutamos el modelo.
| Formato | Partes | Bytes totales | GB |
|---|---|---|---|
| FP16 | 4 | 15 237 853 536 | 15.238 |
| Q8_0 | 3 | 8 098 525 408 | 8.099 |
| Q4_K_M | 2 | 4 683 073 632 | 4.683 |
Q4_K_M no significa exactamente cuatro bits por parámetro. Los tamaños incluyen metadatos, empaquetado y tensores con distintas precisiones. Q4_K_M suma 4,683 GB, frente a los 3,5 GB del cálculo simplificado para siete mil millones de parámetros.
Divide los bytes entre 1.073.741.824 para GiB o mil millones para GB. El tamaño del archivo no equivale al consumo de RAM o VRAM: también hacen falta caché KV, buffers y memoria para otras aplicaciones.
FP16, Q8_0 y Q4_K_M corresponden al mismo modelo y revisión. Las partes describen la descarga, no varios modelos: necesitas todas las del formato elegido.
Diferencia entre RAM y VRAM
La RAM es la memoria del sistema; la VRAM es la de la GPU dedicada. Dónde se coloca el modelo depende del hardware y del motor. En sistemas de memoria unificada, CPU y GPU comparten un recurso que también necesita el sistema operativo.
No basta con sumar 16 GB de RAM y 8 GB de VRAM para tener el equivalente de una tarjeta de 24 GB. El reparto del trabajo y el coste de transferir datos dependen de la configuración.
En Ollama, ollama ps muestra cómo se reparte el modelo cargado entre CPU y GPU.
Cómo influye el contexto
Para una caché KV completa convencional, la aproximación es:
bytes de caché ≈ 2 × capas × cabezas KV × dimensión de cabeza
                 × tokens × bytes por elemento × secuencias
El factor 2 corresponde a claves y valores. Es una simplificación para las arquitecturas a las que se aplica, no una calculadora universal. La atención deslizante, la compresión y otras implementaciones cambian el cálculo.
Por eso, compara configuraciones con el mismo contexto configurado. Si una recibe una función corta y otra un repositorio completo, la diferencia de memoria por sí sola demuestra poco.
Ollama permite cambiar la longitud de contexto; aumentarla requiere más memoria. Comprueba el contexto y la distribución con ollama ps.
Tomemos una arquitectura didáctica: 32 capas, 8 cabezas KV, dimensión de cabeza 128 y 2 bytes por elemento de caché. La caché completa de una secuencia de 4096 tokens necesita 0,5 GiB; con 16.384 tokens, 2 GiB. Cuatro secuencias de esa longitud suman 8 GiB de caché. En la calculadora de abajo los pesos se comparten y la caché crece con el contexto y la concurrencia.

Cómo afecta el contexto a la memoria
Modelo didáctico: 7B, pesos a 4 bits; caché KV completa: 32 capas, 8 cabezas KV, dimensión 128, 2 bytes por elemento. Todas las secuencias comparten los pesos.
- Pesos brutos
- 3,26 GiB
- Caché KV
- 0,5 GiB
- Pesos + caché
- 3,76 GiB
Excluye sistema, búferes del motor y metadatos de cuantización. No predice el consumo total de RAM o VRAM. Otras arquitecturas requieren otro cálculo.
Cambia el contexto o la concurrencia: el tamaño de los pesos no varía.
Comprobar tu ordenador
Registra modelo, etiqueta exacta, cuantización, motor y versión. Ejecuta la misma tarea con una entrada corta y otra más larga. Anota:
- Contexto configurado y peticiones simultáneas.
- Memoria ocupada antes y durante la ejecución.
- Distribución entre CPU y GPU.
- Tiempo hasta la primera respuesta y duración total.
- Calidad según criterios definidos previamente.
Repite la ejecución para separar la carga del modelo del funcionamiento estable. Si falta memoria, reduce primero un solo parámetro. No lo cambies todo a la vez.
Qué probar con 16 o 32 GB
No hay una lista de configuraciones garantizadas que valga para cualquier hardware. Con poca memoria, empieza por un modelo cuantizado pequeño y una tarea corta, como en la guía de Ollama. Deja margen para el sistema y las aplicaciones.
Elige según tu carga de trabajo: contexto suficiente, tiempo de respuesta aceptable y que la memoria no se agote en ejecuciones repetidas. Guarda la etiqueta del modelo y los parámetros medidos. Así, la compra de memoria o de una GPU responderá a una limitación observada y no al tamaño del archivo.
Fuentes y verificación
Fuentes técnicas y cálculos verificados el 3 de octubre de 2026. Los escenarios y esquemas son ejemplos didácticos de Neaptide; no se realizaron pruebas comparativas de rendimiento.