Сколько памяти нужно для локальной LLM: RAM, VRAM и контекст
Neaptide · 20 сентября 2026 г. · 10 мин чтения · Обновлено: 4 октября 2026 г.
Оценка памяти локальной LLM: веса, квантование, KV-кэш, RAM и VRAM. Формулы, таблица размеров и порядок проверки компьютера.
В этой статье
Файл модели весит 4 ГБ, свободной памяти на компьютере 8 ГБ, а запуск всё равно не удаётся. Размер весов — только начало расчёта. Отдельно нужно учесть KV-кэш, рабочие буферы и память других программ, а потом проверить свою задачу на конкретном движке.
Перед выбором компьютера запишите точную модель и её квантование, нужную длину контекста и число одновременных запросов. Объяснить короткую функцию и разобрать несколько больших файлов — разные нагрузки даже для одной модели. По этим условиям можно прикинуть память, а потом проверить расчёт запуском.
Что занимает память
| Составляющая | От чего зависит |
|---|---|
| Веса модели | Число параметров и формат хранения |
| KV-кэш | Архитектура, контекст, точность кэша, число последовательностей |
| Рабочие буферы | Реализация движка и параметры запуска |
| Другие приложения | Система, редактор, браузер и фоновые процессы |
KV-кэш хранит промежуточные данные механизма внимания, чтобы не пересчитывать их целиком на каждом новом токене. От того, как кэш организован, зависит расход памяти.
На практике одна и та же модель с длинным контекстом может потребовать заметно больше памяти, чем с коротким.
Неизвестные части бюджета не стоит заменять придуманным запасом «20% на всё». Измерьте потребление до загрузки, после загрузки и во время запроса с нужным контекстом. По этим точкам видно, где растёт расход, хотя точного разложения по внутренним буферам движка они не дают.

Грубая оценка памяти весов
Для первого приближения используйте формулу:
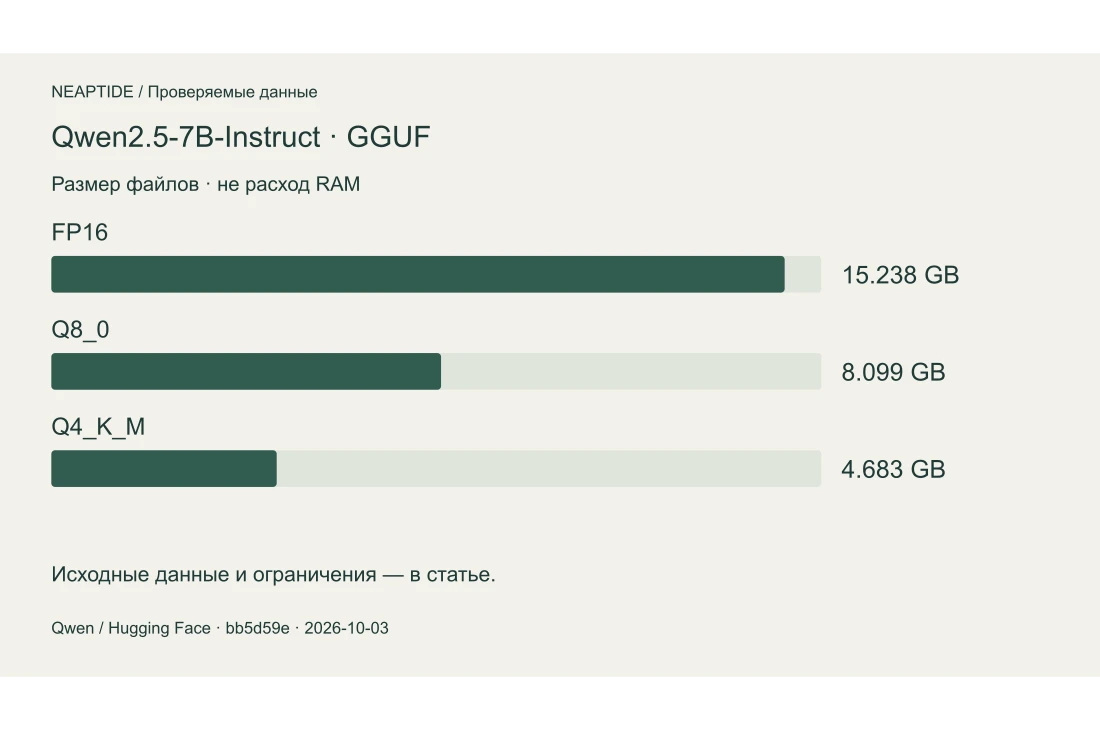
байты весов ≈ число параметров × бит на параметр / 8Возьмём конкретные файлы Qwen2.5-7B-Instruct-GGUF из официального репозитория Qwen. 3 октября 2026 года мы получили размеры через API Hugging Face и сложили все части каждого формата. Зафиксирована ревизия bb5d59e06d9551d752d08b292a50eb208b07ab1f; сами веса не скачивали и модель не запускали.
| Формат | Частей | Всего байт | GB |
|---|---|---|---|
| FP16 | 4 | 15 237 853 536 | 15.238 |
| Q8_0 | 3 | 8 098 525 408 | 8.099 |
| Q4_K_M | 2 | 4 683 073 632 | 4.683 |
Квантование Q4_K_M не означает ровно четыре бита на каждый параметр. Упаковка, метаданные и разная точность тензоров уже входят в эти размеры. Поэтому файл Q4_K_M занимает 4,683 GB, а не 3,5 GB из грубой формулы для условных 7 миллиардов параметров.
Для GiB делите байты на 1 073 741 824; для GB — на 1 000 000 000. Размер файлов не равен расходу RAM или VRAM: нужны также KV-кэш, рабочие буферы и память программ.
Размеры FP16, Q8_0 и Q4_K_M относятся к одной модели и одной ревизии. Число частей — это устройство загрузки, а не число моделей: для запуска нужны все части выбранного формата.
Чем RAM отличается от VRAM
RAM — системная память, VRAM — память дискретного графического процессора. Где окажется модель, зависит от оборудования и движка. В системах с общей памятью CPU и GPU делят один ресурс, и он же нужен операционной системе.
Нельзя просто сложить, скажем, 16 ГБ RAM и 8 ГБ VRAM и считать, что получилась видеокарта на 24 ГБ. Можно ли разделить работу и во что обойдётся передача данных, зависит от конкретной связки.
В Ollama команда ollama ps показывает размещение загруженной модели между CPU и GPU.
Как влияет контекст
Для обычного полного KV-кэша грубая оценка имеет вид:
байты кэша ≈ 2 × слои × KV-головы × размер головы
             × токены × байты элемента × последовательности
Коэффициент 2 учитывает ключи и значения. Формула описывает упрощённую модель для подходящей архитектуры, универсальным калькулятором для всех LLM она не служит. Скользящее внимание, сжатие и другие реализации меняют расчёт.
Поэтому сравнивайте две конфигурации при одинаковом заданном контексте. Если одной модели дали короткую функцию, а другой весь репозиторий, разница в потреблении памяти сама по себе ничего не доказывает.
Ollama позволяет менять длину контекста; чем она больше, тем больше нужно памяти. Текущее распределение и контекст показывает ollama ps.
Возьмём учебную архитектуру: 32 слоя, 8 KV-голов, размер головы 128 и по 2 байта на элемент кэша. При полном кэше 4096 токенов одной последовательности занимают 0,5 GiB, а 16 384 токена — 2 GiB. Четыре такие последовательности — это уже 8 GiB кэша. В калькуляторе ниже веса общие, а кэш растёт с контекстом и параллелизмом.

Как контекст меняет расход памяти
Учебная модель: 7B, веса 4 бит; полный KV-кэш: 32 слоя, 8 KV-голов, размер головы 128, элемент 2 байта. Веса общие для всех последовательностей.
- Сырые веса
- 3,26 GiB
- KV-кэш
- 0,5 GiB
- Веса + кэш
- 3,76 GiB
Не включает ОС, буферы движка и метаданные квантования. Это не прогноз полного потребления RAM или VRAM. Для другой архитектуры расчёт меняется.
Измените контекст или параллелизм: размер весов останется прежним.
Как проверить свой компьютер
Запишите модель, точный тег, квантование, движок и его версию. Затем выполните одну и ту же задачу с коротким и более длинным входом. Сохраните:
- Заданный контекст и число одновременных запросов.
- Занятую память до запуска и во время работы.
- Размещение модели на CPU/GPU.
- Время до первого ответа и общую длительность.
- Качество результата по заранее известным условиям.
Повторите запуск, чтобы отделить загрузку модели от устойчивого режима. Если память закончилась, уменьшите сначала один параметр. Менять одновременно модель, контекст и все настройки не нужно.
Что пробовать на 16 или 32 ГБ
Списка «гарантированно работает», который не зависел бы от оборудования, нет. Если памяти мало, начните с небольшой квантованной модели и короткой задачи, как в инструкции Ollama. Оставьте запас для системы и приложений.
Выбирайте конфигурацию по своему рабочему сценарию: нужный контекст, приемлемое время ответа и достаточно памяти при повторном запуске. Сохраните тег модели и параметры замера. Тогда решение о покупке памяти или видеокарты будет опираться на найденное ограничение, а не на размер файла модели.
Источники и проверка
Технические источники и расчёты проверены 3 октября 2026 года. Сценарии и схемы — учебные примеры Neaptide; сравнительные замеры продуктов не проводились.